Giới thiệu khóa học
LLM Training (Image): học cách mô hình sinh ảnh từ văn bản được huấn luyện
Mô hình sinh ảnh học cách biến nhiễu ngẫu nhiên thành ảnh phù hợp với mô tả. Khác bài toán đoán token kế tiếp của mô hình văn bản, ở đây mô hình nhận ảnh đã trộn nhiễu, mức thời gian và mô tả, rồi dự đoán một đại lượng giúp đi về ảnh sạch. Khóa này nối cặp ảnh–chú thích với một vòng học và bản lưu trọng số, gọi là checkpoint.
Khóa ở mức Intermediate. Bạn cần biết tensor là mảng nhiều chiều và attention là cách trộn thông tin từ Foundations; biết loss đo sai số, gradient chỉ hướng sửa và AdamW chọn bước cập nhật từ Training (Text). Mỗi bài nhắc lại phần cần dùng trước khi thêm khái niệm mới như latent (biểu diễn ảnh nén), flow matching (học trường vận tốc từ nhiễu tới dữ liệu) và EMA (trung bình trượt của trọng số).
Khóa học gồm
- 17 bài kiến trúc và sơ đồ 24 ô, mã
1Ađến5D: dữ liệu, bộ mã hóa cố định, đường nhiễu, denoiser (mạng dự đoán để gỡ nhiễu), loss và cập nhật. - Phân biệt ε-prediction (đoán nhiễu), v-prediction (đoán tổ hợp ảnh và nhiễu) và velocity prediction (đoán vận tốc của đường đã chọn); chúng không thể đổi tên cho nhau mà giữ nguyên sampler.
- Nhánh phương pháp gồm học nền từ độ phân giải thấp lên cao, tinh chỉnh miền, LoRA/DreamBooth để cá nhân hóa, ControlNet/adapters cho điều khiển không gian, chưng cất ít bước và Diffusion-DPO học từ cặp ảnh ưu tiên.
- Băng 5 nối checkpoint với lấy mẫu Euler, CFG (kết hợp dự đoán có/rỗng điều kiện), giải mã latent thành ảnh rồi sang khóa Qwen-Image-2.1 để học suy luận.
- Tab 02 có một lab NumPy thu nhỏ với ảnh 4×4, hai nhãn ngang/dọc, gradient viết tay, AdamW, EMA, đối chứng dropout, LoRA và sampler; mỗi phép kiểm tra có phạm vi kết luận riêng.
Học xong, bạn có thể
- Theo một batch ảnh–chú thích qua encoder cố định, tạo trạng thái nhiễu và mục tiêu vận tốc, dự đoán, chấm điểm, backward rồi cập nhật denoiser.
- Đọc đúng quy ước
t=0là nhiễu,t=1là ảnh sạch trong khóa này; kiểm tra dấu của vận tốc và bước Euler bằng hai đầu đường nội suy. - Giải thích vì sao bỏ điều kiện ngẫu nhiên khi học tạo nhánh rỗng cho CFG, và vì sao tăng hệ số CFG không bảo đảm chất lượng tăng.
- Chọn bộ phận thay đổi khi đổi phương pháp: dữ liệu, tham số được học, điều kiện phụ hay loss; phân biệt LoRA là cách chọn tham số với DreamBooth là mục tiêu cá nhân hóa.
- Đọc loss trên một tập kiểm định cố định và các phép kiểm tra số; nói rõ chúng không xác nhận thẩm mỹ, khả năng hiểu ảnh hay tốc độ GPU.
Phạm vi: khóa dạy huấn luyện mô hình SINH ẢNH từ văn bản bằng latent diffusion và flow matching, bổ sung phần huấn luyện cho khóa Qwen-Image-2.1 chỉ bao quát kiến trúc và suy luận. ViT/CLIP/VLM (các bộ mã hóa dùng để hiểu ảnh hoặc kết nối ảnh với chữ) chỉ xuất hiện như thành phần điều kiện hóa; khóa không huấn luyện sâu các encoder hiểu ảnh. Lab dùng MLP thay DiT và ánh xạ đồng nhất thay VAE; không tái tạo công thức huấn luyện riêng của Qwen-Image-2.1.
Cách đọc sơ đồ
- Bắt đầu ở
1Arồi1B: giữ cặp ảnh–chú thích sau lọc và ghép nhóm cùng tỉ lệ khung hình. Từ đó tách hai nhánh: ảnh vào1Cthành latent, chú thích vào1Dthành điều kiện chữ; không đưa latent vào text encoder. - Ở cột 2,
2Alấy thời gian và nhiễu,2Btrộn nhiễu với latent,2Cđôi lúc thay điều kiện bằng rỗng.2Dnhận trạng thái nhiễu, thời gian và điều kiện để dự đoán;2Etạo đáp án từ cặp ảnh–nhiễu gốc, không lấy dự đoán làm đáp án. 3Aso dự đoán với đáp án;3Btính gradient,3Csửa trọng số bằng AdamW,3Dcập nhật EMA và lưu checkpoint. Mũi tênnext batchquay lại dữ liệu,load weightsđi xuống băng 5.- Cột 4 là các lựa chọn gắn vào vòng học, không phải bảy bước bắt buộc nối tiếp. Băng 5 dùng trọng số cố định: nạp checkpoint → tích phân Euler và CFG → giải mã → đọc tiếp Qwen-Image-2.1.
- Di chuột hoặc dùng phím Tab lên ô để đọc Nhận gì / Làm gì, vì sao / Ra gì / Ví dụ / Lưu ý. Bấm ô mở bài; chọn Trọng tâm để soi một nhánh; nút Tắt overlay cạnh Vừa khung cho xem plate gốc. Sang Tab 02 và đối chiếu bảng xem ô nào được thực thi hay chỉ minh họa.
Tên tiếng Anh trên plate là nhãn tra cứu. Phần giải thích và bài học dùng tiếng Việt; số cột là thứ tự học, còn luồng tính thật theo phụ thuộc dữ liệu và các mũi tên.
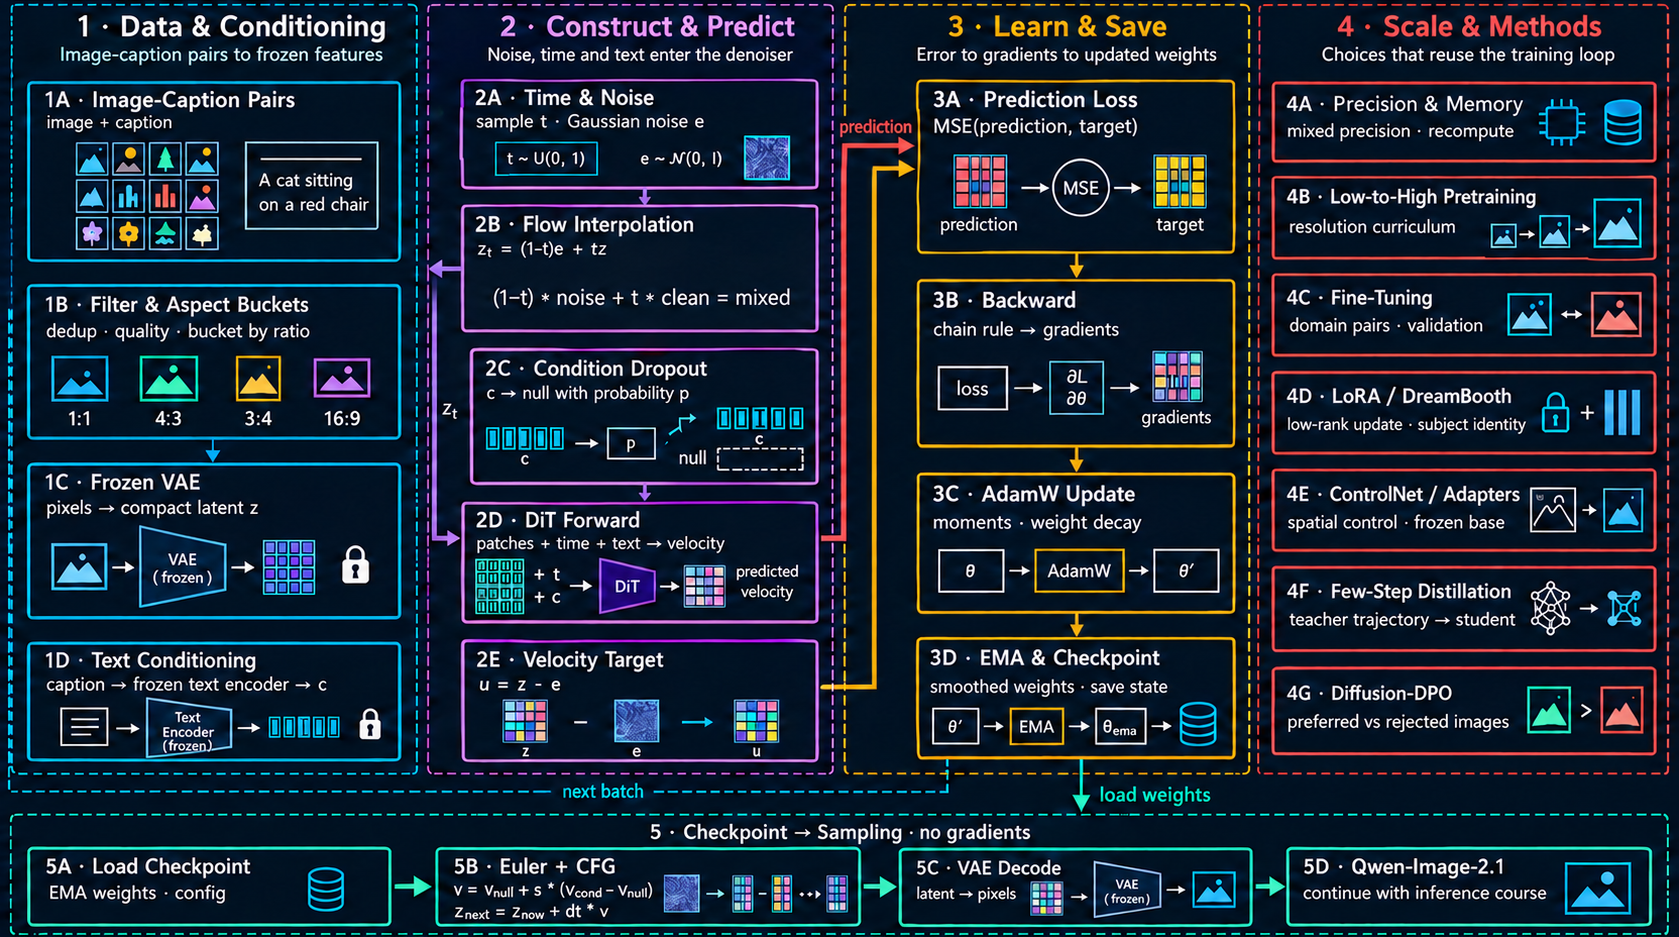
Vì sao cột 4 không phải bước tiếp theo?
Cột 1–3 tạo vòng học: cặp ảnh–chú thích tách thành latent và điều kiện chữ, tạo trạng thái nhiễu cùng target, dự đoán rồi sửa denoiser. Cột 4 là các lựa chọn dùng lại vòng này. 4A đổi cách dùng bộ nhớ; 4B–4G đổi dữ liệu, tham số, điều kiện phụ hoặc loss. Không phải học LoRA xong là bắt buộc chạy ControlNet, chưng cất rồi DPO. Các bộ mã hóa hiểu ảnh chỉ là nguồn điều kiện; khóa không huấn luyện sâu ViT/CLIP/VLM.
Thực hành toàn trình trong một bài Lab duy nhất (Tab 02)
Bảng Tab 02 ánh xạ 24 ô vào 10 giai đoạn của một lab NumPy. MLP thay DiT, ánh xạ đồng nhất thay VAE và nhãn hai lớp thay encoder chữ. Vòng flow, gradient, AdamW, EMA, đối chứng dropout, LoRA và Euler được chạy thật; ControlNet, DreamBooth, distillation, DPO và các tối ưu GPU chỉ được giải thích. Bảng nói rõ giới hạn từng ô. Mở Tab 02 · Bài Lab tổng hợp ↗
Nguồn công bố tham chiếu
Danh sách bài học (17)
- Ảnh–chú thích: lọc dữ liệu và ghép nhóm khung hình
- VAE cố định: từ pixel sang latent và trở lại
- Điều kiện chữ: encoder cung cấp tín hiệu cho mô hình sinh
- Nhiễu, thời gian và mục tiêu flow matching
- CFG: học điều kiện rỗng và kết hợp hai dự đoán
- DiT forward: latent, thời gian và chữ cùng dự đoán
- Loss hồi quy: ε, v và vận tốc cần được phân biệt
- Backward và AdamW: biến loss thành trọng số mới
- EMA và checkpoint: chọn trọng số để đánh giá và lưu
- Bộ nhớ: kiểu số, tính lại activation và độ phân giải
- Học nền: từ độ phân giải thấp tới cao
- Tinh chỉnh miền: giữ nền và học dữ liệu mới
- LoRA và DreamBooth: tham số nhỏ, mục tiêu cá nhân hóa
- ControlNet và adapters: thêm điều khiển không gian
- Chưng cất ít bước: học thay đổi quỹ đạo lấy mẫu
- Diffusion-DPO: học từ cặp ảnh ưu tiên
- Cầu nối suy luận: checkpoint, Euler, CFG và giải mã