TI · Kiến trúc huấn luyện sinh ảnh
Diffusion-DPO: học từ cặp ảnh ưu tiên
Dùng cặp ảnh được chọn/bị loại cùng prompt để tinh chỉnh sở thích, có mô hình tham chiếu và objective phù hợp diffusion thay vì xác suất token.
1Định nghĩa
Diffusion-DPO là phương pháp tinh chỉnh mô hình diffusion từ so sánh ưu tiên giữa hai ảnh sinh theo cùng prompt. Nó dùng mô hình tham chiếu cố định để điều chỉnh ưu tiên tương đối, khác học ảnh đúng đơn lẻ hoặc tăng CFG khi lấy mẫu.
Đầu vào gồm prompt, ảnh được chọn và ảnh bị loại; một objective suy ra cho diffusion dùng các sai số gỡ nhiễu theo thời gian để xây tín hiệu tương đối so với tham chiếu. Không có tích xác suất token như ở DPO văn bản; MSE dự đoán nhiễu là thành phần của objective, không tự là xác suất ảnh.
Ví dụ đời thường: Giám khảo chọn một trong hai bức tranh cùng đề thay vì ghi một bức duy nhất là đáp án tuyệt đối. Người học biết nên nghiêng về phương án nào, nhưng thiên kiến của giám khảo vẫn có thể đi vào mô hình; chọn được một bức không biến nó thành chuẩn phổ quát.
2Luồng
Mã 4G khớp sơ đồ Tab 01. Giai đoạn 10 khớp Tab 02; ánh xạ không có nghĩa mọi kỹ thuật của ô đều được triển khai trong lab.
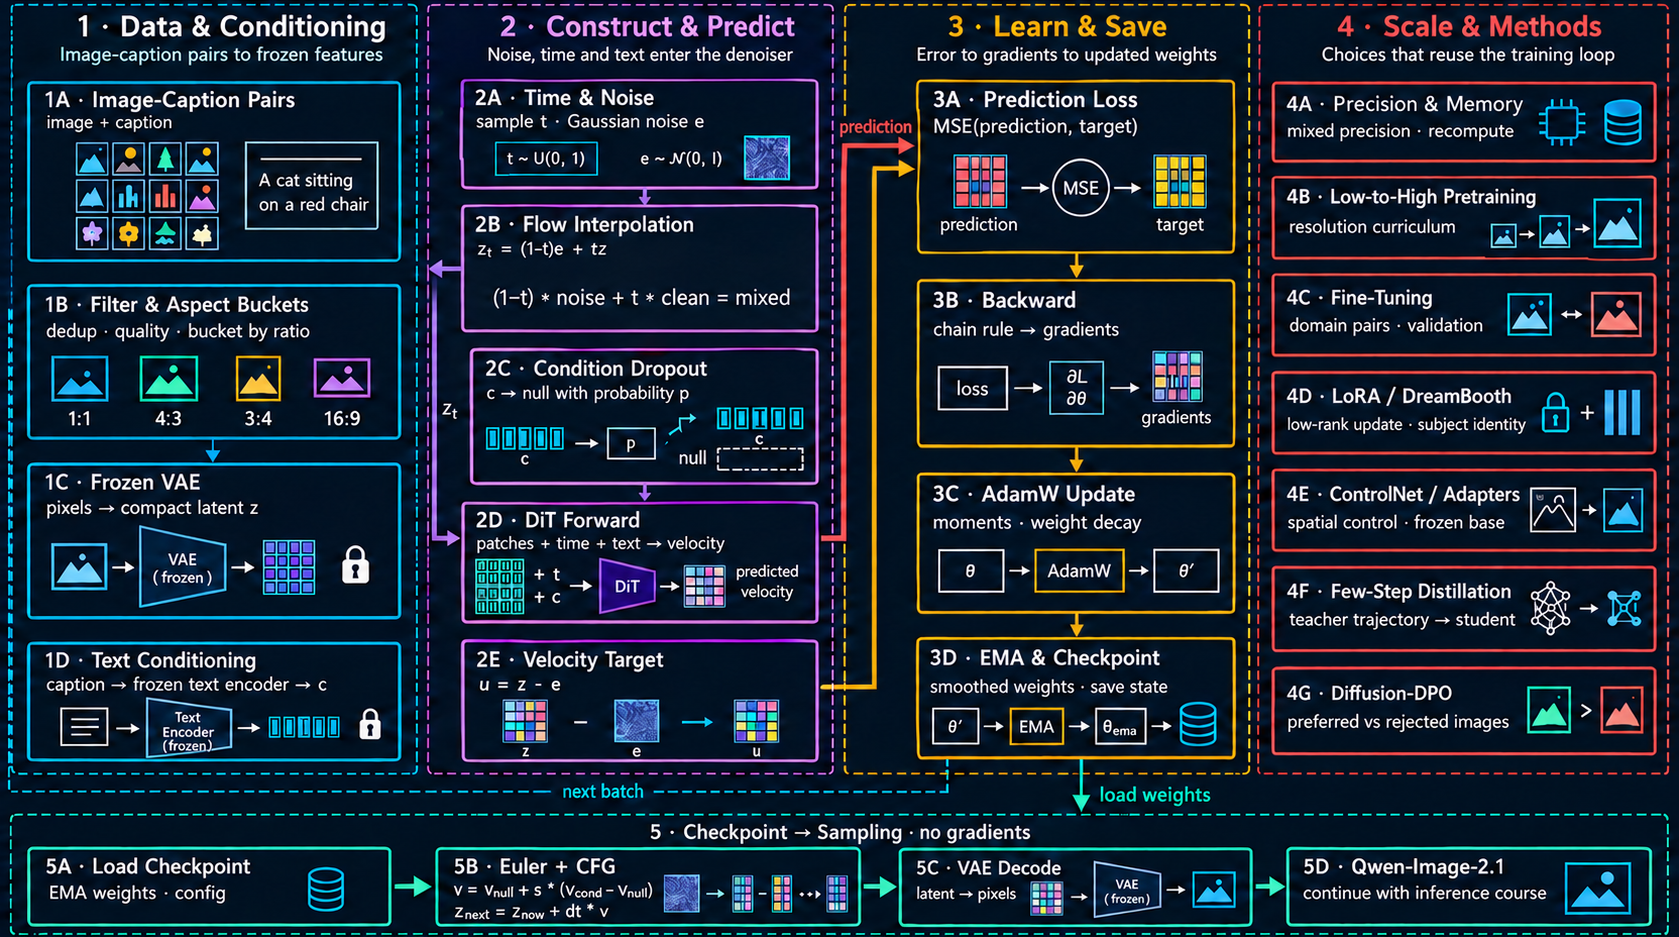
prompt · ảnh được chọn/bị loại · tham chiếu4G · Ưu tiên ảnh
Tinh chỉnh theo so sánh ưu tiên ảnh với objective phù hợp mô hình diffusion.
- Nhận gì
- Cặp ảnh được chọn/bị loại cho cùng prompt và mô hình tham chiếu cố định.
- Làm gì, vì sao
- Dùng objective Diffusion-DPO liên hệ sai số denoising với ưu tiên tương đối; không lấy xác suất token thay cho ảnh.
- Ra gì
- Policy đã đổi trọng số, cần đánh giá prompt mới và thiên kiến của dữ liệu ưu tiên.
- Ví dụ, cách đọc ô
- Một ảnh được chọn chỉ thắng ảnh còn lại trong cặp; không là đáp án tuyệt đối cho mọi người.
- Lưu ý
- Lab không chạy DPO; không thay ε bằng u rồi tự gọi raw MSE flow là log-likelihood ảnh chính xác.
- Nhận đầu vào
Diffusion-DPO là phương pháp tinh chỉnh mô hình diffusion từ so sánh ưu tiên giữa hai ảnh sinh theo cùng prompt.
- Biến đổi và nối hệ thống
Đọc ô 4G và các bước giải thích bên dưới.
- Đối chiếu thực hành
Giai đoạn 10 của lab; xem bảng ánh xạ để phân biệt thực thi với phần chỉ giải thích.
Mã Mermaid
flowchart TD
  step1["Nhận đầu vào"]
  step2["Biến đổi và nối hệ thống"]
  step3["Đối chiếu thực hành"]
  step1 --> step2
step2 --> step33Giải pháp
Vị trí trên sơ đồ: 4G. Tiền đề: biết tensor/attention từ LLM Foundations và loss, gradient, AdamW từ LLM Training (Text); phần dưới nhắc lại kiến thức cần dùng tại chỗ.
Nhắc lại ưu tiên tương đối
Mỗi cặp cần cùng prompt và tiêu chí lựa chọn rõ: bám chữ, chất lượng thị giác hoặc mục tiêu khác. “Được chọn” chỉ nói nó thắng ảnh còn lại theo dữ liệu so sánh. Chia tập theo prompt/nguồn để tránh đánh giá lại đúng các cặp đã dùng học.
Cần objective đúng hệ
DPO đối chiếu thay đổi log-likelihood (log độ hợp lý, đo xác suất gán cho dữ liệu) tương đối so với mô hình tham chiếu; diffusion không cung cấp trực tiếp log-prob của cả ảnh như mô hình token. Diffusion-DPO xây một dạng tối ưu từ cận biến phân (đại lượng thay thế cho log-likelihood khó tính trực tiếp) và sai số denoising, kèm trọng số thời gian và hệ số điều khiển mức lệch tham chiếu. Muốn thực thi phải theo đúng phương trình, lịch nhiễu và sampling t của công thức, không lấy âm raw MSE gọi là log-likelihood chính xác.
Trong đánh giá cặp, dùng t/nhiễu được ghép có kiểm soát giúp giảm nhiễu so sánh. Tham chiếu giữ cố định; nhánh policy học. MSE thông thường thấp trên cả chosen/rejected chưa xác nhận mô hình ưu tiên đúng; cần tiêu chí cặp và kiểm định độc lập.
Ranh giới diffusion và flow
Phương pháp Diffusion-DPO gốc không tự trở thành một recipe flow matching chỉ bằng cách thay ε bằng u=z−e. Với flow cần objective tương thích và kiểm định riêng. Ô 4G minh họa một nhánh preference trong họ mô hình sinh ảnh, không tuyên bố lab dùng chính loss ấy.
Giai đoạn 10 của Bài Lab tổng hợp không huấn luyện DPO, không có cặp chosen/rejected hay mô hình tham chiếu được tối ưu cặp. Các giá trị MSE, CFG và LoRA trước đó không phải số đo preference alignment.
4Profiling
- Tính đúng objective
Trước huấn luyện, kiểm tra policy bằng reference cho tín hiệu chênh lệch đúng mốc của công thức, kiểm tra gradient ở cặp nhỏ và đúng dấu chosen/rejected. Giữ cấu hình lịch t/weight rõ ràng; bài này chưa có implementation DPO.
- Đánh giá ngoài cặp học
Dùng prompt mới và lựa chọn người đánh giá độc lập, báo mức đồng thuận, độ đa dạng và sai hỏng. Điểm reward tự động tăng chưa chứng minh mọi người đều thích hơn.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Tính tay một cặp chosen/rejected với mô hình tham chiếu
Minh họa số học tại một thời điểm t và cùng nhiễu e: gọi E_pol(w) và E_ref(w) là sai số bình phương gỡ nhiễu của mô hình đang học (policy) và mô hình tham chiếu cố định (reference) trên ảnh được chọn w; tương tự E_pol(l) và E_ref(l) trên ảnh bị loại l. Xét đại lượng ưu tiên tương đối Δ = [E_ref(w) − E_pol(w)] − [E_ref(l) − E_pol(l)], đưa qua loss logistic L = −ln σ(β·Δ) với hệ số β>0 và σ(x)=1/(1+e^(−x)). Khi khởi tạo policy trùng hệt reference, E_pol=E_ref trên cả hai ảnh nên Δ=0 và baseline loss bằng −ln(0,5) ≈ 0,6931 nat. Nếu sau cập nhật, ở ảnh thắng có E_pol(w)=0,20 < E_ref(w)=0,35 (policy gỡ nhiễu tốt hơn tham chiếu 0,15) còn ở ảnh thua có E_pol(l)=0,45 > E_ref(l)=0,40 (policy kém tham chiếu 0,05), thì Δ = 0,15 − (−0,05) = +0,20 > 0; với β=5 ta có β·Δ=1,0 và L = −ln σ(1,0) ≈ 0,3133 nat, thấp hơn baseline 0,6931. Tự kiểm tra: nếu đảo nhãn chosen/rejected trên đúng cặp số này thì Δ đổi dấu thành −0,20 và loss tăng lên khoảng 1,3133 nat; đây là ví dụ số học cho cơ chế so cặp của Diffusion-DPO, không phải objective chạy trong toy lab flow matching.
Phân biệt CFG
Tăng CFG có cần dữ liệu cặp ưu tiên và backward không? Không, đó là quy tắc lấy mẫu. Diffusion-DPO sửa trọng số từ dữ liệu ưu tiên; hai thay đổi có thể kết hợp nhưng cần đánh giá từng cái.
6Thuật ngữ
- Reference model
- Bản mô hình cố định làm mốc khi điều chỉnh preference.
- Chosen/rejected
- Hai ảnh thắng/thua trong một so sánh cùng prompt, không phải nhãn đúng/sai tuyệt đối.
Glossary (1)
- Giới hạn của mô hình thu nhỏ
- Số lab chỉ thuộc dữ liệu hình học và cấu hình đã nêu; không suy ra chất lượng ảnh tự nhiên hoặc hiệu năng GPU.