TI · Kiến trúc huấn luyện sinh ảnh
VAE cố định: từ pixel sang latent và trở lại
Dùng bộ mã hóa ảnh đã học sẵn để nén ảnh thành latent; giữ cố định VAE trong vòng huấn luyện denoiser và giải mã sau lấy mẫu.
1Định nghĩa
VAE (variational autoencoder, bộ tự mã hóa biến phân) là cặp mạng mã hóa và giải mã tạo biểu diễn latent gọn hơn ảnh pixel. Trong hệ latent diffusion hai giai đoạn ở khóa này, VAE được học trước rồi giữ cố định khi denoiser học.
Encoder biến ảnh thành tham số phân phối latent; hệ có thể lấy mẫu latent và nhân hệ số chuẩn hóa theo cấu hình. Đường nội suy nhiễu được tạo trong không gian này; decoder chỉ đổi latent kết quả thành ảnh ở cuối, không quyết định mục tiêu vận tốc.
Ví dụ đời thường: VAE giống bản vẽ rút gọn và người dựng lại mô hình từ bản vẽ. Denoiser học sửa bản vẽ thay vì từng viên gạch; nét bị bỏ mất khi rút gọn có thể không dựng lại được, nên phép nén có giới hạn chất lượng riêng.
2Luồng
Mã 1C, 5C khớp sơ đồ Tab 01. Giai đoạn 2 khớp Tab 02; ánh xạ không có nghĩa mọi kỹ thuật của ô đều được triển khai trong lab.
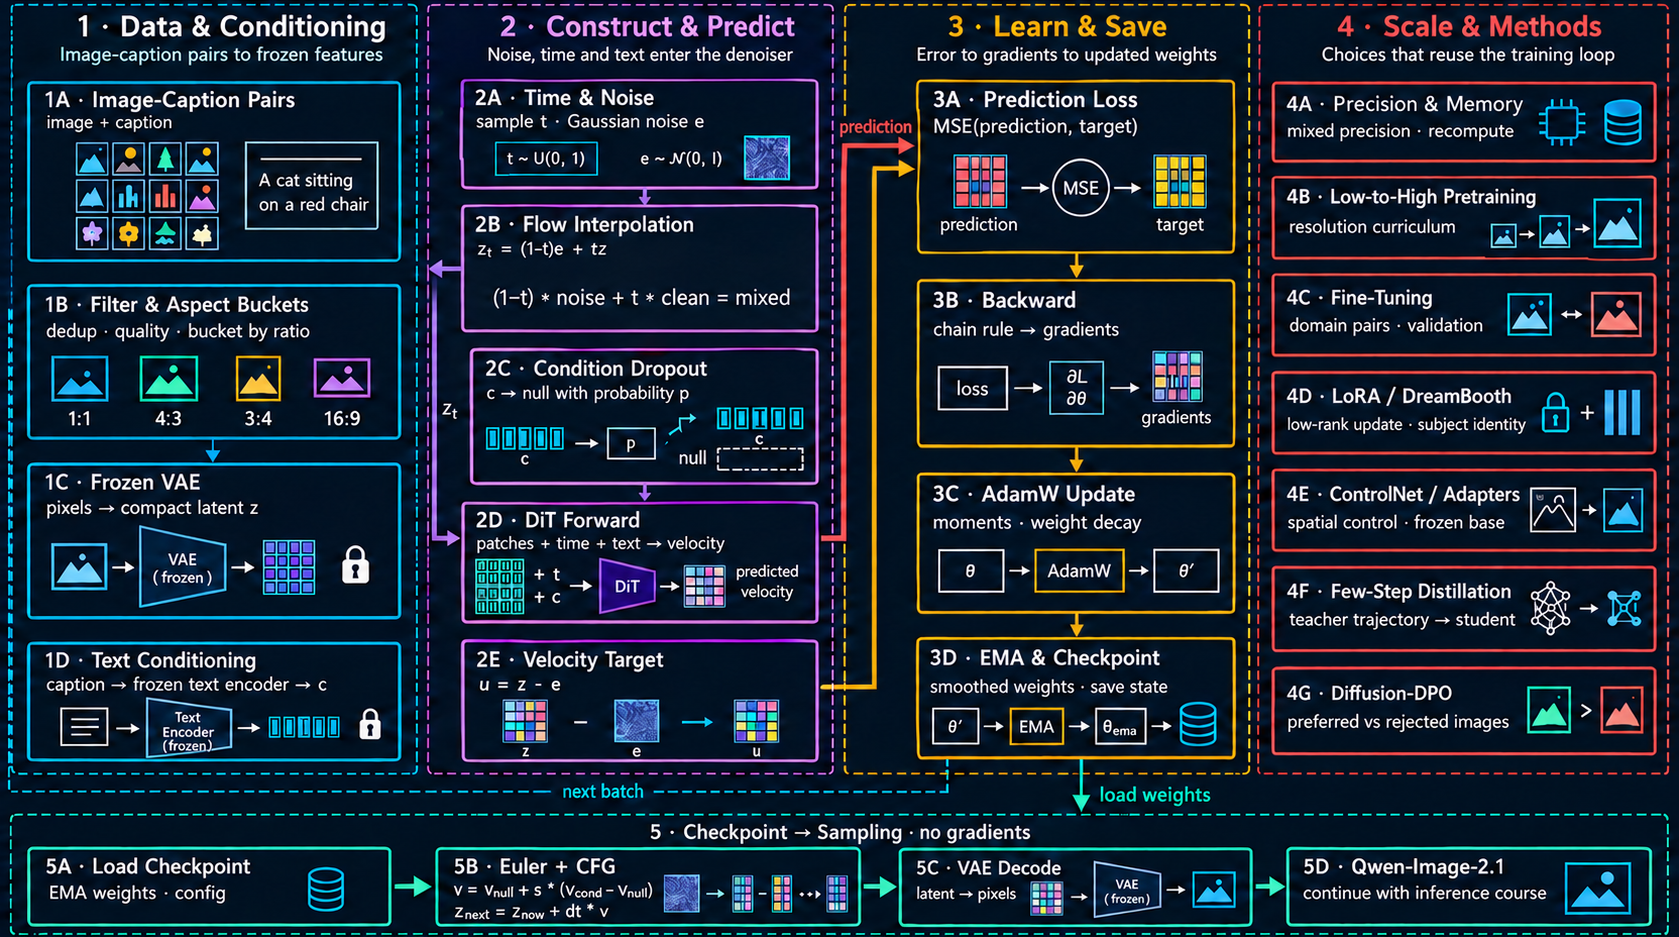
pixel → encoder cố định → latent z1C · VAE đóng băng
Nén ảnh bằng VAE đã học trước để vòng denoiser xử lý biểu diễn latent nhỏ hơn.
- Nhận gì
- Ảnh sau phép resize/crop của 1B; không nhận chú thích làm pixel.
- Làm gì, vì sao
- VAE là bộ mã hóa/giải mã ảnh; encoder đổi ảnh thành latent và áp scale/shift theo cấu hình, giữ trọng số cố định.
- Ra gì
- Latent sạch z tới 2B để nội suy và 2E để tạo target; không đưa nó vào text encoder 1D.
- Ví dụ, cách đọc ô
- Lab thay encoder bằng ánh xạ đồng nhất: 16 pixel vẫn là 16 số, sai lệch kiểm tra bằng 0.
- Lưu ý
- Không có học VAE trong lab; đóng băng không tự làm latent ngẫu nhiên thành xác định.
- Nhận đầu vào
VAE (variational autoencoder, bộ tự mã hóa biến phân) là cặp mạng mã hóa và giải mã tạo biểu diễn latent gọn hơn ảnh pixel.
- Biến đổi và nối hệ thống
Đọc ô 1C, 5C và các bước giải thích bên dưới.
- Đối chiếu thực hành
Giai đoạn 2 của lab; xem bảng ánh xạ để phân biệt thực thi với phần chỉ giải thích.
Mã Mermaid
flowchart TD
  step1["Nhận đầu vào"]
  step2["Biến đổi và nối hệ thống"]
  step3["Đối chiếu thực hành"]
  step1 --> step2
step2 --> step33Giải pháp
Vị trí trên sơ đồ: 1C, 5C. Tiền đề: biết tensor/attention từ LLM Foundations và loss, gradient, AdamW từ LLM Training (Text); phần dưới nhắc lại kiến thức cần dùng tại chỗ.
Nhắc lại các trục của ảnh
Một tensor ảnh có trục mẫu, chiều cao, chiều rộng và kênh màu. Latent vẫn có trục không gian nhưng thường ít vị trí hơn và số kênh khác RGB; thứ tự trục và tỉ lệ nén phụ thuộc VAE. Không lấy thông số của một checkpoint áp cho mọi mô hình.
Chặn gradient đúng chỗ
Tại ô 1C, chạy encoder không lưu đồ thị gradient và không đưa tham số VAE vào AdamW. Trọng số cố định không đồng nghĩa đầu ra luôn y hệt nếu encoder còn lấy mẫu ngẫu nhiên; hãy cố định RNG khi cần so số. Khi đã cố định crop và encoder, có thể cache latent, nhưng crop hay VAE đổi thì cache cũ không còn hợp lệ.
Hệ số scale/shift của latent là một phần hợp đồng checkpoint. Nếu dùng z = scale nhân latent trong huấn luyện thì giải mã phải hoàn tác theo cấu hình trước khi qua decoder. Nạp đúng trọng số denoiser nhưng sai scale vẫn làm phân bố đầu vào lệch.
Tách lỗi nén khỏi lỗi sinh
Trước khi học, thử ảnh → encoder → decoder và xem vật thể, chữ nhỏ, biên màu còn giữ được không. Sau khi lấy mẫu ở 5B, dùng cùng decoder tại 5C. Đây là hai lượt sử dụng VAE, không phải học lại VAE sau mỗi bước Euler.
Giai đoạn 2 của Bài Lab tổng hợp dùng reshape đồng nhất thay VAE; giai đoạn 9 đổi 16 số thành lưới 4×4. Sai lệch đồng nhất bằng 0 chỉ kiểm tra cách đọc trục, không đo nén hoặc chất lượng VAE.
4Profiling
- Mốc tái tạo
Giữ một tập ảnh, cùng crop và cách lấy latent; so ảnh gốc với ảnh tái tạo trước khi so ảnh sinh. Nếu tái tạo đã mất chữ nhỏ, giảm loss denoiser chưa bảo đảm phục hồi chi tiết ấy.
- Bộ nhớ cache
Đếm byte latent được lưu và thời gian mã hóa riêng với denoiser. Báo rõ dtype, số ảnh và tỉ lệ nén; lab chỉ đếm trọng số MLP, không đo chi phí VAE.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Tính trục có điều kiện
Minh họa, không phải cấu hình Qwen: ảnh 32×32 qua encoder giảm mỗi chiều 4 lần cho lưới 8×8. Nếu latent có 4 kênh thì có 256 số, so với 3.072 số RGB. Tự kiểm tra: chỉ biết số chiều đã đủ kết luận không mất chất lượng chưa? Chưa, phải xem tái tạo.
Tìm ranh giới lab
Chạy giai đoạn 2 và tìm “ánh xạ thay VAE lệch=0”. Tại sao không gọi đó là VAE huấn luyện thành công? Vì không có mạng mã hóa, loss tái tạo hay cập nhật tham số VAE nào.
6Thuật ngữ
- Latent
- Biểu diễn ảnh trong không gian mà denoiser thực sự xử lý.
- Đóng băng
- Giữ tham số cố định và bỏ chúng khỏi cập nhật optimizer.
Glossary (1)
- Giới hạn của mô hình thu nhỏ
- Số lab chỉ thuộc dữ liệu hình học và cấu hình đã nêu; không suy ra chất lượng ảnh tự nhiên hoặc hiệu năng GPU.