6B · Final AdaLN & 8-Step Euler
6B · Scale-Only Final AdaLN, Dự đoán vận tốc v_θ & Vòng lặp 8-Step Euler
Sau 32 khối, AdaLN cuối chỉ nhân (1 + scale) rồi proj_out 4096 → 64 dự đoán vận tốc; 8 bước Euler Turbo đi theo bảng sigma từ 1.0 về 0.0, rồi mở chuẩn hóa và giải nén latent thành ảnh RGBA.
1Định nghĩa
Bài 6B là đầu ra của 32 khối và vòng lặp kết thúc pipeline: hidden cuối đi qua QwenImage21AdaLayerNormContinuous — chuẩn hóa rồi nhân (1 + scale), không cộng shift, nên khác nhiều lớp điệu biến trong khối chỉ giữ phần scale — rồi proj_out là Linear(4096, 64) biến từng token thành một ô latent 64 kênh. Toàn bộ đầu ra thực chất là v_θ(x, σ): trường vận tốc (velocity field) học được, chỉ ra hướng nhích của ảnh đang nặn ở từng mức nhiễu σ. Flow matching dạy mô hình học hướng này; pipeline Turbo chọn trước 8 mốc σ và đi bằng phương pháp Euler.
Về cơ chế, bảng sigma của Turbo là [1.0, 0.978453, 0.95418, 0.926626, 0.89508, 0.845148, 0.704534, 0.414568, 0.0]; x khởi đầu ở σ = 1.0 và mỗi bước k: chạy 32 khối (từ lần thứ hai chỉ query ảnh đích nhờ bài 6A), lấy v_θ(x_k, σ_k) rồi cập nhật x_(k+1) = x_k + (σ_(k+1) − σ_k) × v_θ(x_k, σ_k); vì σ giảm dần nên chênh lệch là số âm — quy ước dấu đã học lúc huấn luyện, không phải phép đảo tự do. Sau bước cuối (σ = 0.0), latent được mở chuẩn hóa z × latents_std + latents_mean theo từng kênh — phép ngược của bài 1A — và decoder VAE trả ảnh RGBA 4 kênh. Nền của cách sinh theo trường vận tốc viết trong bài diffusion của llm-inference, còn hệ thống điệu biến mức t vẫn của bài 3B.
Ví dụ đời thường: 6B giống nhào nặn đất sét theo 8 nhịp: đôi tay thợ (v_θ) không nhắc tên sản phẩm cuối mà chỉ nói hướng nhích ở từng độ mềm của đất (σ); lộ trình (bảng sigma) quyết định nhịp nào nắn rất nhẹ (đầu lộ trình, chênh 0.0215) và nhịp nào định hình mạnh (cuối lộ trình, chênh 0.4146); khi hình định hình xong phải gỡ bảng đo và mở khuôn (un-standardize rồi decoder VAE) để lấy sản phẩm thật đúng màu gốc. Giới hạn của phép so: 8 nhịp là thiết kế cố định của Turbo; nhiều nhịp hơn thường mịn hơn nhưng chậm hơn — chưa đo trên máy bạn thì không có con số cụ thể để khẳng định.
2Luồng
Cách đọc hình (Cột 4, khối 6B ở đỉnh cột trên 5A, mũi tên ↑): nhận hidden cuối của các khối, qua final AdaLN (scale-only) và proj_out 4096 → 64 thành trường vận tốc; vòng lặp 8 bước Euler quay lại chuỗi khối — các bước 2..8 dùng cache của khối 6A ở Cột 3 — đến σ = 0.0 thì mở chuẩn hóa và decoder VAE của khối 1A trả ảnh RGBA; xem bước [6B] trong [Bài Lab tổng hợp Qwen-Image-2.1](/courses/qwen-image-2-1/qwen21-lab/qwen21-end-to-end-lab/).
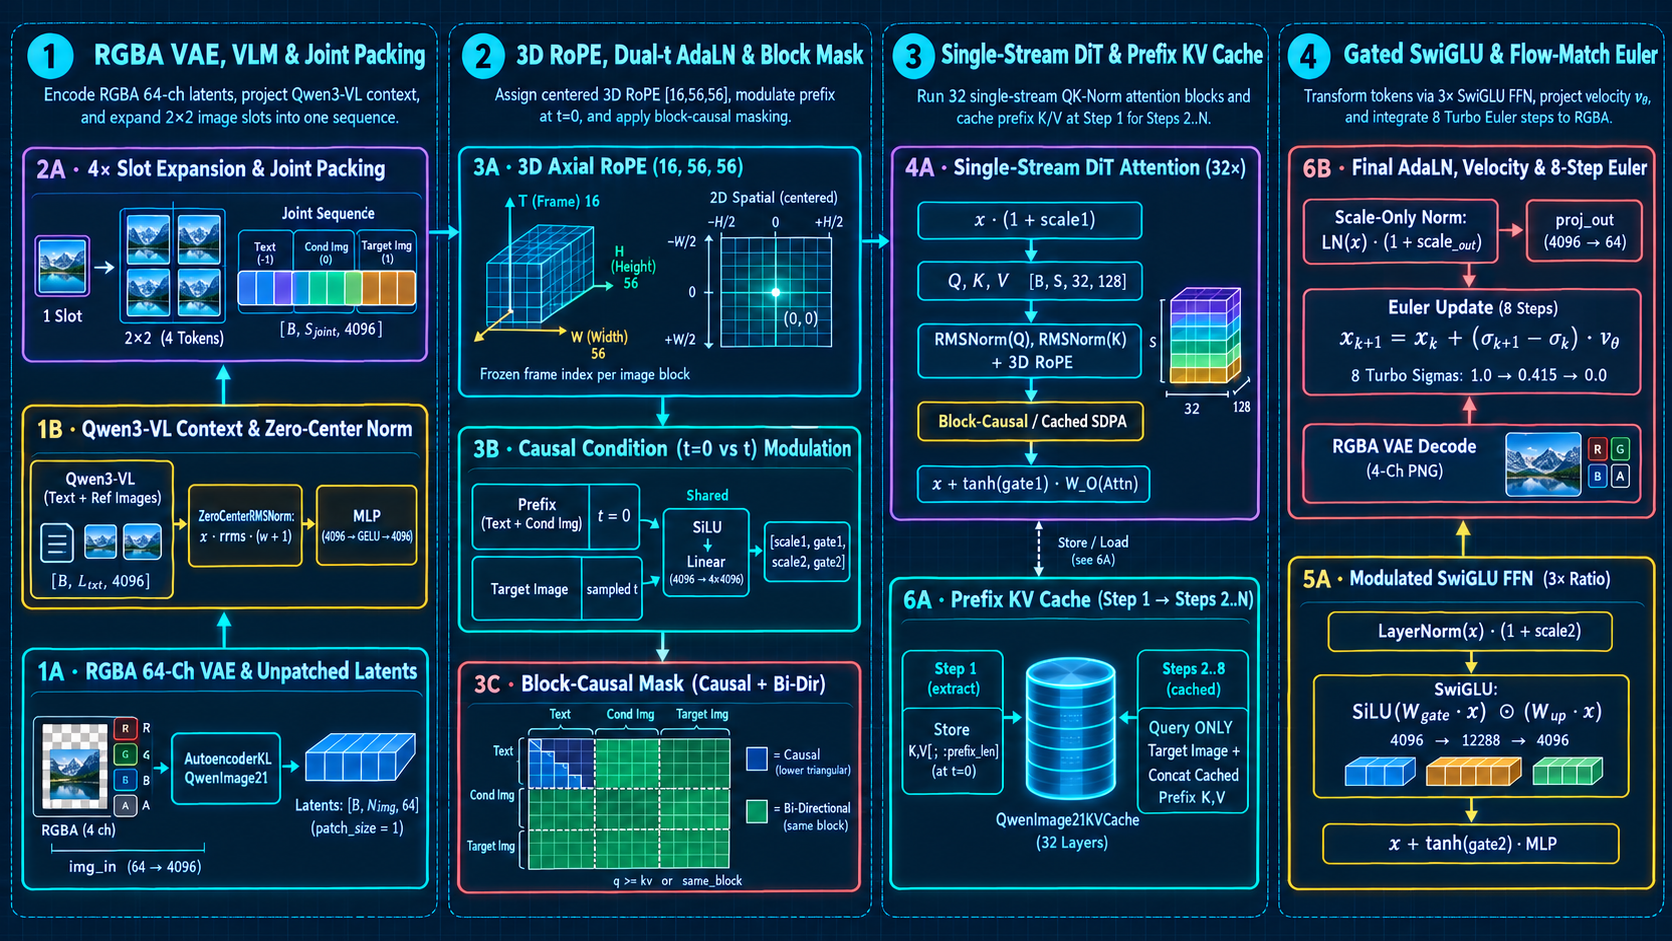
LN(x)·(1+scale_out) → proj_out(4096→64) = v_θ · x_{k+1} = x_k + (σ_{k+1}−σ_k)·v_θ (8 Turbo steps) → RGBA VAE Decode6B · Final AdaLN, Velocity & 8-Step Euler
Biến đầu ra thành ảnh: chiếu token ảnh đích về vận tốc 64 kênh v_θ, nhích latent qua 8 bước Euler từ nhiễu về sạch, rồi VAE giải mã ra ảnh RGBA.
- Mục đích
- Mô hình không đoán thẳng ảnh cuối mà đoán “hướng đi” từ nhiễu về ảnh (flow matching). Bộ lập lịch Euler cộng dồn các bước nhỏ theo hướng đó; khi tới σ = 0, latent đã sạch và được giải nén thành ảnh.
- Đầu vào
- Token ảnh đích sau lớp DiT thứ 32 [B, N_img, 4096] và latent hiện tại x_k của ảnh đích.
- Đầu ra
- Mỗi bước: LN(x) · (1 + scale_out) → proj_out ra v_θ [B, N_img, 64], rồi x_{k+1} = x_k + (σ_{k+1} − σ_k) · v_θ quay lại 2A cho bước sau. Sau bước 8: khử chuẩn hóa z · std + mean và VAE decode thành ảnh RGBA [B, 4, H, W].
Sau khi đi hết 32 lớp qua 5A, luồng ẩn đi lên 6B ở đỉnh Cột 4: QwenImage21AdaLayerNormContinuous chỉ nhân tỷ lệ LN(x) · (1 + scale_out) (bỏ phép cộng shift) rồi chiếu proj_out (4096 → 64) để dự đoán trường vận tốc v_θ. Bộ lập lịch FlowMatchEulerDiscreteScheduler cập nhật x_{k+1} = x_k + (σ_{k+1} − σ_k) · v_θ qua 8 bước sigma của bản Turbo (từ 1.0 về 0.0 với CFG = 1), sau đó khử chuẩn hóa z · std + mean và giải mã qua VAE Decoder thành ảnh 4 kênh RGBA.
- 6B · Final AdaLN scale-only
Chuẩn hóa hidden đầu ra và nhân (1 + scale) theo hàng t; không có bước cộng shift.
- 6B · Vòng 8 bước Euler
Dự đoán v_θ theo bảng sigma, cập nhật x(k+1) = x(k) + (σ(k+1) − σ(k)) × v_θ.
- 6B · Mở chuẩn hóa và giải nén
z × latents_std + latents_mean từng kênh, rồi decoder VAE trả ảnh RGBA 4 kênh.
Mã Mermaid
flowchart TD
  step1["6B · Final AdaLN scale-only"]
  step2["6B · Vòng 8 bước Euler"]
  step3["6B · Mở chuẩn hóa và giải nén"]
  step1 --> step2
step2 --> step33Giải pháp
Bài toán cần giải: hidden ở cuối 32 khối mang tín hiệu điệu biến chưa thẳng về không gian latent; cần một cửa ra 4096 → 64 đúng chuẩn, và một lộ trình khử nhiễu hẹp đủ ít bước mà vẫn đọc được hướng đi. Sau bài này, bạn cần tự kể được: AdaLN cuối khác phần điệu biến trong khối thế nào, v_θ là dự đoán cái gì, và cập nhật Euler chạy như thế nào.
Trạng thái đầu vào: hidden 4096 chiều của ảnh đích (các bước 2..8 chỉ tính phần này, còn prefix dùng cache), cùng lúc QwenImage21AdaLayerNormContinuous nhân (1 + scale) mà không cộng shift — scale đến từ cùng hàng t của bước hiện hành như cả bài 3B.
Các thao tác và lý do: (1) final AdaLN scale-only để giữ biểu diễn đơn giản ở cửa ra, nơi hiệu chỉnh phức tạp dễ phiền không cần; (2) proj_out 4096 → 64 cho mỗi token = một ô latent; ghép từng token thành bản đồ latent đúng hình dáng; (3) vòng Euler: đọc σ từ bảng của Turbo, tính v_θ, nhân chênh lệch σ, cộng vào x cho đến σ = 0.0; (4) mở chuẩn hóa z × latents_std + latents_mean và decoder VAE trả ảnh RGBA 4 kênh.
Đầu ra và cách đọc: mỗi vòng Euler in x hiện hành theo từng σ (đọc bước 6B của lab): những nhịp đầu thay đổi rất nhỏ, những nhịp cuối lớn dần — như bảng chênh ở Ví dụ 1 dẫn ra từ chính bảng sigma. Nguồn của bảng chênh là phép cộng trừ trực tiếp từ các mốc công bố, không phải nhận định.
Giới hạn: v_θ phụ thuộc cả x lẫn σ — cùng x, σ khác cho vận tốc khác; bảng sigma là của cấu hình Turbo, chọn 8 bước không chung cho mọi checkpoint; mở chuẩn hóa phải dùng đúng cặp latents_mean và latents_std của checkpoint; chất lượng ảnh không đọc được chỉ từ bảng sigma mà phải sinh và so sánh thật.
4Profiling
- Bảng chênh Δσ của lộ trình 8 bước
Tính từng chênh σ(k+1) − σ(k) từ bảng 8 sigma dùng phép cộng trừ trực tiếp: đầu là 0.021547, 0.024273, 0.027554, 0.031546, 0.049932, 0.140614, 0.289966, 0.414568; tổng phải đúng 1.0. So với bảng được lab in tại bước 6B; nếu lệch, kiểm tra lại bảng sigma đã cấu hình.
- v_θ thay đổi theo σ
Đặt cùng một x, chạy forward với ba σ khác nhau trong bước 6B của lab và so vận tốc dự đoán: ba lượt phải cho ba kết quả khác nhau. Dừng ở đó: khác nhau nghĩa là mô hình nhận σ — chưa là phép đánh giá chất lượng ảnh.
- Parity mở chuẩn hóa và decoder
Encode một ảnh rồi quay vòng: mở chuẩn hóa từng kênh bằng latents_std và latents_mean, giải nén lại, rồi so hình thật; chênh lệch nhỏ là hợp lệ vì decoder nén có tổn thất, số chênh in tại lab; đây không phải kiểm tra lấy chính xác từng pixel.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Tính bảng Δσ từ 8 mốc sigma
Input: bảng sigma [1.0, 0.978453, 0.95418, 0.926626, 0.89508, 0.845148, 0.704534, 0.414568, 0.0]. Hãy dự đoán trước: nhịp nào dài nhất? Kết quả bằng tay: các chênh là 0.021547, 0.024273, 0.027554, 0.031546, 0.049932, 0.140614, 0.289966, 0.414568 — nhịp cuối dài nhất và tổng đúng 1.0. Cách quan sát: bước 6B của [Bài Lab tổng hợp Qwen-Image-2.1](/courses/qwen-image-2-1/qwen21-lab/qwen21-end-to-end-lab/) in bảng này cùng x từng bước; tự kiểm tra các mốc bằng phép cộng trừ trên máy tính của bạn.
Mở chuẩn hóa ngược lại một ô
Input: một ô latent chuẩn hóa có z_hat = 2, với latents_std = 2 và latents_mean = 8 cùng kênh (cặp số minh họa đã dùng ở Ví dụ 1 của bài 1A). Hãy dự đoán giá trị thật trước khi tính. Kết quả: z = z_hat × latents_std + latents_mean = 2 × 2 + 8 = 12, đúng vòng lại con số xuất phát ở bài 1A. Tự kiểm tra: z_hat = 0 cho về đúng latents_mean; z_hat = −1 cho về 6. Giới hạn: mỗi kênh dùng đúng cặp mean và std của chính kênh, tráo kênh là lệch vòng.
6Thuật ngữ
- QwenImage21AdaLayerNormContinuous
- AdaLN bản liên tục ở đầu ra: chuẩn hóa rồi nhân (1 + scale), không cộng shift — scale-only.
- proj_out
- Linear(4096, 64): biến từng token thành một ô latent 64 kênh, đúng chiều của không gian latent VAE.
- v_θ(x, σ)
- Trường vận tốc học được: hàm chỉ ra hướng nhích của ảnh đang nặn tại mức nhiễu σ, không trả ảnh trực tiếp.
- Bảng 8 sigma Turbo
- [1.0, 0.978453, 0.95418, 0.926626, 0.89508, 0.845148, 0.704534, 0.414568, 0.0] — 9 mốc cho 8 bước.
- Euler update
- x(k+1) = x(k) + (σ(k+1) − σ(k)) × v_θ(x(k), σ(k)); đi dần từ nhiễu về ảnh.
Glossary (3)
- Flow matching
- Trường học dạy mô hình dự đoán vận tốc đi từ nhiễu về dữ liệu, thay vì dự đoán ảnh sạch trực tiếp.
- Euler
- Phương pháp tích phân số đơn giản nhất: đi từng bước theo vận tốc với bước dài bằng chênh lệch tham số lộ trình.
- Un-standardize
- Phép ngược của chuẩn hóa bài 1A: nhân latents_std rồi cộng latents_mean để về phân bố thật của latent.