TI · Kiến trúc huấn luyện sinh ảnh
Bộ nhớ: kiểu số, tính lại activation và độ phân giải
Tách trọng số, gradient, trạng thái optimizer và activation trước khi chọn mixed precision, gradient checkpointing hoặc giảm số token ảnh.
1Định nghĩa
Bộ nhớ huấn luyện sinh ảnh chứa nhiều hơn bản trọng số: còn gradient, trạng thái optimizer và activation của từng batch. Mixed precision dùng nhiều kiểu số cho các phép tính khác nhau; gradient checkpointing bỏ bớt activation rồi tính lại khi backward.
Với DiT, số token ảnh tăng theo diện tích latent và kích thước patch, làm activation cùng attention tốn hơn. AdamW còn giữ m,v cho tham số được học; đóng băng VAE không xóa bộ nhớ denoiser hoặc chi phí mã hóa ảnh.
Ví dụ đời thường: Xưởng làm tranh cần chỗ cho dụng cụ, tranh đang làm và bản ghi chỉnh sửa. Cất bớt bản nháp giúp đỡ chật nhưng phải vẽ lại khi cần; nó đổi bộ nhớ lấy công, không chứng minh làm nhanh hơn.
2Luồng
Mã 4A khớp sơ đồ Tab 01. Giai đoạn 10 khớp Tab 02; ánh xạ không có nghĩa mọi kỹ thuật của ô đều được triển khai trong lab.
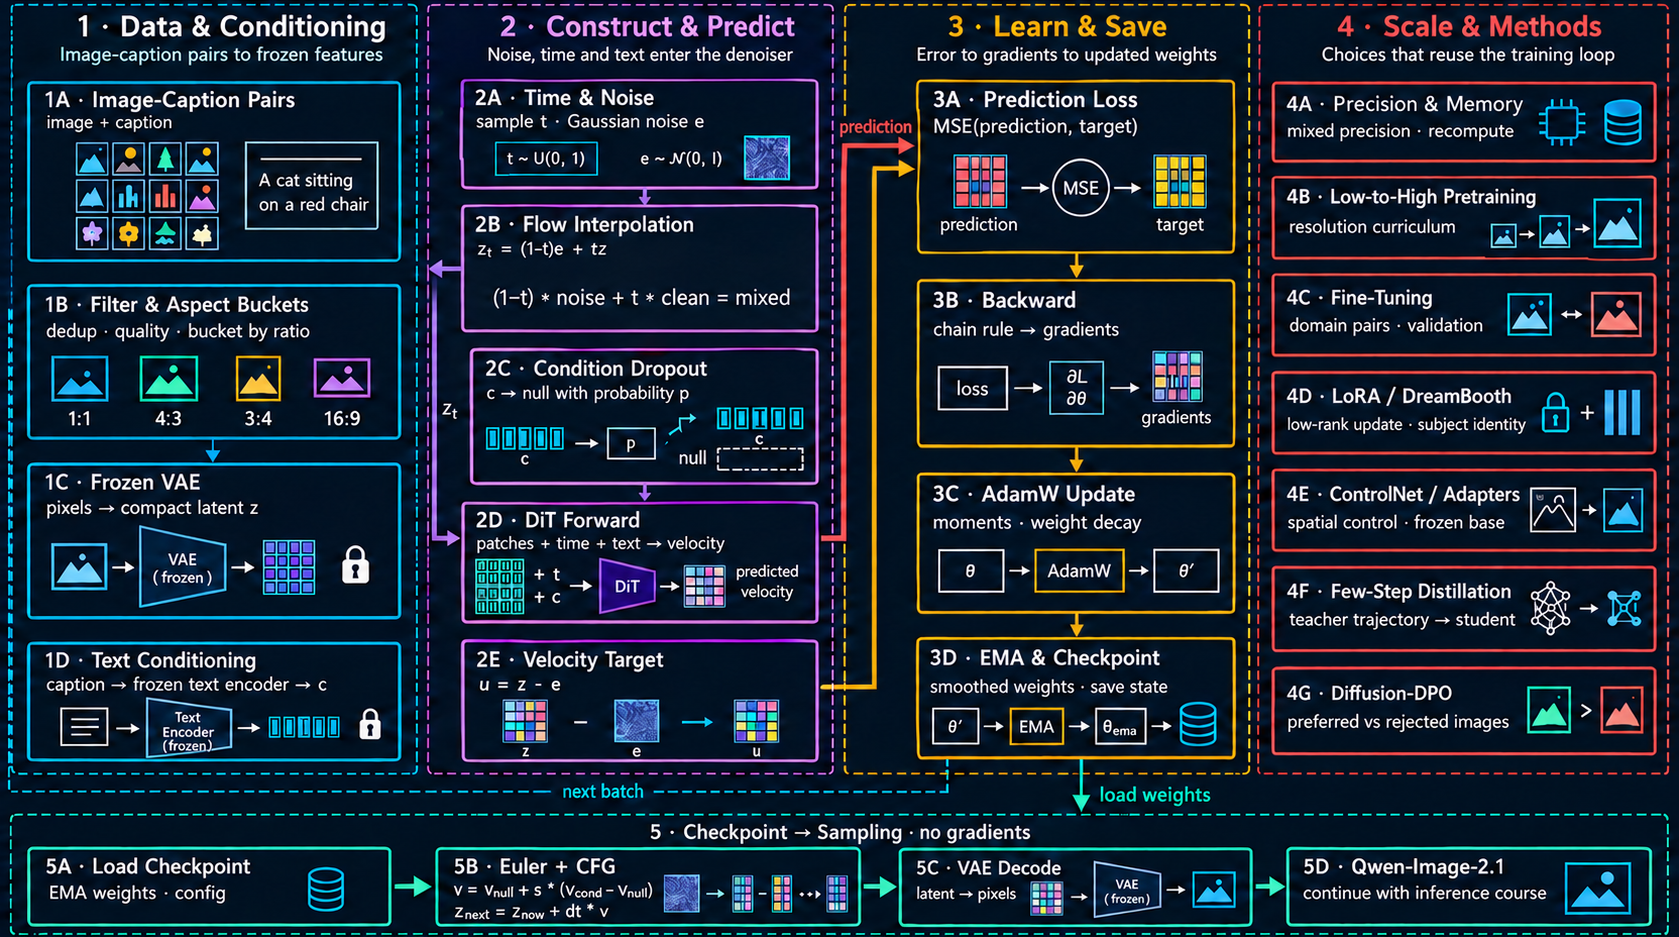
precision hỗn hợp · tính lại activation4A · Kiểu số và bộ nhớ
Chọn cách tiết kiệm bộ nhớ theo phần chiếm chỗ thật của vòng học.
- Nhận gì
- Ngân sách trọng số, gradient, trạng thái AdamW và activation của cột 2–3.
- Làm gì, vì sao
- Mixed precision phối hợp kiểu số; recompute bỏ bớt activation rồi tính lại khi backward, đổi bộ nhớ lấy phép tính.
- Ra gì
- Một cấu hình vòng học vừa ngân sách hơn; không tạo target hay loss mới theo mặc định.
- Ví dụ, cách đọc ô
- Lab chỉ đếm trọng số: 13.952 byte float64, 6.976 float32, 3.488 float16 với cùng 1.744 số.
- Lưu ý
- Đây là đếm từ dtype, không chạy mixed precision/recompute hay đo peak GPU và tốc độ.
- Nhận đầu vào
Bộ nhớ huấn luyện sinh ảnh chứa nhiều hơn bản trọng số: còn gradient, trạng thái optimizer và activation của từng batch.
- Biến đổi và nối hệ thống
Đọc ô 4A và các bước giải thích bên dưới.
- Đối chiếu thực hành
Giai đoạn 10 của lab; xem bảng ánh xạ để phân biệt thực thi với phần chỉ giải thích.
Mã Mermaid
flowchart TD
  step1["Nhận đầu vào"]
  step2["Biến đổi và nối hệ thống"]
  step3["Đối chiếu thực hành"]
  step1 --> step2
step2 --> step33Giải pháp
Vị trí trên sơ đồ: 4A. Tiền đề: biết tensor/attention từ LLM Foundations và loss, gradient, AdamW từ LLM Training (Text); phần dưới nhắc lại kiến thức cần dùng tại chỗ.
Nhắc lại byte và dtype
Float64 dùng 8 byte mỗi phần tử, float32 dùng 4, float16/bfloat16 dùng 2; chúng khác cả độ chính xác và khoảng biểu diễn. Mixed precision thường giữ một số phép nhạy như cộng loss hoặc trạng thái optimizer ở kiểu rộng hơn. Không lấy số byte trọng số nhân một hệ số cố định rồi gọi là peak GPU cho mọi cấu hình.
Chọn biện pháp theo nguồn chiếm chỗ
Nếu activation lớn, giảm microbatch, giảm token ảnh hoặc checkpoint một số khối có thể phù hợp. Gradient checkpointing lưu đầu vào khối, bỏ trung gian và recompute khi backward; để so gradient cần tái tạo cùng dropout/RNG. Nó khác checkpoint lưu mô hình ra đĩa ở ô 3D.
Nếu optimizer chiếm phần lớn, LoRA giảm số tham số được học; hệ nhiều GPU có thể chia trạng thái nhưng thêm giao tiếp. Gradient accumulation gom nhiều microbatch để giữ batch hiệu dụng, không giảm peak của một microbatch giữ nguyên. Tăng độ phân giải nên dự toán cả số patch mới chứ không chỉ số pixel của ảnh đầu vào.
Bằng chứng mà lab có
Giai đoạn 10 của Bài Lab tổng hợp đếm 13.952 byte trọng số float64, hoặc 6.976/3.488 byte nếu chỉ đổi cách lưu 1.744 số sang float32/float16. Đây là phép tính từ dtype, chưa chạy mixed precision hay checkpointing và chưa tính activation, gradient, m,v.
4Profiling
- Đúng rồi mới tiết kiệm
Trên batch cố định, so loss/gradient của bản tham chiếu float32 hoặc float64 với bản đổi precision/recompute. Đặt dung sai theo kiểu số và xem tích lũy sai số; độ lệch nhỏ một bước chưa bảo đảm huấn luyện dài ổn định.
- Peak theo workload
Báo GPU, batch/microbatch, số token, precision, optimizer, chế độ attention và bộ nhớ đỉnh sau warm-up. Đo thời gian riêng để thấy giá phải trả; không khẳng định tăng tốc từ phép đếm byte.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Tự kiểm tra diện tích
Minh họa: số token ảnh tăng từ 16 lên 64 khi tăng gấp đôi mỗi chiều. Bảng attention đầy đủ từ 256 lên 4.096 phần tử, gấp 16; không có nghĩa toàn mô hình chậm đúng 16 lần.
Đếm đúng phần nào
Lab cho float16 bằng 3.488 byte. Có thể đặt GPU memory limit bằng số ấy không? Không: chỉ riêng hai tensor moment của AdamW đã là trạng thái thêm, chưa kể activation và runtime.
6Thuật ngữ
- Mixed precision
- Kết hợp các kiểu số theo độ nhạy và chi phí của từng phép tính.
- Gradient checkpointing
- Lưu ít activation hơn, tính lại khi cần gradient; không phải lưu checkpoint mô hình.
Glossary (1)
- Giới hạn của mô hình thu nhỏ
- Số lab chỉ thuộc dữ liệu hình học và cấu hình đã nêu; không suy ra chất lượng ảnh tự nhiên hoặc hiệu năng GPU.