TI · Kiến trúc huấn luyện sinh ảnh
Backward và AdamW: biến loss thành trọng số mới
Lan truyền gradient qua denoiser rồi dùng AdamW cập nhật tham số được học, giữ nguyên encoder đã đóng băng và kiểm tra bằng sai phân.
1Định nghĩa
Backward là lượt áp dụng quy tắc chuỗi để tính độ nhạy của loss với từng tham số, còn AdamW là bộ tối ưu chuyển các gradient ấy thành bước thay đổi trọng số. Hai ô 3B và 3C nối việc chấm sai số với vòng học kế tiếp.
Từ MSE, gradient đi ngược đầu ra, các khối denoiser và phép chiếu; VAE cố định cùng encoder chữ không nhận cập nhật trong cấu hình này. AdamW giữ trung bình trượt của gradient và gradient bình phương rồi trừ suy giảm trọng số riêng.
Ví dụ đời thường: Sau một mẻ bánh, người thợ xác định yếu tố nào khiến bánh lệch công thức rồi chọn mức chỉnh lò. Gradient tương ứng hướng nhạy, optimizer tương ứng cách chọn bước sửa; phép so sánh không bảo đảm lần chỉnh nào cũng cải thiện mẻ sau.
2Luồng
Mã 3B, 3C khớp sơ đồ Tab 01. Giai đoạn 5 khớp Tab 02; ánh xạ không có nghĩa mọi kỹ thuật của ô đều được triển khai trong lab.
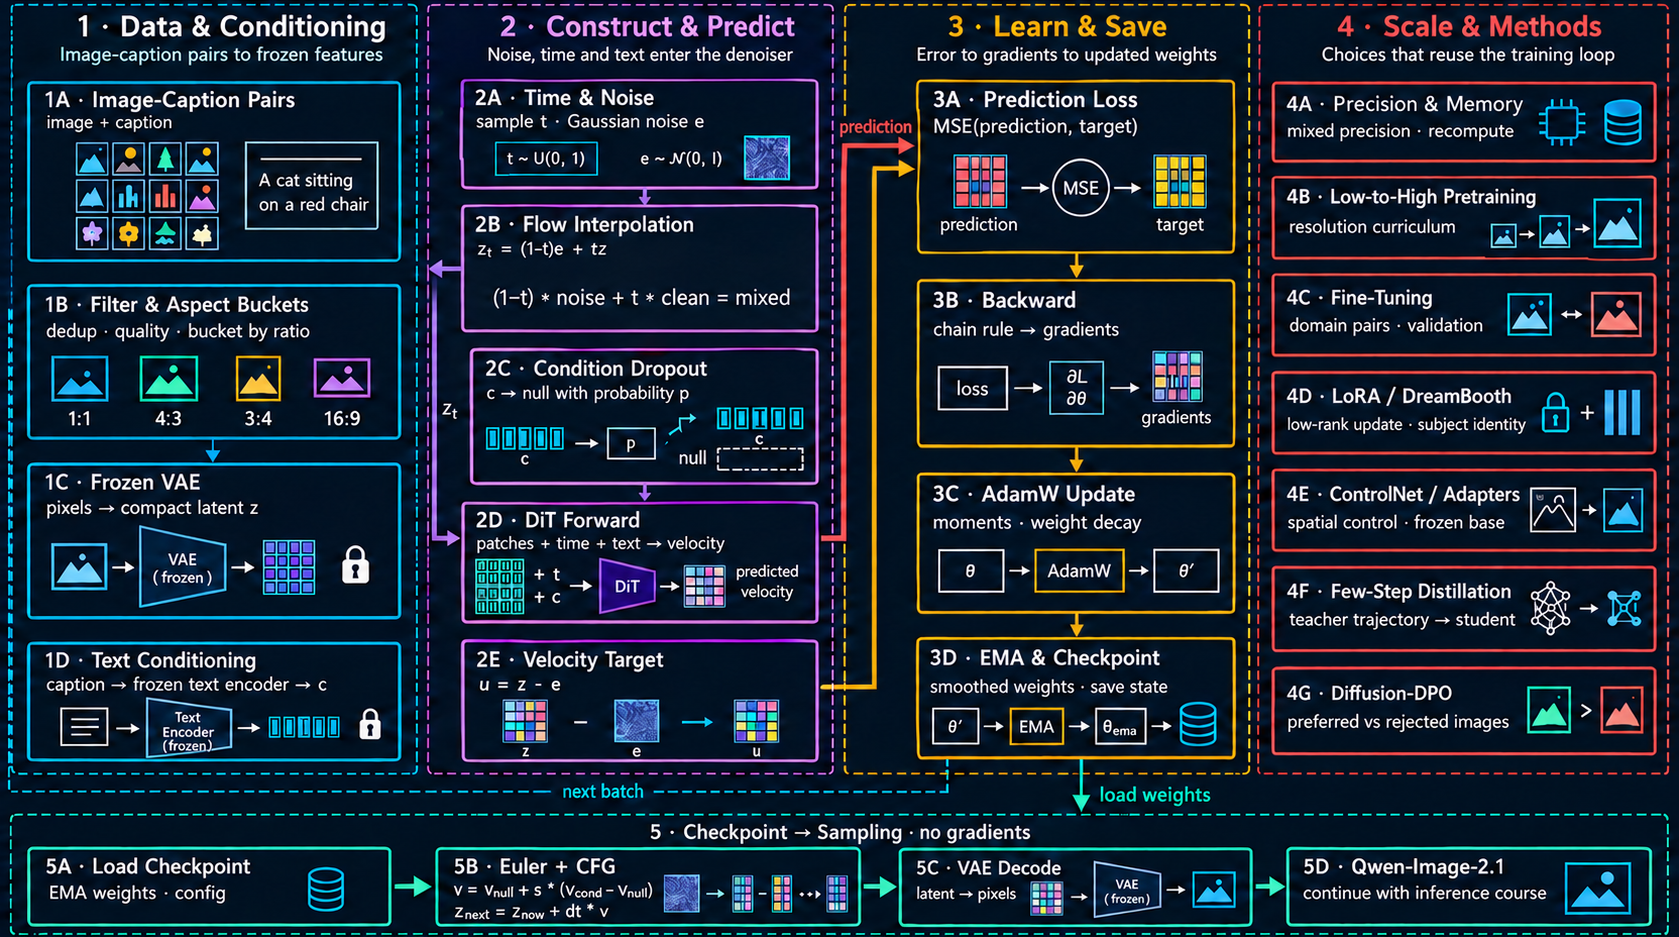
loss → đầu ra → các lớp → gradient3B · Lan truyền ngược
Tính độ nhạy của loss theo tham số để biết hướng sửa denoiser.
- Nhận gì
- Đạo hàm MSE theo dự đoán và các activation của forward tại 2D.
- Làm gì, vì sao
- Dùng quy tắc chuỗi đi ngược mạng, chỉ tạo gradient cho tham số được học; encoder đóng băng không cập nhật.
- Ra gì
- Các tensor gradient tới AdamW ở 3C; chuẩn gradient giúp phát hiện bất thường.
- Ví dụ, cách đọc ô
- Lab kiểm tra bốn phần tử bằng dịch ±1e−5; sai lệch lớn nhất khoảng 3,047e−11.
- Lưu ý
- Gradient đúng chưa chọn được learning rate; kiểm tra bốn phần tử không chứng minh mọi gradient.
- Nhận đầu vào
Backward là lượt áp dụng quy tắc chuỗi để tính độ nhạy của loss với từng tham số, còn AdamW là bộ tối ưu chuyển các gradient ấy thành bước thay đổi trọng số.
- Biến đổi và nối hệ thống
Đọc ô 3B, 3C và các bước giải thích bên dưới.
- Đối chiếu thực hành
Giai đoạn 5 của lab; xem bảng ánh xạ để phân biệt thực thi với phần chỉ giải thích.
Mã Mermaid
flowchart TD
  step1["Nhận đầu vào"]
  step2["Biến đổi và nối hệ thống"]
  step3["Đối chiếu thực hành"]
  step1 --> step2
step2 --> step33Giải pháp
Vị trí trên sơ đồ: 3B, 3C. Tiền đề: biết tensor/attention từ LLM Foundations và loss, gradient, AdamW từ LLM Training (Text); phần dưới nhắc lại kiến thức cần dùng tại chỗ.
Nhắc lại quy tắc chuỗi
Nếu một phép tính dùng đầu ra của phép trước thì độ nhạy phải đi qua cả hai. Với MLP của lab, đạo hàm tanh(h_pre) là 1−h²; gradient W2 dùng h chuyển vị nhân đạo hàm loss, gradient W1 đi tiếp qua W2 rồi tanh. Vì thế backward cần activation từ forward hoặc phải tính lại chúng.
AdamW sửa theo lịch sử
Gọi g là gradient, m là trung bình gradient, v là trung bình gradient bình phương. Hiệu chỉnh thiên lệch khi m,v khởi tạo zero rồi chia m_hat cho căn v_hat cộng số nhỏ ổn định. Trọng số được trừ learning rate nhân bước thích nghi, đồng thời trừ learning rate nhân weight decay nhân trọng số. Lab không decay bias; đây là lựa chọn khai báo, không quy tắc bắt buộc cho mọi mạng.
Dọn gradient giữa các bước trừ khi chủ ý tích lũy. Nếu tích lũy nhiều microbatch, chuẩn hóa theo số mẫu/tọa độ thật, không chỉ cộng các trung bình có kích thước khác nhau. Chỉ đưa tham số được học vào optimizer; gradient hữu hạn và đúng không có nghĩa learning rate phù hợp.
Kiểm tra nhỏ trước khi học dài
Giai đoạn 5 của Bài Lab tổng hợp chọn phần tử có gradient lớn nhất ở mỗi trong bốn tensor, dịch ±1e−5 và so độ dốc loss. Sai lệch lớn nhất 3,047e−11; một bước AdamW cho loss 1,998582 từ 2,098029. Phép kiểm tra áp dụng cho bốn phần tử ở batch ấy, không chứng minh mọi điểm.
4Profiling
- Gradient trước thông lượng
So sai phân ở float64 trên batch cố định; kiểm tra NaN/Inf và chuẩn gradient từng tensor. Sau khi đúng mới đo thời gian backward và bộ nhớ; bài không có benchmark GPU.
- Bước cập nhật
Theo dõi tỉ lệ chuẩn thay đổi trọng số trên chuẩn trọng số cùng loss kiểm định. Gradient lớn có thể do chuẩn hóa loss sai, không nên che bằng clipping trước khi tìm nguyên nhân.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Tự kiểm tra đóng băng
Nếu VAE không có gradient nhưng W2 đổi, vòng học có hợp lệ không? Có: encoder cung cấp biểu diễn cố định, denoiser vẫn học từ loss. Nếu W2 cũng không đổi, kiểm tra optimizer có chứa W2 và backward có tạo gradient không.
Dự đoán dấu
Minh họa SGD để nhắc lại: gradient dương 0,2 và learning rate 0,01 làm trọng số giảm 0,002. AdamW không nhất thiết giảm đúng lượng ấy vì có m,v và decay; dùng khối 5 để đọc thay đổi W1 lớn nhất 0,003017.
6Thuật ngữ
- Activation
- Giá trị trung gian của forward dùng lại khi tính backward.
- Weight decay
- Phần kéo trọng số về 0, tách khỏi bước thích nghi của AdamW.
Glossary (1)
- Giới hạn của mô hình thu nhỏ
- Số lab chỉ thuộc dữ liệu hình học và cấu hình đã nêu; không suy ra chất lượng ảnh tự nhiên hoặc hiệu năng GPU.