TI · Kiến trúc huấn luyện sinh ảnh
Loss hồi quy: ε, v và vận tốc cần được phân biệt
So dự đoán với đúng mục tiêu của lịch nhiễu bằng MSE, phân biệt nhiễu ε, tổ hợp v và vận tốc đường flow trước khi đọc loss.
1Định nghĩa
Loss hồi quy cho mô hình sinh ảnh đo dự đoán của denoiser lệch khỏi mục tiêu số bao nhiêu ở một trạng thái nhiễu. MSE (mean squared error, trung bình bình phương sai số) phạt mọi tọa độ sai và cung cấp đạo hàm để học, thay cho cross-entropy trên token.
Ô 3A ghép dự đoán từ forward DiT với target từ đường nhiễu. Target có thể là nhiễu ε, tổ hợp v theo lịch diffusion hoặc vận tốc u theo đường flow; shape giống nhau không làm chúng cùng ý nghĩa.
Ví dụ đời thường: Chấm một bài đo khoảng cách cần thống nhất đơn vị trước khi so kết quả. Một bạn ghi mét và một bạn ghi giây có thể viết số bằng nhau nhưng trả lời khác câu hỏi; ε, v và u cũng cần cùng hợp đồng với đầu ra và sampler.
2Luồng
Mã 3A khớp sơ đồ Tab 01. Giai đoạn 4 khớp Tab 02; ánh xạ không có nghĩa mọi kỹ thuật của ô đều được triển khai trong lab.
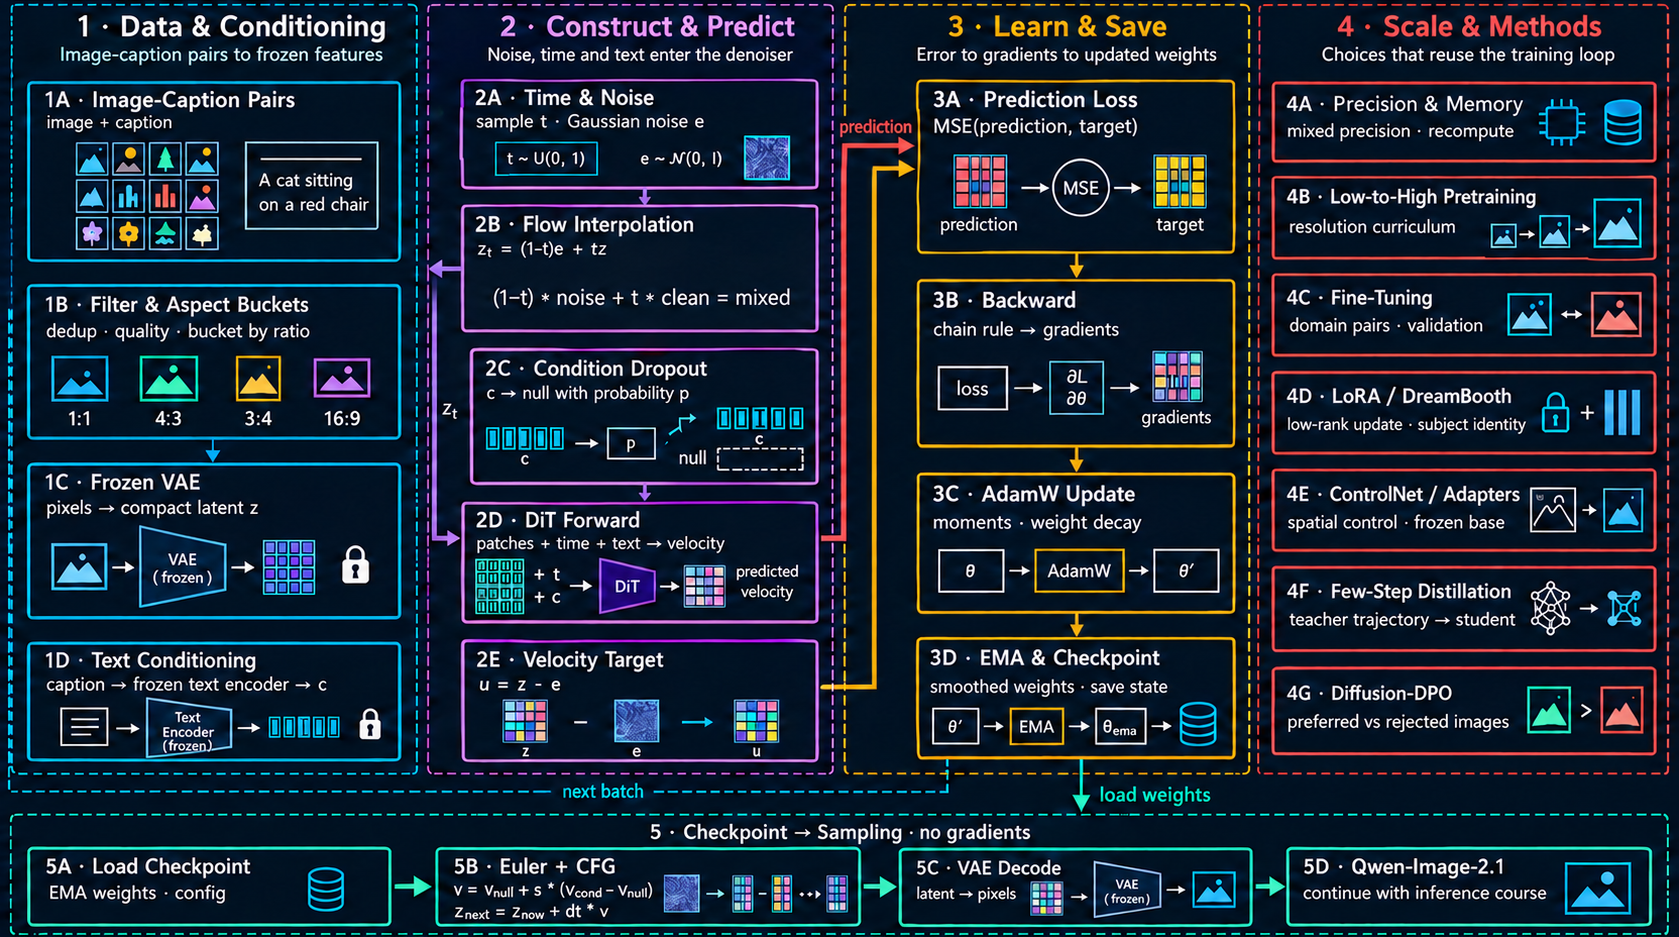
MSE(dự đoán, target)3A · Loss dự đoán
Gói sai số hồi quy thành scalar để bắt đầu tính gradient của denoiser.
- Nhận gì
- Dự đoán từ 2D và target u từ 2E, đã thống nhất lịch và chiều thời gian.
- Làm gì, vì sao
- Bình phương từng sai số rồi trung bình cả batch và tọa độ; MSE có đạo hàm để sửa trọng số.
- Ra gì
- Một scalar loss và độ nhạy theo đầu ra đi tới backward ở 3B.
- Ví dụ, cách đọc ô
- Lab: MSE đầu 2,098029; baseline dự đoán zero 1,970198 trên đúng các cặp kiểm định.
- Lưu ý
- MSE không đo thẩm mỹ; ε, v và u là mục tiêu khác nhau nên raw loss không so trực tiếp.
- Nhận đầu vào
Loss hồi quy cho mô hình sinh ảnh đo dự đoán của denoiser lệch khỏi mục tiêu số bao nhiêu ở một trạng thái nhiễu.
- Biến đổi và nối hệ thống
Đọc ô 3A và các bước giải thích bên dưới.
- Đối chiếu thực hành
Giai đoạn 4 của lab; xem bảng ánh xạ để phân biệt thực thi với phần chỉ giải thích.
Mã Mermaid
flowchart TD
  step1["Nhận đầu vào"]
  step2["Biến đổi và nối hệ thống"]
  step3["Đối chiếu thực hành"]
  step1 --> step2
step2 --> step33Giải pháp
Vị trí trên sơ đồ: 3A. Tiền đề: biết tensor/attention từ LLM Foundations và loss, gradient, AdamW từ LLM Training (Text); phần dưới nhắc lại kiến thức cần dùng tại chỗ.
Nhắc lại MSE và đạo hàm
Với N tọa độ được chấm, loss là tổng (prediction−target)² chia N; đạo hàm theo prediction là 2·(prediction−target)/N. Lab lấy N bằng batch nhân 16 pixel, nên nhân đôi batch mà giữ phân phối không cố ý nhân đôi độ lớn gradient. Loss có trọng số theo t phải khai báo cả cách lấy t và cách chuẩn hóa.
Ba mục tiêu không đồng nghĩa
Ở diffusion bảo toàn phương sai (VP, variance-preserving) với x_t=α_t·z+σ_t·ε — trong đó α_t là hệ số tín hiệu sạch và σ_t là hệ số nhiễu thỏa α_t²+σ_t²=1 — ε-prediction học lại nhiễu ε đã rút; v-prediction học tổ hợp vận tốc góc v=α_t·ε−σ_t·z. Đây là phép quay giữa ảnh sạch z và nhiễu ε theo lịch (α_t, σ_t), không mặc định bằng đạo hàm đường thẳng theo t. Muốn đổi từ ε hoặc v sang hàm điểm (score, tức gradient theo x_t của log mật độ xác suất tại thời điểm t) hay sang trường vận tốc để lấy mẫu thì phải nhân chia đúng hệ số α_t, σ_t và đạo hàm lịch của chúng.
Ở flow tuyến tính của khóa, u=z−e là đạo hàm của (1−t)e+t·z. Nếu viết denoiser v_theta trong code, chữ v ấy chỉ là tên hàm; nó không biến target thành v-prediction của VP. MSE dùng được vì đã biết đáp án cho từng cặp, có đạo hàm liên tục và nghiệm kỳ vọng có điều kiện; nó không tự đo độ đẹp.
Đọc số cùng thước đo
Giai đoạn 4 của Bài Lab tổng hợp cho MSE ban đầu 2,098029; dự đoán zero cho 1,970198 trên đúng các cặp ấy. Khởi tạo ngẫu nhiên hơi tệ hơn zero là hợp lý. Sau học, so lại đúng batch kiểm định; đừng lấy minibatch mới để khẳng định một bước chắc chắn giảm.
Loss thấp chỉ nói dự đoán target tốt trên phân phối được chấm. Không so raw MSE ε với MSE u như cùng đơn vị, không gọi MSE nhỏ là likelihood ảnh chính xác, và không thay đánh giá bám prompt/thẩm mỹ bằng duy nhất một scalar.
4Profiling
- Baseline số học
So một tọa độ tính tay và gradient với sai phân hữu hạn trước khi tối ưu. Ghi t, trọng số loss, số tọa độ và dtype cùng baseline để biết chênh lệch đến từ mô hình hay cách chấm.
- Kiểm định theo t và điều kiện
Báo MSE theo vùng t và có/rỗng điều kiện; một vùng được gặp nhiều có thể che vùng khác đang tệ. Dùng ảnh chưa học và nhiều seed trước khi kết luận tổng quát hóa.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Tính tay gradient
Minh họa một tọa độ: dự đoán 0,3 và target −1,4 cho bình phương sai số 2,89, đạo hàm 3,4 nếu N=1. Với N=16 thì đóng góp vào loss là 2,89/16 và đạo hàm 3,4/16. Đây là ví dụ số học, không phải số đo lab.
Tự kiểm tra tên biến
Nếu đổi tên u thành v nhưng giữ target z−e, ta đã chuyển sang v-prediction chưa? Chưa: phương trình target và lịch mới xác định bài toán. Kiểm tra hai đầu và công thức sampler trước khi đổi checkpoint.
6Thuật ngữ
- ε-prediction
- Học dự đoán nhiễu được dùng khi tạo trạng thái diffusion.
- v-prediction
- Học tổ hợp α_t·ε−σ_t·z trong lịch khuếch tán bảo toàn phương sai (VP, variance-preserving, nơi α_t là hệ số tín hiệu sạch và σ_t là hệ số nhiễu); khác vận tốc flow tuyến tính.
Glossary (1)
- Giới hạn của mô hình thu nhỏ
- Số lab chỉ thuộc dữ liệu hình học và cấu hình đã nêu; không suy ra chất lượng ảnh tự nhiên hoặc hiệu năng GPU.