TI · Kiến trúc huấn luyện sinh ảnh
DiT forward: latent, thời gian và chữ cùng dự đoán
Dùng Transformer trên các mảnh latent, đưa thời gian và điều kiện chữ vào từng khối để dự đoán đại lượng gỡ nhiễu cùng shape với latent.
1Định nghĩa
Diffusion Transformer (DiT) là denoiser dùng các khối Transformer để xử lý những mảnh của latent ảnh. Forward của nó nhận trạng thái ảnh nhiễu, tọa độ thời gian và điều kiện rồi trả dự đoán cùng lưới với latent, không trả bảng điểm token từ vựng.
Sau khi chia latent thành patch, phép chiếu tạo vector cho từng vị trí, attention trộn thông tin, mạng truyền thẳng biến đổi từng vector và đường residual cộng tín hiệu cũ. Thời gian cùng điều kiện chữ điều khiển phép biến đổi; đầu ra được ghép về lưới để loss hồi quy so với mục tiêu.
Ví dụ đời thường: Các họa sĩ phụ trách từng ô của một bức tranh, trao đổi thông tin để nét liền mạch và cùng đọc phiếu yêu cầu cùng mức hoàn thành. Họ sửa các ô đồng thời, không viết một chuỗi ký tự lần lượt; ví dụ chỉ mô tả luồng thông tin chứ không đo năng lực hội họa.
2Luồng
Mã 2D khớp sơ đồ Tab 01. Giai đoạn 3 khớp Tab 02; ánh xạ không có nghĩa mọi kỹ thuật của ô đều được triển khai trong lab.
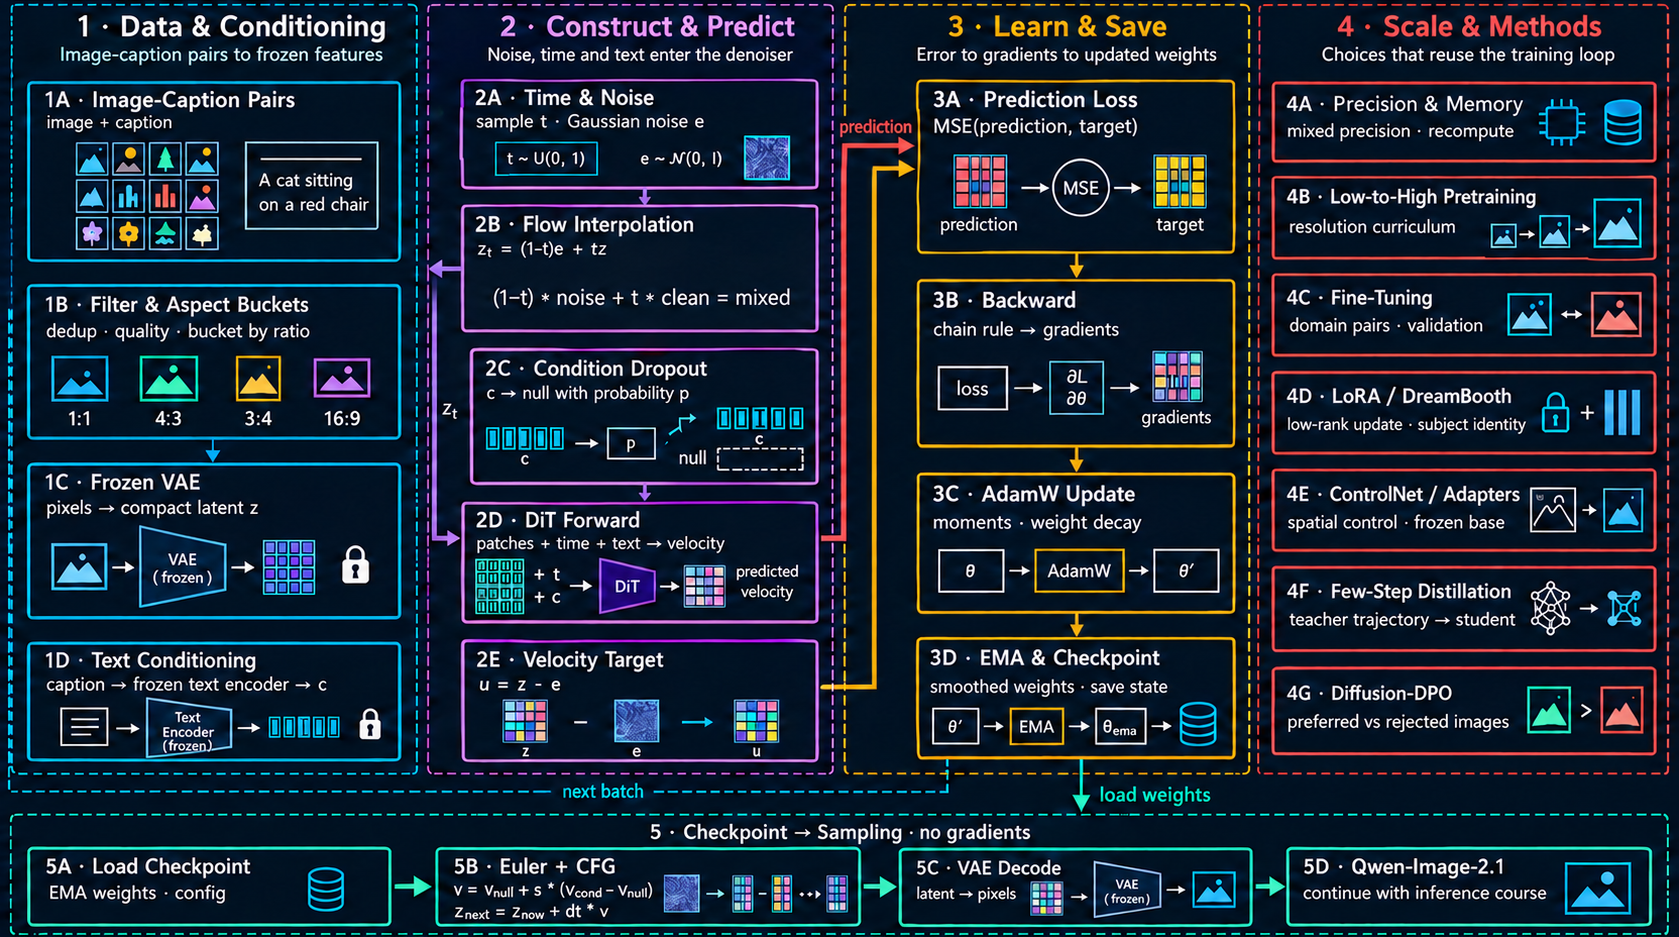
ảnh nhiễu + thời gian + chữ → dự đoán2D · Forward DiT
Denoiser dùng trạng thái hiện tại và điều kiện để dự đoán vector giúp đi về ảnh sạch.
- Nhận gì
- z_t từ 2B, t từ 2A và điều kiện sau 2C, không nhận target u.
- Làm gì, vì sao
- DiT chia latent thành patch, dùng attention và mạng truyền thẳng cùng điều biến thời gian/chữ rồi ghép về lưới.
- Ra gì
- Dự đoán vận tốc cùng shape latent sang 3A để so với đáp án từ 2E.
- Ví dụ, cách đọc ô
- Lab dùng MLP thay DiT: 19 số đầu vào→48 số ẩn→16 vận tốc, tổng 1.744 tham số.
- Lưu ý
- Lab không kiểm chứng attention; token ảnh là vector patch, không phải token từ vựng cần lấy mẫu.
- Nhận đầu vào
Diffusion Transformer (DiT) là denoiser dùng các khối Transformer để xử lý những mảnh của latent ảnh.
- Biến đổi và nối hệ thống
Đọc ô 2D và các bước giải thích bên dưới.
- Đối chiếu thực hành
Giai đoạn 3 của lab; xem bảng ánh xạ để phân biệt thực thi với phần chỉ giải thích.
Mã Mermaid
flowchart TD
  step1["Nhận đầu vào"]
  step2["Biến đổi và nối hệ thống"]
  step3["Đối chiếu thực hành"]
  step1 --> step2
step2 --> step33Giải pháp
Vị trí trên sơ đồ: 2D. Tiền đề: biết tensor/attention từ LLM Foundations và loss, gradient, AdamW từ LLM Training (Text); phần dưới nhắc lại kiến thức cần dùng tại chỗ.
Nhắc lại patch và token ảnh
Patch là mảnh không gian có nhiều kênh latent. Token ảnh là vector sau chiếu patch, khác token chữ trong tokenizer; đừng trộn số token ảnh với số từ. Nếu lưới latent lớn gấp đôi mỗi chiều và patch giữ nguyên, số token ảnh tăng bốn lần; attention đầy đủ trên N vị trí có bảng tương tác N×N.
Gắn điều kiện đúng kiến trúc
Ô 2D nhận z_t từ 2B, t từ 2A, chữ có/rỗng từ 2C. Timestep embedding biến t thành vector; có thể dùng vector này để scale/shift chuẩn hóa trong khối, gọi là adaptive layer norm. Text có thể vào qua cross-attention hoặc attention chung. Bài DiT gốc trình bày điều kiện lớp; text-to-image cần cơ chế nối chữ rõ ràng, không tự có chỉ vì gọi mạng là DiT.
Ở đầu ra, unpatchify ghép các vector thành tensor dự đoán theo vị trí. Với velocity target của khóa, số giá trị dự đoán bằng số tọa độ latent; mạng không được nhìn thấy target u trong forward. Cả học và sampling dùng cùng forward, nhưng chỉ học mới lưu activation để backward.
Phép thay thế để tự tính gradient
Giai đoạn 3 của Bài Lab tổng hợp dùng MLP: đầu vào 128×19, tầng ẩn 128×48, đầu ra 128×16 với 1.744 tham số. Mỗi hàng là một mẫu, mỗi cột là một số; 19 gồm 16 pixel, một t và hai điều kiện. Nó giữ giao diện denoiser nhưng không có patch attention hay adaptive norm.
4Profiling
- Kiểm tra shape và rò rỉ
Chạy một batch nhỏ, kiểm tra đầu ra đúng shape target, đổi t/điều kiện riêng và xem dự đoán đổi. Loss giảm không thay cho kiểm tra target không lọt vào input.
- Chi phí theo token ảnh
Cố định batch, precision và cơ chế attention rồi tăng số token để đo bộ nhớ đỉnh và thời gian forward/backward riêng. Quan hệ N² là đếm phần tử bảng attention, không phải số đo thời gian toàn mô hình.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Tự kiểm tra trục
Minh họa: latent 8×8 chia patch 2×2 cho 16 token ảnh. Nếu tăng latent lên 16×16 vẫn patch 2×2 thì có 64 token. Vì sao không phải 32? Cả chiều cao lẫn chiều rộng đều tăng gấp đôi.
Đọc baseline lab
Vận tốc đầu của forward chưa học là 0,309156, target đầu −1,423406. Khác dấu có phải lỗi shape không? Chưa chắc: trọng số ngẫu nhiên chưa được dạy; cần kiểm tra shape và gradient rồi mới học.
6Thuật ngữ
- Patchify
- Chia latent thành mảnh và chiếu mỗi mảnh ra vector token ảnh.
- Denoiser
- Mạng dự đoán đại lượng cần để đi từ trạng thái nhiễu về ảnh.
Glossary (1)
- Giới hạn của mô hình thu nhỏ
- Số lab chỉ thuộc dữ liệu hình học và cấu hình đã nêu; không suy ra chất lượng ảnh tự nhiên hoặc hiệu năng GPU.