TI · Kiến trúc huấn luyện sinh ảnh
Tinh chỉnh miền: giữ nền và học dữ liệu mới
Tiếp tục huấn luyện từ checkpoint nền trên cặp ảnh–chú thích của miền mới, kiểm tra học thuộc và khả năng sinh nội dung cũ.
1Định nghĩa
Fine-tuning sinh ảnh là tiếp tục cập nhật một checkpoint đã học để thích nghi với dữ liệu hoặc yêu cầu mới. Nó khác pretraining ở điểm khởi đầu và phạm vi dữ liệu, không nhất thiết dùng loss hoàn toàn khác.
Từ checkpoint nền, giữ hợp đồng VAE, encoder chữ, lịch nhiễu và target, rồi học trên cặp ảnh–chú thích miền đích. Có thể học toàn denoiser hoặc chỉ adapter LoRA; lựa chọn tham số là quyết định tách biệt với mục tiêu miền.
Ví dụ đời thường: Họa sĩ đã biết vẽ cảnh học thêm phong cách minh họa sách. Nếu chỉ chép vài trang, người ấy có thể quên tính linh hoạt của nền; mô hình cũng cần kiểm tra cả miền mới lẫn các yêu cầu cũ.
2Luồng
Mã 4C khớp sơ đồ Tab 01. Giai đoạn 10 khớp Tab 02; ánh xạ không có nghĩa mọi kỹ thuật của ô đều được triển khai trong lab.
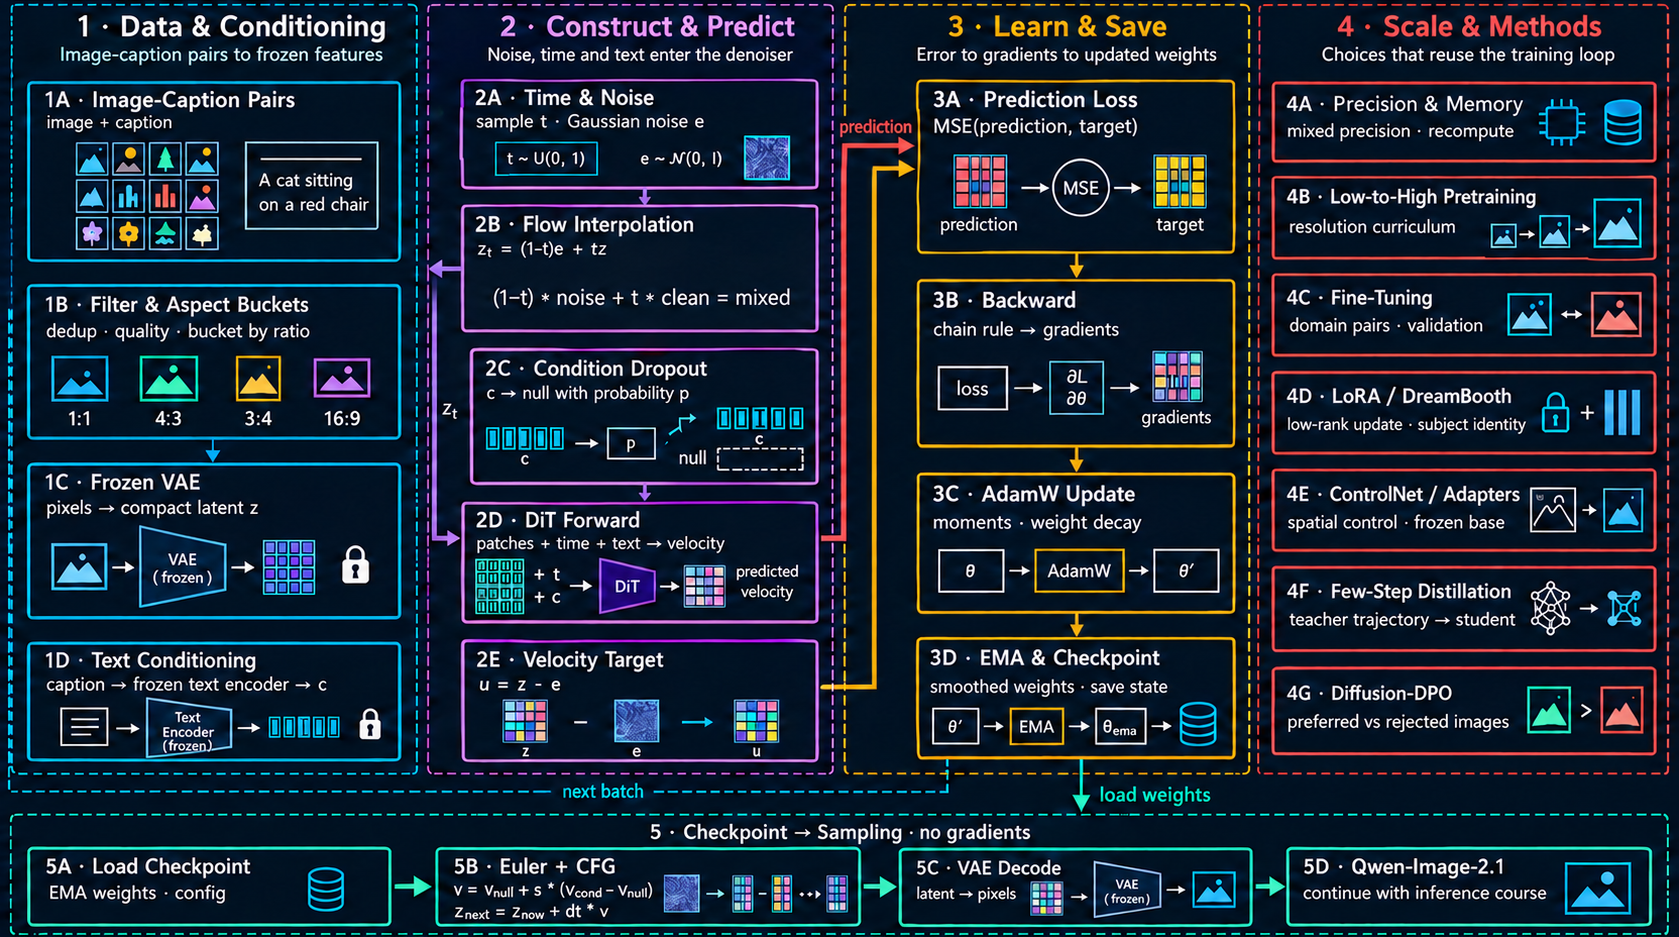
checkpoint nền + dữ liệu miền đích4C · Tinh chỉnh miền
Tiếp tục học từ mô hình nền để thích nghi yêu cầu mới, theo dõi cả miền cũ.
- Nhận gì
- Checkpoint nền và cặp ảnh–chú thích mới đã chia kiểm định theo nguồn/chủ thể.
- Làm gì, vì sao
- Dùng lại vòng hồi quy, chọn học toàn denoiser hoặc adapter và kiểm tra khả năng nền có bị quên không.
- Ra gì
- Checkpoint chuyên biệt cho miền, so baseline bằng cùng prompt/seed trước khi chọn.
- Ví dụ, cách đọc ô
- Lab chỉ có nhánh LoRA chuyển nét mảnh sang nét dày ở khối 8; không full fine-tuning riêng.
- Lưu ý
- Loss train giảm chưa chứng minh bối cảnh mới đúng; phần full fine-tuning chỉ được giải thích.
- Nhận đầu vào
Fine-tuning sinh ảnh là tiếp tục cập nhật một checkpoint đã học để thích nghi với dữ liệu hoặc yêu cầu mới.
- Biến đổi và nối hệ thống
Đọc ô 4C và các bước giải thích bên dưới.
- Đối chiếu thực hành
Giai đoạn 10 của lab; xem bảng ánh xạ để phân biệt thực thi với phần chỉ giải thích.
Mã Mermaid
flowchart TD
  step1["Nhận đầu vào"]
  step2["Biến đổi và nối hệ thống"]
  step3["Đối chiếu thực hành"]
  step1 --> step2
step2 --> step33Giải pháp
Vị trí trên sơ đồ: 4C. Tiền đề: biết tensor/attention từ LLM Foundations và loss, gradient, AdamW từ LLM Training (Text); phần dưới nhắc lại kiến thức cần dùng tại chỗ.
Nhắc lại rò rỉ và baseline
Đầu tiên sinh ảnh từ checkpoint gốc với bộ prompt miền đích và bộ prompt kiểm tra nền. Tách ảnh kiểm định theo chủ thể hoặc nguồn, không để crop của cùng ảnh nằm ở hai tập. Dữ liệu ít làm loss train đẹp rất nhanh nhưng chưa nói mô hình giữ được nội dung ở bối cảnh mới.
Giữ một hợp đồng kỹ thuật
Kiểm tra prediction type, scale latent, biểu diễn null và encoder của checkpoint trước khi học tiếp. Đổi encoder khi vẫn dùng latent/text embedding cache cũ có thể tạo đầu vào không tương thích. Bắt đầu bằng khả năng tái tạo baseline trên một batch nhỏ để tránh đổ lỗi cho dữ liệu mới khi cấu hình đã sai.
Chọn full fine-tuning khi cần nhiều tự do và đủ ngân sách; chọn LoRA khi muốn giảm trạng thái gradient/optimizer của tham số nền. Learning rate nhỏ hơn chỉ là điểm xuất phát thường thử, không bảo đảm tránh quên; kiểm định theo tiến trình để chọn số bước và xem có cần trộn dữ liệu nền hay dừng sớm.
Khóa học thực thi tới đâu
Trong Bài Lab tổng hợp, giai đoạn 8 dùng LoRA chuyển từ nét mảnh sang nét dày. Nó minh họa tinh chỉnh một miền số học nhỏ; ô 4C ở giai đoạn 10 không có một lần full fine-tuning độc lập hay đánh giá ảnh tự nhiên.
4Profiling
- Hai bộ kiểm định
Đo loss và sinh ảnh cùng prompt/seed ở miền đích và miền nền trước/sau. Nếu miền đích tốt lên nhưng nền hỏng, cần báo đánh đổi thay vì chỉ gọi là cải thiện chung.
- Tỉ lệ tham số và chi phí
Báo tham số học được, dung lượng optimizer, bước học và batch; không suy ra peak GPU hay tốc độ từ số tham số adapter đơn thuần.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Bài tập lập tiêu chí
Với miền ảnh sản phẩm, đề xuất ba prompt chưa học về màu, bố cục và nền. Tự kiểm tra vì sao không chỉ dùng lại đúng caption của ảnh train: cần kiểm tra kết hợp mới chứ không chỉ nhớ ảnh.
Tách phương pháp khỏi mục tiêu
LoRA và full fine-tuning có thể cùng học miền nét dày không? Có. Chúng khác tập tham số được sửa, còn dữ liệu mới và mục tiêu hồi quy có thể giữ nguyên.
6Thuật ngữ
- Catastrophic forgetting
- Việc học dữ liệu mới làm suy giảm khả năng đã có ở miền cũ.
- Full fine-tuning
- Cập nhật toàn bộ tham số được chọn của denoiser thay vì chỉ adapter nhỏ.
Glossary (1)
- Giới hạn của mô hình thu nhỏ
- Số lab chỉ thuộc dữ liệu hình học và cấu hình đã nêu; không suy ra chất lượng ảnh tự nhiên hoặc hiệu năng GPU.