TI · Kiến trúc huấn luyện sinh ảnh
LoRA và DreamBooth: tham số nhỏ, mục tiêu cá nhân hóa
Phân biệt LoRA là cập nhật hạng thấp với DreamBooth là dạy định danh chủ thể; kiểm tra adapter gộp đúng và trọng số gốc giữ nguyên.
1Định nghĩa
LoRA (low-rank adaptation, thích nghi hạng thấp) học phần cập nhật của ma trận bằng hai ma trận nhỏ, còn DreamBooth tổ chức dữ liệu và mục tiêu để gắn một định danh với chủ thể cụ thể. Hai ý tưởng có thể kết hợp nhưng không phải tên khác của cùng phương pháp.
Trong tinh chỉnh, LoRA giữ W0 cố định và học ΔW=A·B; forward dùng W0+ΔW. DreamBooth dùng ảnh chủ thể, định danh và có thể thêm ví dụ lớp chung để giữ prior, tức kiến thức chung về lớp, trong khi vẫn dùng cơ chế loss gỡ nhiễu.
Ví dụ đời thường: LoRA giống một bộ chỉ dẫn sửa nhỏ gắn vào quy trình vẽ có sẵn, còn DreamBooth giống đề bài “hãy vẽ đúng chiếc cốc này trong nhiều cảnh”. Có thể dùng bộ sửa nhỏ cho đề bài ấy, nhưng bản thân bộ sửa không quy định phải học chiếc cốc nào.
2Luồng
Mã 4D khớp sơ đồ Tab 01. Giai đoạn 8 khớp Tab 02; ánh xạ không có nghĩa mọi kỹ thuật của ô đều được triển khai trong lab.
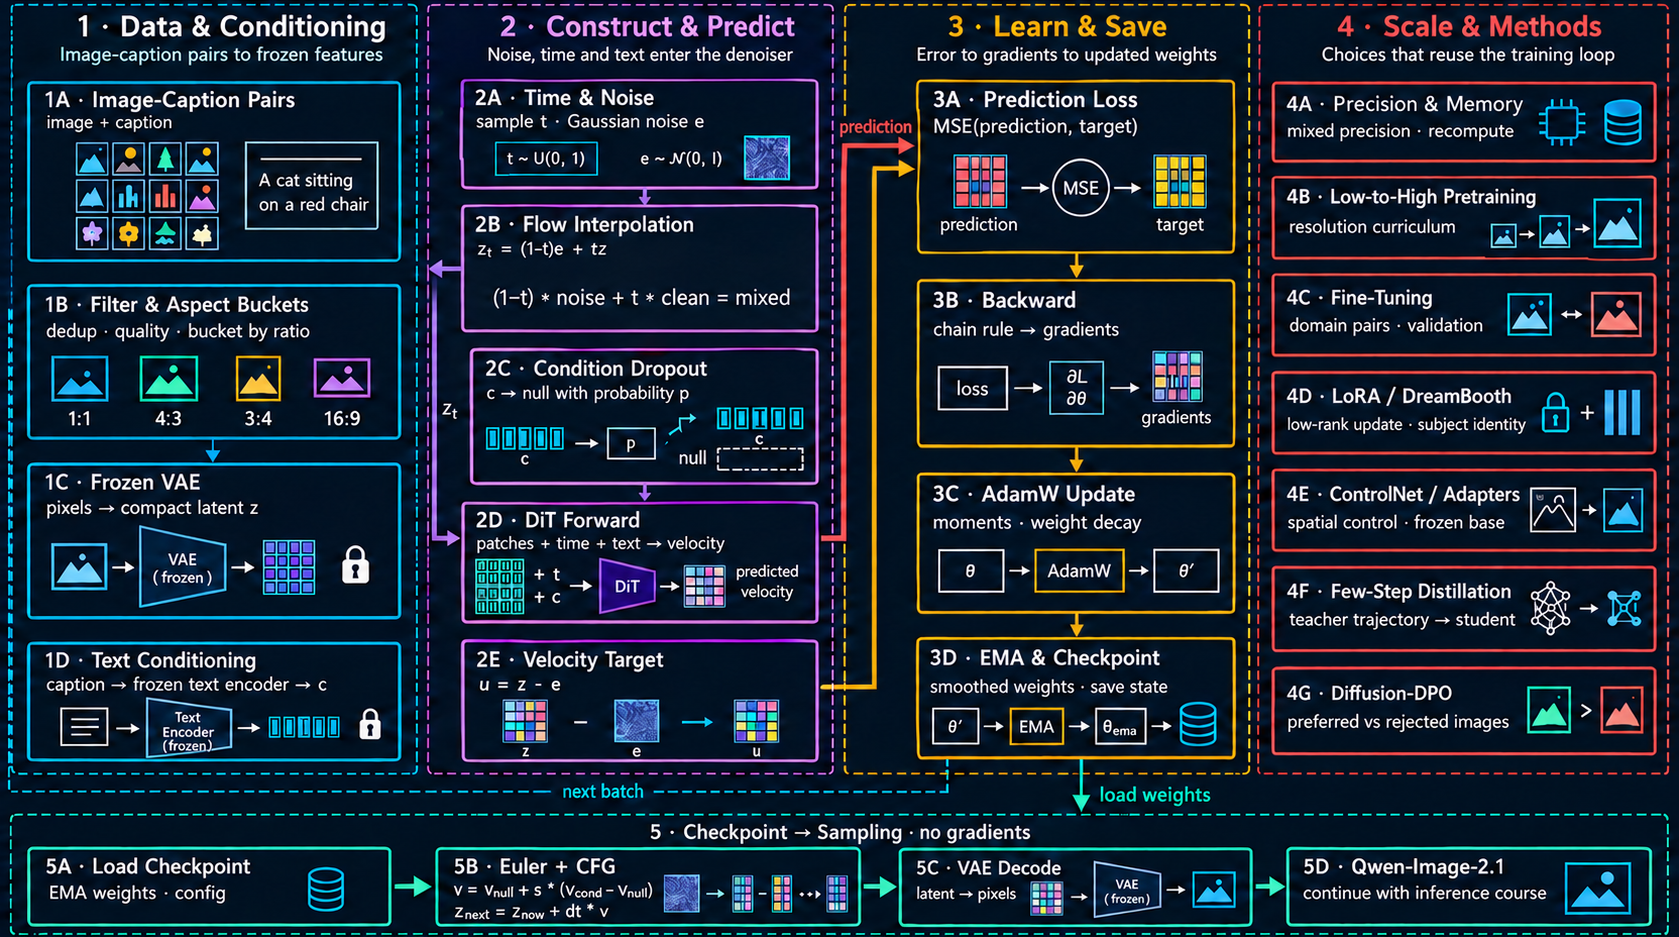
W0+A·B · định danh chủ thể4D · LoRA và DreamBooth
Phân biệt tham số hạng thấp với mục tiêu học một chủ thể cụ thể.
- Nhận gì
- Mô hình nền cùng dữ liệu miền mới hoặc ảnh chủ thể gắn định danh riêng.
- Làm gì, vì sao
- LoRA chỉ học hai ma trận A,B và giữ W0; DreamBooth tổ chức mục tiêu cá nhân hóa, có thể dùng LoRA hoặc học toàn mạng.
- Ra gì
- Adapter có thể gộp vào denoiser hoặc checkpoint đã học chủ thể, tùy phương pháp được chọn.
- Ví dụ, cách đọc ô
- Lab LoRA hạng 2 học 128 số; loss nét dày 3,201654→0,275528 và giữ nền lệch 0.
- Lưu ý
- DreamBooth không được chạy trong lab; không gọi LoRA bất kỳ là DreamBooth hay kết luận chất lượng cá nhân hóa.
- Nhận đầu vào
LoRA (low-rank adaptation, thích nghi hạng thấp) học phần cập nhật của ma trận bằng hai ma trận nhỏ, còn DreamBooth tổ chức dữ liệu và mục tiêu để gắn một định danh với chủ thể cụ thể.
- Biến đổi và nối hệ thống
Đọc ô 4D và các bước giải thích bên dưới.
- Đối chiếu thực hành
Giai đoạn 8 của lab; xem bảng ánh xạ để phân biệt thực thi với phần chỉ giải thích.
Mã Mermaid
flowchart TD
  step1["Nhận đầu vào"]
  step2["Biến đổi và nối hệ thống"]
  step3["Đối chiếu thực hành"]
  step1 --> step2
step2 --> step33Giải pháp
Vị trí trên sơ đồ: 4D. Tiền đề: biết tensor/attention từ LLM Foundations và loss, gradient, AdamW từ LLM Training (Text); phần dưới nhắc lại kiến thức cần dùng tại chỗ.
Nhắc lại hạng và chiều ma trận
Với input là vector hàng và W có chiều d_in×d_out, chọn A có chiều d_in×r, B có chiều r×d_out. r là số chiều trung gian, gọi là hạng adapter; số tham số là r·(d_in+d_out) thay cho d_in·d_out. Trong quy ước vector cột thường thấy W+B·A; phải đọc shape thay vì sao chép thứ tự.
Học ít tham số rồi gộp
Khởi tạo A nhỏ ngẫu nhiên và B=0 giúp ΔW ban đầu bằng 0. Gradient đầu tiên của A bằng 0 khi B=0 nhưng B vẫn có gradient; sau đó cả hai có thể học. Lab dùng hệ số alpha/r bằng 1; nếu công cụ dùng scaling khác, gộp phải tính cả hệ số ấy. Không sửa W0 trong optimizer khi muốn kiểm chứng đóng băng.
Giai đoạn 8 của Bài Lab tổng hợp đặt adapter vào W2 kích thước 48×16 với r=2: 128 tham số trên nền 1.744. MSE nét dày 3,201654 → 0,275528; trọng số gốc lệch 0 và đầu ra gộp/chưa gộp lệch cỡ 3e−15. Số này kiểm tra thích nghi nét dày, không phải nhận diện người hay sản phẩm.
DreamBooth cần kiểm tra chủ thể và lớp
Định danh hiếm đi cùng tên lớp giúp chỉ đúng chủ thể, ví dụ một mã riêng cho chiếc cốc. Prior preservation dùng ví dụ lớp để tránh thu hẹp mọi “cốc” thành đúng một chiếc. Kiểm tra bối cảnh mới, góc nhìn mới và khả năng vẽ các cốc khác; có thể học cả encoder chữ trong một công thức riêng nhưng phải khai báo. Lab không thực hiện mục tiêu DreamBooth.
4Profiling
- Độ đúng adapter
So forward gốc với adapter zero, kiểm tra gốc không đổi và gộp/chưa gộp cùng input. Kiểm tra dtype khi gộp vì làm tròn có thể thay số.
- Tổng quát hóa cá nhân hóa
Tách ảnh chủ thể kiểm định và prompt lớp chung; theo dõi bám chủ thể lẫn khả năng đổi cảnh. Loss thấp trên ảnh đã học không nói chủ thể giữ tốt ở mọi góc.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Giảm hạng
Sửa LORA_RANK=1: adapter còn 64 số, loss nét dày sau học là 1,330747 thay vì 0,275528 ở hạng 2. Đây là quan sát một seed; rank lớn hơn tăng khả năng biểu diễn nhưng không bảo đảm luôn tốt hơn.
Tự kiểm tra không đồng nghĩa
Một LoRA học phong cách tranh không có định danh chủ thể có phải DreamBooth không? Không. Ngược lại DreamBooth có thể dùng full fine-tuning mà không hề có adapter hạng thấp.
6Thuật ngữ
- Rank
- Chiều trung gian r của tích hai ma trận adapter.
- Prior preservation
- Giữ khả năng biểu diễn lớp chung trong khi gắn định danh với chủ thể.
Glossary (1)
- Giới hạn của mô hình thu nhỏ
- Số lab chỉ thuộc dữ liệu hình học và cấu hình đã nêu; không suy ra chất lượng ảnh tự nhiên hoặc hiệu năng GPU.