Giới thiệu khóa học
LLM Training (Audio): ba nhánh học từ tiếng nói
Bạn đã học Transformer, dự đoán token kế tiếp và vòng huấn luyện trong LLM Foundations và LLM Training (Text). Nhắc lại phần cần dùng: cross-entropy chấm −ln xác suất nhãn đúng; gradient cho biết loss nhạy với từng trọng số ra sao; AdamW dùng gradient để chọn bước cập nhật. Khóa Intermediate này nối các ý đó với audio.
Sóng audio là dãy mẫu biên độ theo thời gian. Muốn mô hình ngôn ngữ sinh tiếng nói, ta có thể học một neural codec biến sóng thành mã rời rạc, rồi dạy LM dự đoán mã kế tiếp. Muốn nhận dạng tiếng nói, ta học chiều audio → chữ. Sơ đồ tách hai mục tiêu đó khỏi việc học codec tái tạo sóng để bạn biết mỗi loss đang sửa điều gì.
Khóa học gồm
- 16 bài kiến trúc và một sơ đồ 22 ô: dữ liệu chung ở cột 1 rẽ sang codec RVQ ở cột 2, TTS (text-to-speech: chữ thành tiếng nói) ở cột 3 và ASR (automatic speech recognition: nhận dạng tiếng nói tự động) ở phần trên cột 4. RVQ là lượng tử hóa phần dư: mỗi bảng mã bù phần vector mà bảng trước còn thiếu.
- Cột 4 còn có backward–AdamW, bộ nhớ và lựa chọn pretraining/SFT. Băng 5 gồm thích nghi giọng bằng LoRA (chỉ học ma trận nhỏ), distillation (student học teacher), preference (học từ bản nói được chọn/bị loại) và cầu sang streaming.
- Một lab NumPy tám giai đoạn trên tone tổng hợp: đặc trưng Mel, codec tuyến tính học tái tạo, LM nhỏ học codec token và ASR theo khung. Lab ghi rõ cơ chế nào chỉ được giải thích, chưa thực thi.
Học xong, bạn có thể
- Nói rõ codec nhận sóng và học tái tạo, TTS nhận chữ/giọng và học mã, ASR nhận audio và học chữ; không nối chúng thành ba bước liên tiếp.
- Giải thích vì sao RVQ cần đạo hàm thay thế khi học encoder, vì sao c0 không tự là mã ngữ nghĩa và vì sao teacher forcing khác sinh tự hồi quy.
- Đọc loss theo codebook, căn chỉnh CTC, số khung/giây và ngân sách bộ nhớ; phân biệt chất lượng, tính đúng số học và độ trễ thực đo.
- Chọn bài học theo ô, chạy lab và diễn giải con số cùng giới hạn; nối checkpoint sang khóa suy luận Qwen3-Omni & Qwen3-TTS.
Phạm vi: huấn luyện mô hình tiếng nói quanh backbone mô hình ngôn ngữ: neural codec RVQ, TTS và câu trả lời bằng giọng nói qua dự đoán codec token kế tiếp, ASR audio-to-text. Đây là phần huấn luyện đối ứng với khóa Qwen3-Omni & Qwen3-TTS vốn chỉ dạy kiến trúc và suy luận. Nhạc và âm thanh không phải tiếng nói chỉ được nhắc tới, không được giảng dạy.
Cách đọc sơ đồ
- Bắt đầu ở
1A: audio đi kèm transcript và thông tin người nói.1Bchuẩn hóa sample rate, cắt đoạn và lọc sai khớp. Từ đây rẽ nhánh; số cột là thứ tự học, không phải một pipeline duy nhất. - Nhánh codec: sóng →
2Aencoder →2BRVQ →2Cdecoder →2Dloss tái tạo/commitment.2Etheo dõi mã hoạt động, là chẩn đoán của RVQ. Vòng gradient sửa codec rồi lặp. - Nhánh TTS:
3Achữ và mẫu giọng →3Bbackbone dự đoán mã đầu →3Ccác mã còn lại →3DCE theo mã. Mũi tên từ RVQ mang nhãn codec token; không mang transcript. Vai trò ngữ nghĩa của mã đầu phải được dạy bằng mục tiêu thích hợp. - Nhánh ASR:
1CMel →1Dencoder →4Ađầu chữ →4Bcăn chỉnh và loss.4Clà vòng cập nhật dùng lại cho từng nhánh, không bắt buộc cộng ba loss;4D,4E,5A,5Blà kỹ thuật hoặc lựa chọn học. 5Ckiểm hợp đồng nhân quả và khung thời gian;5Dlưu/nạp codec, LM và cấu hình để suy luận. Di chuột hoặc Tab lên ô để đọc năm phần, bấm mở bài. Tắt overlay cạnh Vừa khung để xem ảnh gốc; sang Tab 02 để chạy lab.
Các cơ chế thực tế ở sơ đồ rộng hơn lab: lab không huấn luyện CTC, SFT hội thoại, LoRA, distillation hay preference. Bảng ánh xạ ghi mức thực thi cho từng ô.
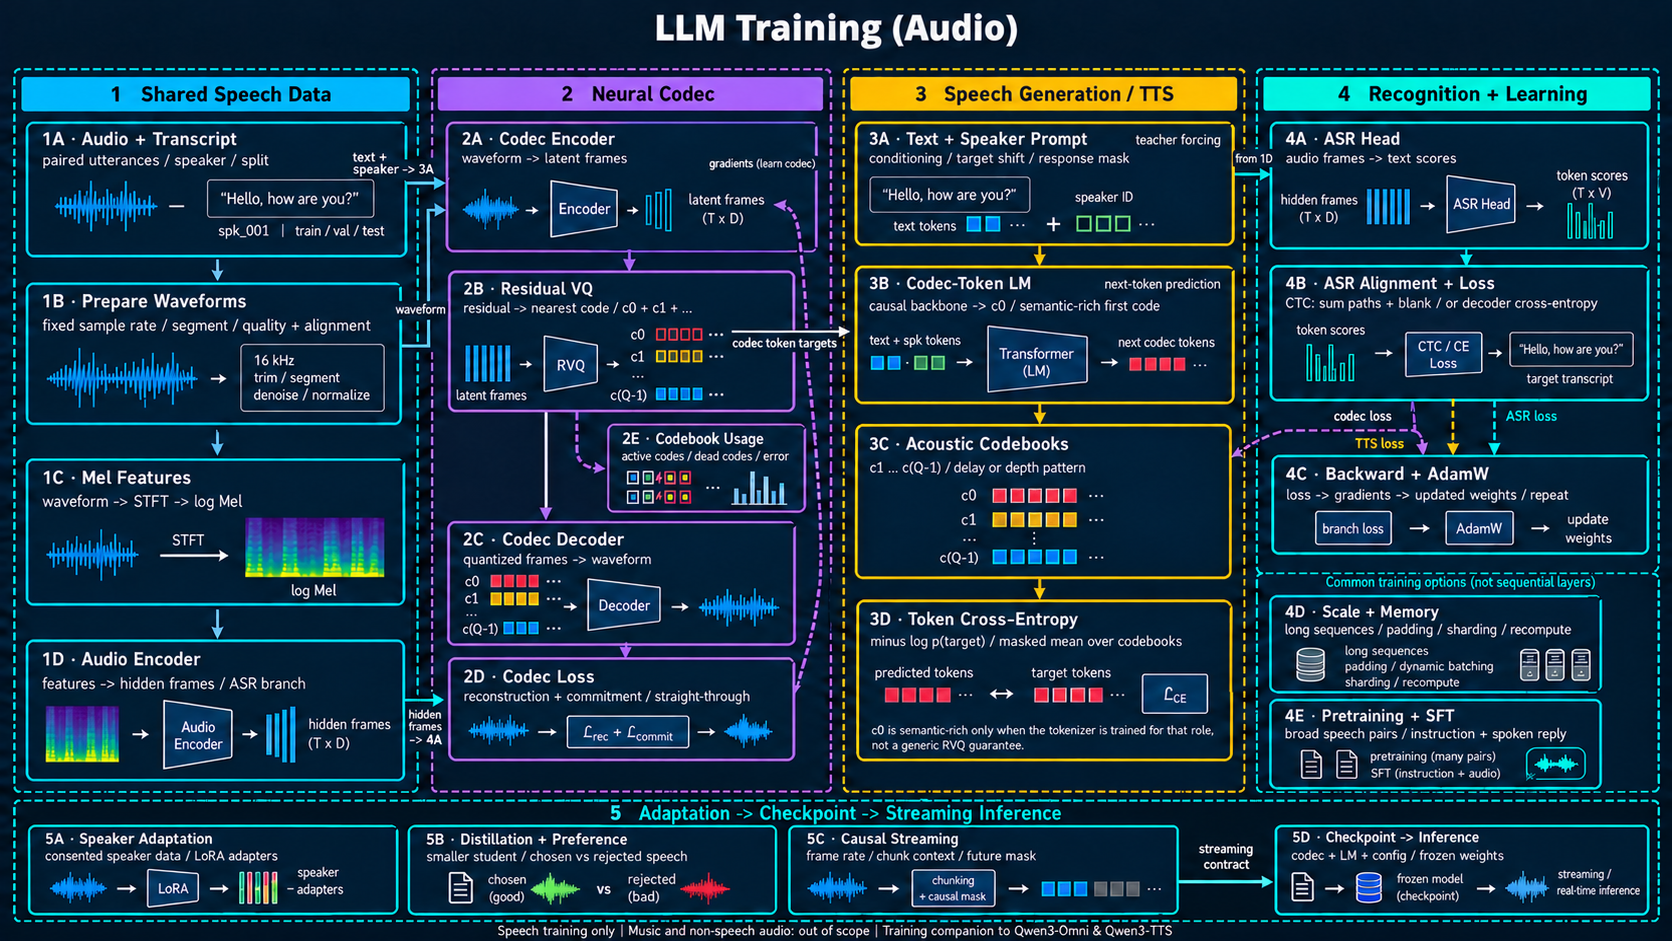
Ba nhánh học ba loại đầu ra
Codec học dựng lại sóng; TTS học dự đoán mã có điều kiện trên chữ và giọng; ASR học chữ từ audio. Mũi tên từ RVQ sang TTS mang nhãn codec, còn ASR dùng đặc trưng Mel và encoder riêng. Ô 4C dùng lại nguyên tắc backward–AdamW cho từng nhánh, không bắt buộc cộng mọi loss.
Đối chiếu với lab và đọc giới hạn
Lab có tám giai đoạn trên tone tổng hợp. Encoder/decoder tuyến tính, LM chỉ nhìn một mã trước và ASR có nhãn khung sẵn. CTC chỉ minh họa collapse; SFT, LoRA, distillation và preference chỉ được giải thích. Mở Tab 02 · Bài Lab tổng hợp ↗
Nguồn công bố tham chiếu
Danh sách bài học (16)
- 1A · Cặp audio–transcript và chia tập
- 1B · Chuẩn hóa, phân đoạn và lọc audio
- 1C–1D · Mel và encoder cho ASR
- 2A–2B · Encoder codec và lượng tử hóa phần dư RVQ
- 2C–2E · Decoder, loss tái tạo và sức khỏe codebook
- 3A · Điều kiện TTS, speaker prompt và mặt nạ nhãn
- 3B · Backbone ngôn ngữ dự đoán codec token
- 3C–3D · Lịch codebook và cross-entropy nhiều đầu
- 4A · ASR từ biểu diễn audio tới chữ
- 4B · Căn chỉnh: CTC hoặc decoder cross-entropy
- 4C · Loss, backward và AdamW cho ba nhánh
- 4D · Chuỗi audio dài, batch và ngân sách bộ nhớ
- 4E · Học nền và SFT hội thoại tiếng nói
- 5A · Thích nghi người nói và LoRA
- 5B · Distillation và ưu tiên độ tự nhiên
- 5C–5D · Huấn luyện nhân quả, checkpoint và cầu sang suy luận