Huấn luyện tiếng nói
4D · Chuỗi audio dài, batch và ngân sách bộ nhớ
Ước lượng số mã theo thời lượng và chia bộ nhớ thành tham số, optimizer, activation trước khi chọn kỹ thuật mở rộng.
1Định nghĩa
Mở rộng huấn luyện audio là tổ chức dữ liệu, tính toán và trạng thái sao cho các chuỗi dài vừa bộ nhớ mà vẫn giữ đúng mục tiêu học.
Với frame rate f khung/giây và Q codebook, nối phẳng audio S giây tạo khoảng S×f×Q mã, chưa tính chữ. Lịch depth hoặc delay đổi thứ tự xử lý; recompute tính lại activation, sharding chia trạng thái giữa GPU để giảm phần mỗi GPU phải giữ.
Ví dụ đời thường: xếp hàng vào xe: chia kiện giúp từng xe nhẹ hơn, còn bỏ bớt vật liệu đóng gói giúp giảm thể tích. Cả hai có phí vận chuyển hoặc đóng gói lại, không tự làm hành trình nhanh hơn.
2Luồng
Các ô cùng bài có thể là chẩn đoán hoặc lựa chọn thiết kế, không mặc định là các bước nối tiếp.
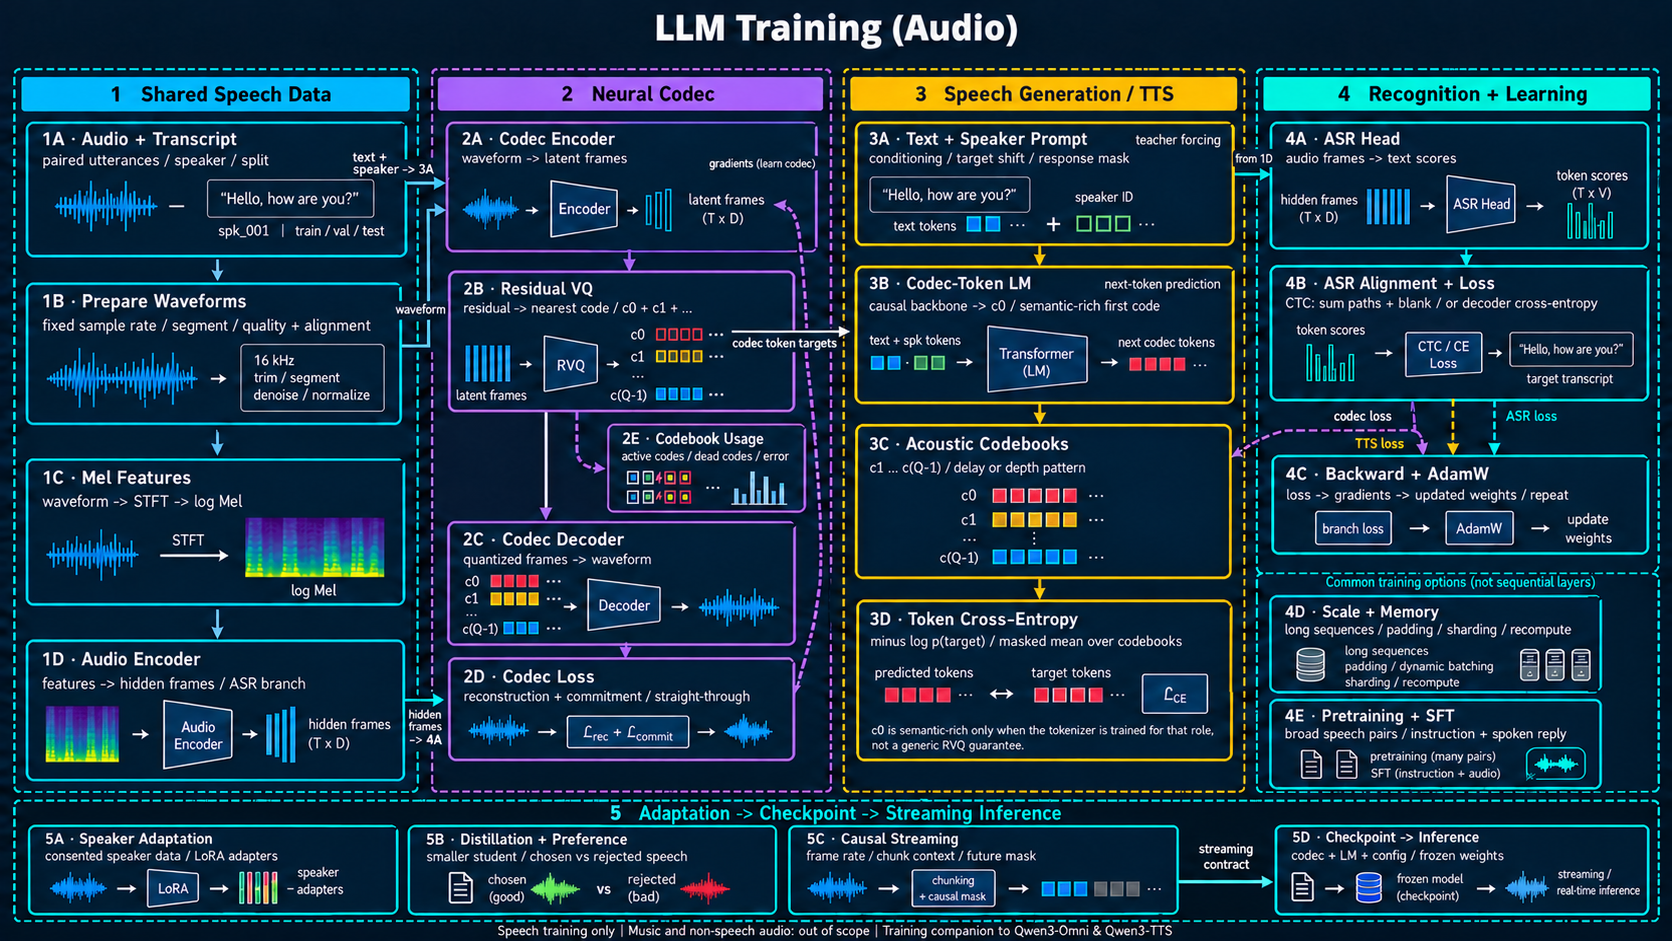
độ dài + trạng thái → ngân sách bộ nhớ4D · Quy mô và bộ nhớ
Ước lượng số mã theo thời lượng và chia bộ nhớ thành tham số, optimizer, activation trước khi chọn kỹ thuật mở rộng.
- Nhận gì
- Độ dài audio, frame rate, codebook count và trạng thái mô hình.
- Làm gì, vì sao
- Giảm padding bằng batch theo độ dài; sharding chia trạng thái, recompute tính lại activation để đổi tính toán/giao tiếp lấy bộ nhớ.
- Ra gì
- Ngân sách byte và nhãn hợp lệ cho kế hoạch huấn luyện.
- Ví dụ, cách đọc ô
- Lab 125 khung/giây × hai bảng =250 mã/giây; đây là tính cấu hình, không throughput đo.
- Lưu ý
- Lab không thực thi sharding hoặc recompute; chi phí attention không luôn tuyến tính theo số mã.
- Nhận đầu vào
Đếm độ dài sau tokenizer, số codebook, độ chính xác số và số tham số học. Activation là kết quả trung gian cần cho backward; bộ nhớ có thể tăng theo độ dài và cấu trúc attention. Gom batch theo độ dài để bớt padding nhưng giữ xáo trộn và cân bằng người nói.
- Biến đổi để học
Gradient accumulation cộng gradient của các microbatch trước cập nhật; chuẩn hóa theo tổng nhãn hợp lệ, không lấy trung bình các loss batch có độ dài khác nhau một cách tùy tiện. ZeRO chia params/grads/optimizer tùy mức; recompute giữ điểm mốc rồi tính lại các đoạn forward khi backward.
- Đọc kết quả
Lập bảng trạng thái mô hình, activation, bộ đệm tạm và giao tiếp. Mixed precision tiết kiệm byte nhưng có thể cần bản trọng số và trạng thái optimizer độ chính xác cao hơn. Công thức trạng thái không phải dự đoán chính xác đỉnh bộ nhớ thực tế.
Mã Mermaid
flowchart TD
  step1["Nhận đầu vào"]
  step2["Biến đổi để học"]
  step3["Đọc kết quả"]
  step1 --> step2
step2 --> step33Giải pháp
Đầu vào và kiến thức cần nhớ
Đếm độ dài sau tokenizer, số codebook, độ chính xác số và số tham số học. Activation là kết quả trung gian cần cho backward; bộ nhớ có thể tăng theo độ dài và cấu trúc attention. Gom batch theo độ dài để bớt padding nhưng giữ xáo trộn và cân bằng người nói.
Thao tác và lý do
Gradient accumulation cộng gradient của các microbatch trước cập nhật; chuẩn hóa theo tổng nhãn hợp lệ, không lấy trung bình các loss batch có độ dài khác nhau một cách tùy tiện. ZeRO chia params/grads/optimizer tùy mức; recompute giữ điểm mốc rồi tính lại các đoạn forward khi backward.
Đầu ra và cách đọc
Lập bảng trạng thái mô hình, activation, bộ đệm tạm và giao tiếp. Mixed precision tiết kiệm byte nhưng có thể cần bản trọng số và trạng thái optimizer độ chính xác cao hơn. Công thức trạng thái không phải dự đoán chính xác đỉnh bộ nhớ thực tế.
4Profiling
- Kiểm đúng trước, đo sau
Giữ cùng số giây audio và số nhãn hợp lệ để so throughput; báo cả giây audio/giây và token/giây vì Q khác nhau làm token rate thay đổi. Đo peak memory sau warmup, tốc độ mạng và bước tối ưu; không suy speedup từ số GPU.
- Giới hạn kết luận
Lab chỉ đếm byte m và v và tỷ lệ mã; không thực thi hoặc đo ZeRO, recompute hay GPU.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Đối chiếu ô 4D và lab giai đoạn 7
Tính tay từ cấu hình lab: 8000/64 = 125 khung/giây, hai bảng thành 250 mã/giây nếu nối phẳng. Một phút sẽ có 15000 mã, dù mỗi ví dụ lab chỉ một khung. Tự kiểm: tăng Q gấp đôi có làm mọi chi phí gấp đôi không? Số nhãn phẳng gấp đôi; attention, depth và decoder có quy luật khác.
Tự thực hành có hướng dẫn
Mở [bài Lab tổng hợp](/courses/llm-training-audio/train-audio-lab/ta-end-to-end-lab/) rồi tìm khối [7] trong output. Viết lại đầu vào, kết quả và giới hạn của khối đó trước khi thử thay một hằng số. Nếu cơ chế chỉ được giải thích chứ chưa được thực thi, không ghi PASS của lab thành bằng chứng cho cơ chế ấy.
6Thuật ngữ
- Chuỗi audio dài, batch và ngân sách bộ nhớ
- Mở rộng huấn luyện audio là tổ chức dữ liệu, tính toán và trạng thái sao cho các chuỗi dài vừa bộ nhớ mà vẫn giữ đúng mục tiêu học.
Glossary (1)
- Đối chiếu sơ đồ
- Ô 4D; giai đoạn 7 của lab. Lab chỉ đếm byte m và v và tỷ lệ mã; không thực thi hoặc đo ZeRO, recompute hay GPU.