Huấn luyện tiếng nói
4C · Loss, backward và AdamW cho ba nhánh
Phân biệt ba mục tiêu học và theo gradient đến tham số; dùng AdamW mà không gộp mọi nhánh thành một loss bắt buộc.
1Định nghĩa
Một bước học gồm tính đầu ra, đo loss, truyền đạo hàm ngược qua các phép tính và dùng bộ tối ưu sửa các tham số được phép học.
Loss là một số chấm sai số; gradient là đạo hàm loss theo mỗi tham số, cho biết độ nhạy khi tham số đổi một chút. Codec dùng tái tạo và commitment; TTS (chuyển chữ thành tiếng nói) dùng CE mã; ASR (nhận dạng tiếng nói tự động) dùng CTC hoặc CE chữ. Ba mục tiêu không bắt buộc chạy chung một bước.
Ví dụ đời thường: ba học viên nhận ba loại bài kiểm tra: vẽ lại hình, đoán mảnh ghép và chép chính tả. Cùng cách sửa bài nhưng không cộng điểm của ba người rồi dùng chung để sửa mọi quyển vở.
2Luồng
Các ô cùng bài có thể là chẩn đoán hoặc lựa chọn thiết kế, không mặc định là các bước nối tiếp.
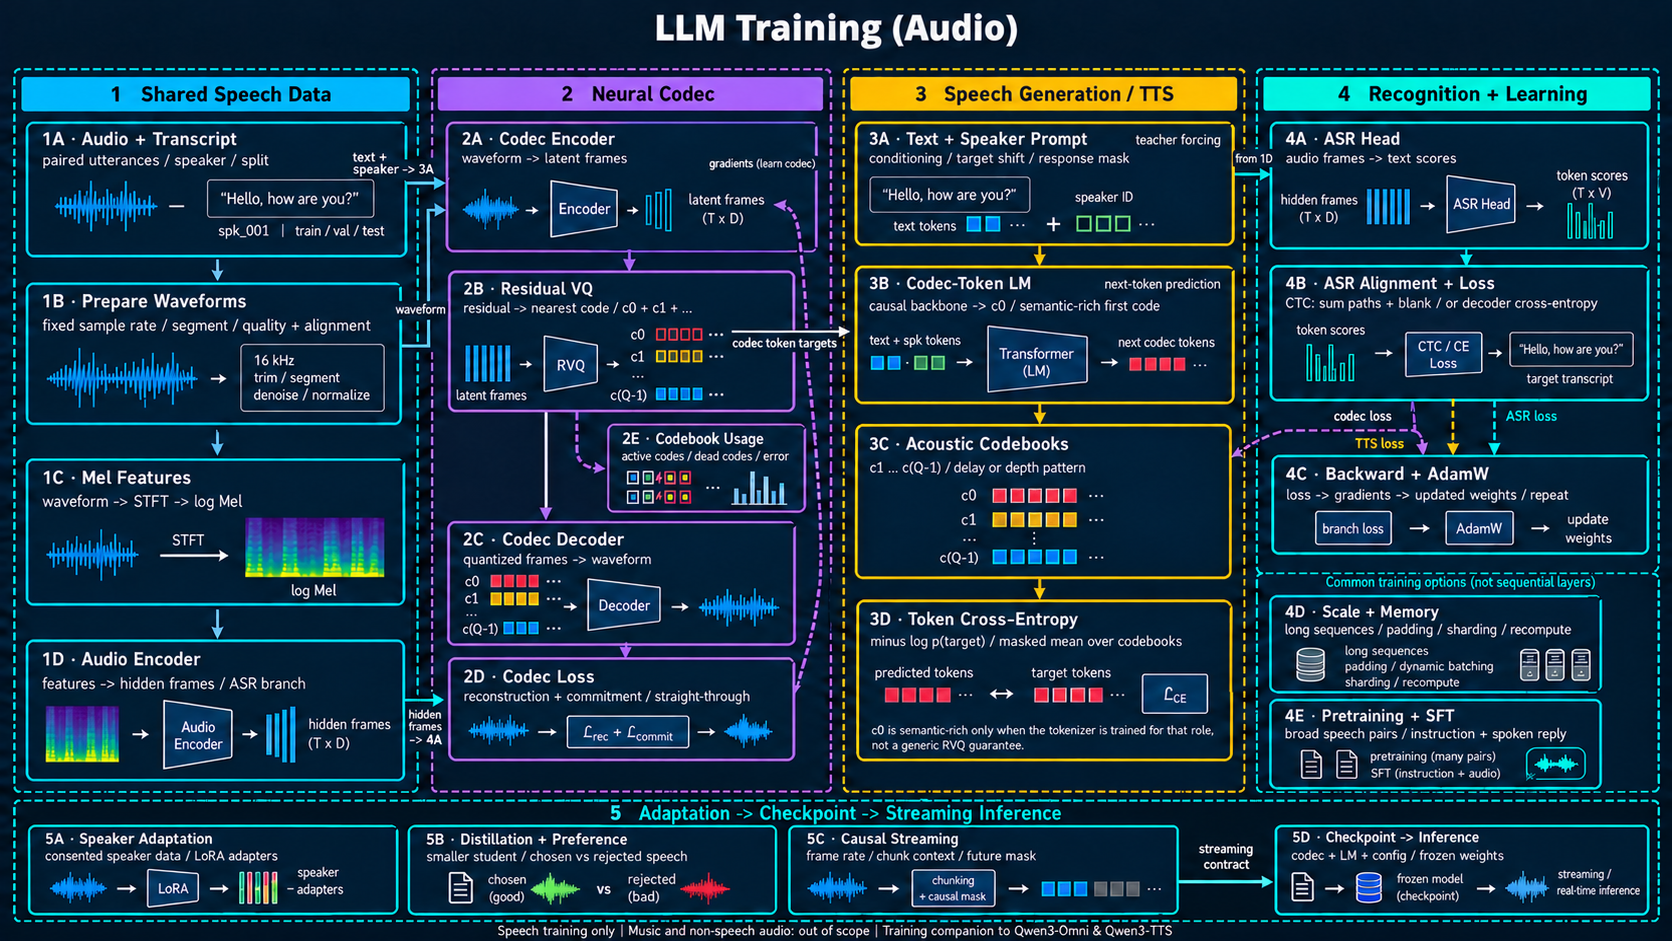
loss → gradient → AdamW → tham số mới4C · Backward và AdamW
Phân biệt ba mục tiêu học và theo gradient đến tham số; dùng AdamW mà không gộp mọi nhánh thành một loss bắt buộc.
- Nhận gì
- Loss của nhánh đang học và các tham số được mở gradient.
- Làm gì, vì sao
- Backward tính độ nhạy; AdamW giữ trung bình m và bình phương v để sửa trọng số, rồi lặp với dữ liệu tiếp.
- Ra gì
- Tham số mới và trạng thái optimizer; lưu checkpoint ở 5D khi cần.
- Ví dụ, cách đọc ô
- Lab kiểm đạo hàm decoder bằng sai phân, lệch khoảng 2.48e−16 so ngưỡng 1e−6.
- Lưu ý
- Ba đường loss biểu thị các bài toán riêng dùng lại vòng cập nhật, không ép codec/TTS/ASR học đồng thời.
- Nhận đầu vào
Xác định tham số nào mở gradient: codec khi học codec; backbone và đầu mã khi học TTS; encoder/đầu text khi học ASR. Đóng băng không chỉ bỏ tham số khỏi optimizer; cũng phải tránh giữ đồ thị và activation không cần thiết khi có thể.
- Biến đổi để học
Nhắc lại AdamW: m là trung bình trượt gradient, v là trung bình trượt bình phương gradient; hiệu chỉnh thiên lệch ban đầu rồi chia m cho căn v để chọn bước. Weight decay kéo trọng số về 0 theo nhánh tách riêng. Learning rate quá lớn vẫn làm loss tăng; AdamW không tự bảo đảm hội tụ.
- Đọc kết quả
Sau bước cập nhật có tham số mới, m, v và bộ đếm bước. Kiểm đạo hàm các phần khả vi bằng sai phân hữu hạn: tăng/giảm một tham số epsilon rồi chia chênh loss cho 2 epsilon. Với RVQ, straight-through là ước lượng nên chỉ kiểm decoder hoặc đường liên tục thích hợp.
Mã Mermaid
flowchart TD
  step1["Nhận đầu vào"]
  step2["Biến đổi để học"]
  step3["Đọc kết quả"]
  step1 --> step2
step2 --> step33Giải pháp
Đầu vào và kiến thức cần nhớ
Xác định tham số nào mở gradient: codec khi học codec; backbone và đầu mã khi học TTS; encoder/đầu text khi học ASR. Đóng băng không chỉ bỏ tham số khỏi optimizer; cũng phải tránh giữ đồ thị và activation không cần thiết khi có thể.
Thao tác và lý do
Nhắc lại AdamW: m là trung bình trượt gradient, v là trung bình trượt bình phương gradient; hiệu chỉnh thiên lệch ban đầu rồi chia m cho căn v để chọn bước. Weight decay kéo trọng số về 0 theo nhánh tách riêng. Learning rate quá lớn vẫn làm loss tăng; AdamW không tự bảo đảm hội tụ.
Đầu ra và cách đọc
Sau bước cập nhật có tham số mới, m, v và bộ đếm bước. Kiểm đạo hàm các phần khả vi bằng sai phân hữu hạn: tăng/giảm một tham số epsilon rồi chia chênh loss cho 2 epsilon. Với RVQ, straight-through là ước lượng nên chỉ kiểm decoder hoặc đường liên tục thích hợp.
4Profiling
- Kiểm đúng trước, đo sau
Bắt đầu một batch nhỏ, kiểm loss hữu hạn và gradient norm từng nhánh. Nếu encoder không đổi, kiểm có bị detach không; nếu codebook sụp, xem phân bố chọn mã trước khi tăng LR. So validation và chất lượng sinh, không chỉ train loss.
- Giới hạn kết luận
Trọng số không tăng số lượng sau nhiều bước; m và v là trạng thái học, không phải lớp mới của mô hình.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Đối chiếu ô 4C và lab giai đoạn 4
Lab học codec 400 bước với LR 0.01; sai lệch gradient decoder khoảng 2.48e−16, ngưỡng chấp nhận 1e−6. Tự kiểm: con số này có chứng minh gradient qua argmin đúng? Không, tham số được nhiễu chỉ ở decoder, nên lựa chọn mã không đổi.
Tự thực hành có hướng dẫn
Mở [bài Lab tổng hợp](/courses/llm-training-audio/train-audio-lab/ta-end-to-end-lab/) rồi tìm khối [4] trong output. Viết lại đầu vào, kết quả và giới hạn của khối đó trước khi thử thay một hằng số. Nếu cơ chế chỉ được giải thích chứ chưa được thực thi, không ghi PASS của lab thành bằng chứng cho cơ chế ấy.
6Thuật ngữ
- Loss, backward và AdamW cho ba nhánh
- Một bước học gồm tính đầu ra, đo loss, truyền đạo hàm ngược qua các phép tính và dùng bộ tối ưu sửa các tham số được phép học.
Glossary (1)
- Đối chiếu sơ đồ
- Ô 4C; giai đoạn 4 của lab. Trọng số không tăng số lượng sau nhiều bước; m và v là trạng thái học, không phải lớp mới của mô hình.