Huấn luyện tiếng nói
4A · ASR từ biểu diễn audio tới chữ
Tách nhiệm vụ nhận dạng lời nói khỏi tái tạo sóng và chọn đầu dự đoán văn bản phù hợp.
1Định nghĩa
Automatic speech recognition (ASR) là bài toán suy ra chuỗi văn bản từ audio tiếng nói, dù số khung audio không bằng số token chữ.
Mel và audio encoder tạo vector theo thời gian; một đầu dự đoán có thể cho xác suất chữ ở mỗi khung hoặc nối encoder vào decoder ngôn ngữ. ASR không cần đi qua codec RVQ và không học dựng lại waveform.
Ví dụ đời thường: thư ký nghe bản ghi rồi ghi biên bản: cần giữ lời nói, không cần tái tạo đúng từng rung động của giọng. Nghe rõ một âm vẫn có thể chưa biết cách viết nếu thiếu ngữ cảnh.
2Luồng
Các ô cùng bài có thể là chẩn đoán hoặc lựa chọn thiết kế, không mặc định là các bước nối tiếp.
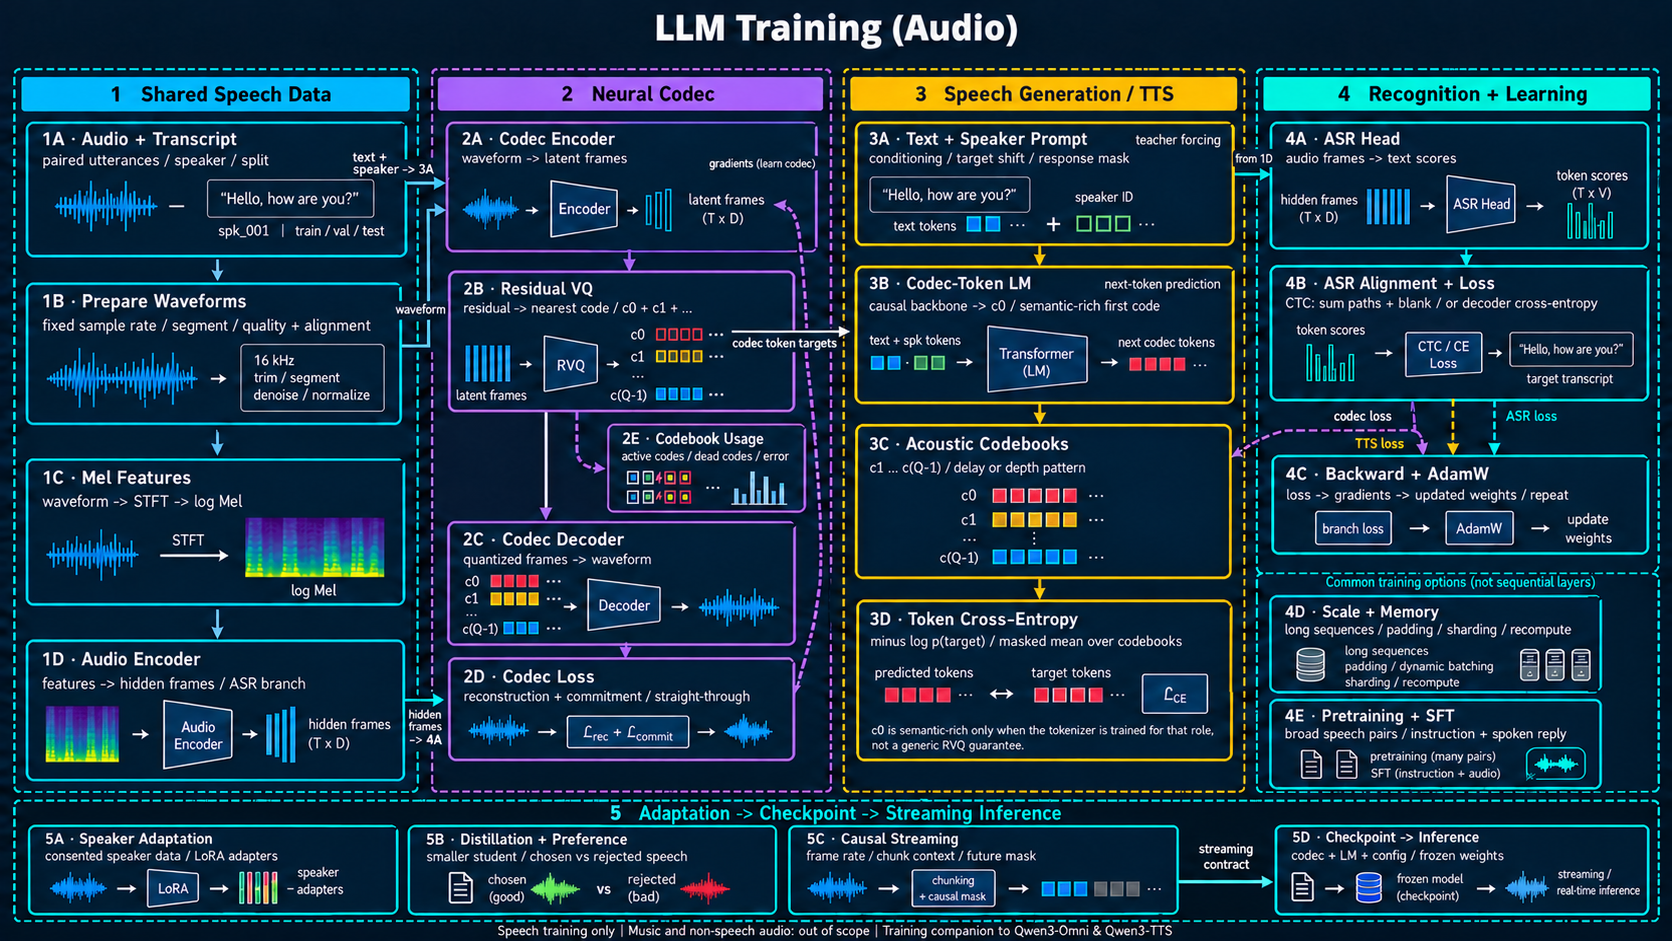
vector audio → logits chữ4A · Đầu nhận dạng văn bản
Tách nhiệm vụ nhận dạng lời nói khỏi tái tạo sóng và chọn đầu dự đoán văn bản phù hợp.
- Nhận gì
- Vector audio từ 1D, không nhận mã sinh của TTS.
- Làm gì, vì sao
- Chiếu mỗi khung sang logits chữ, hoặc cho decoder văn bản attention lên audio; chọn cấu trúc theo bài toán căn chỉnh.
- Ra gì
- Điểm số nhãn tới 4B để chấm với transcript.
- Ví dụ, cách đọc ô
- Lab đầu tuyến tính dùng 12 dải Mel để đoán nhãn tone A/B/C có căn sẵn.
- Lưu ý
- Accuracy khung không phải WER của bản chép lời thật.
- Nhận đầu vào
Đầu vào là đặc trưng audio và độ dài thật, nhãn là transcript đã tokenizer. Vocabulary là bảng ký hiệu văn bản; khác vocabulary của codec. Cùng số ID ở hai bảng không mang cùng ý nghĩa. Xác định quy tắc chuẩn hóa chữ, số và dấu trước khi đo.
- Biến đổi để học
Với đầu framewise, mỗi hàng hidden được chiếu sang logits nhãn khung. Muốn học từ transcript chưa căn, dùng CTC thay vì ép lặp nhãn tùy ý. Với encoder–decoder, decoder đọc text token trước đó và attention lên audio rồi dự đoán text token kế bằng CE.
- Đọc kết quả
Kết quả là transcript và có thể timestamp nếu thiết kế hỗ trợ. Encoder–decoder có khả năng tận dụng ngữ cảnh chữ nhưng cũng có thể đoán chữ không tồn tại trong audio; cần kiểm trên im lặng, nhiễu và tên riêng.
Mã Mermaid
flowchart TD
  step1["Nhận đầu vào"]
  step2["Biến đổi để học"]
  step3["Đọc kết quả"]
  step1 --> step2
step2 --> step33Giải pháp
Đầu vào và kiến thức cần nhớ
Đầu vào là đặc trưng audio và độ dài thật, nhãn là transcript đã tokenizer. Vocabulary là bảng ký hiệu văn bản; khác vocabulary của codec. Cùng số ID ở hai bảng không mang cùng ý nghĩa. Xác định quy tắc chuẩn hóa chữ, số và dấu trước khi đo.
Thao tác và lý do
Với đầu framewise, mỗi hàng hidden được chiếu sang logits nhãn khung. Muốn học từ transcript chưa căn, dùng CTC thay vì ép lặp nhãn tùy ý. Với encoder–decoder, decoder đọc text token trước đó và attention lên audio rồi dự đoán text token kế bằng CE.
Đầu ra và cách đọc
Kết quả là transcript và có thể timestamp nếu thiết kế hỗ trợ. Encoder–decoder có khả năng tận dụng ngữ cảnh chữ nhưng cũng có thể đoán chữ không tồn tại trong audio; cần kiểm trên im lặng, nhiễu và tên riêng.
4Profiling
- Kiểm đúng trước, đo sau
WER là số thay thế + xóa + chèn từ, chia số từ tham chiếu; có thể vượt 100% khi chèn nhiều. Với ngôn ngữ khó tách từ, cân nhắc CER theo ký tự và quy tắc chuẩn hóa công khai. Accuracy theo khung không thể thay WER.
- Giới hạn kết luận
Không dùng transcript làm điều kiện đầu vào của bộ nhận dạng khi đánh giá nhận dạng thuần audio.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Đối chiếu ô 4A và lab giai đoạn 6
Lab đầu tuyến tính nhận 12 đặc trưng, đoán A/B/C theo từng khung có nhãn sẵn; CE 0.9248 → 0.0082, accuracy kiểm định 100%. Tự kiểm: điểm này có chứng minh nhận ra tiếng Việt không? Không, ba nhãn chỉ là ba tone do chương trình tạo.
Tự thực hành có hướng dẫn
Mở [bài Lab tổng hợp](/courses/llm-training-audio/train-audio-lab/ta-end-to-end-lab/) rồi tìm khối [6] trong output. Viết lại đầu vào, kết quả và giới hạn của khối đó trước khi thử thay một hằng số. Nếu cơ chế chỉ được giải thích chứ chưa được thực thi, không ghi PASS của lab thành bằng chứng cho cơ chế ấy.
6Thuật ngữ
- ASR từ biểu diễn audio tới chữ
- Automatic speech recognition (ASR) là bài toán suy ra chuỗi văn bản từ audio tiếng nói, dù số khung audio không bằng số token chữ.
Glossary (1)
- Đối chiếu sơ đồ
- Ô 4A; giai đoạn 6 của lab. Không dùng transcript làm điều kiện đầu vào của bộ nhận dạng khi đánh giá nhận dạng thuần audio.