Huấn luyện tiếng nói
3B · Backbone ngôn ngữ dự đoán codec token
Dùng cơ chế dự đoán token kế tiếp của LM cho tiếng nói rời rạc thay vì dự đoán trực tiếp mẫu sóng.
1Định nghĩa
Codec-token language model là mô hình học phân phối của dãy mã audio có điều kiện trên chữ, giọng và các mã đã xuất hiện.
Backbone là mạng lõi tạo vector ngữ cảnh; đầu dự đoán chuyển vector đó thành logits cho mã tiếp theo. Cũng như LM văn bản, cross-entropy theo codebook tăng xác suất nhãn đúng; khác biệt là từ vựng đầu ra gồm ID của bảng mã audio chứ không phải từ trong transcript.
Ví dụ đời thường: đọc hướng dẫn rồi chọn từng mảnh ghép để dựng một bản ghi âm. Mã mảnh ghép chỉ có nghĩa với đúng hộp mảnh ghép; cùng số ID ở hộp khác có thể dựng ra âm hoàn toàn khác.
2Luồng
Các ô cùng bài có thể là chẩn đoán hoặc lựa chọn thiết kế, không mặc định là các bước nối tiếp.
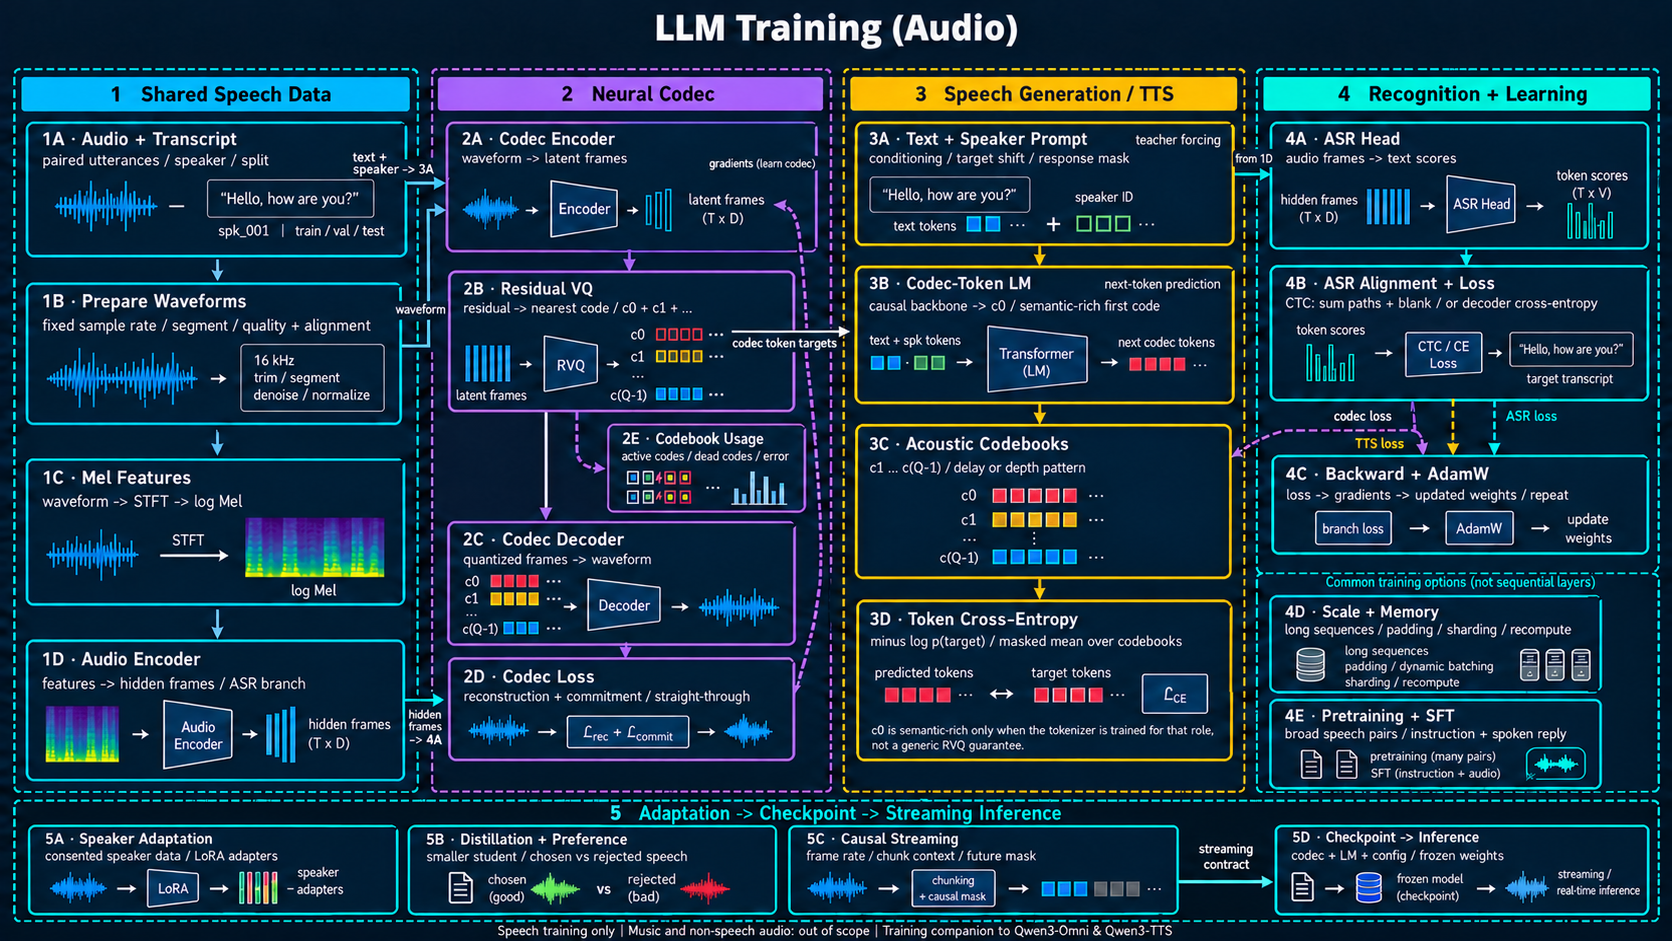
điều kiện + lịch sử → logits mã tiếp3B · LM dự đoán mã tiếng nói
Dùng cơ chế dự đoán token kế tiếp của LM cho tiếng nói rời rạc thay vì dự đoán trực tiếp mẫu sóng.
- Nhận gì
- Điều kiện từ 3A và các mã đã có; không nhìn mã đích hiện tại.
- Làm gì, vì sao
- Backbone tạo ngữ cảnh rồi logits mã tiếp; ở tokenizer có giám sát thích hợp, c0 có thể giàu nội dung ngôn ngữ.
- Ra gì
- Phân phối mã đầu, tiếp tục 3C; decoder chỉ chạy khi đủ mã cần cho khung.
- Ví dụ, cách đọc ô
- Lab MLP 608 tham số nhìn một mã trước; đây là mô hình ngôn ngữ mã rất nhỏ, không có Transformer.
- Lưu ý
- CE thấp với teacher forcing chưa đo lỗi tích lũy lúc sinh nhiều khung.
- Nhận đầu vào
Nhận text token, embedding giọng và lịch sử mã. Transformer nhân quả có thể học quan hệ dài giữa nội dung, nhịp điệu và phát âm. Dữ liệu mã lấy từ codec cố định; nếu đổi codec phải chuyển nhãn hoặc huấn luyện lại đầu ra tương ứng.
- Biến đổi để học
Với một số tokenizer có giám sát ngữ nghĩa, backbone dự đoán c0 giàu nội dung, rồi bộ dự đoán chiều sâu học các mã dư để giữ âm sắc. Đây là một phân rã thiết kế, không định luật của RVQ. Mã đầu vẫn chứa thông tin âm học, và mã sau không nhất thiết chỉ chứa giọng.
- Đọc kết quả
Đầu ra là phân phối xác suất mã, chưa phải waveform. Sau khi chọn đủ mã cho khung, tra codebook và chạy decoder codec để phát tiếng. Khi học dùng teacher forcing, khi suy luận dùng mã chính mô hình sinh nên sai nhỏ có thể tích lũy.
Mã Mermaid
flowchart TD
  step1["Nhận đầu vào"]
  step2["Biến đổi để học"]
  step3["Đọc kết quả"]
  step1 --> step2
step2 --> step33Giải pháp
Đầu vào và kiến thức cần nhớ
Nhận text token, embedding giọng và lịch sử mã. Transformer nhân quả có thể học quan hệ dài giữa nội dung, nhịp điệu và phát âm. Dữ liệu mã lấy từ codec cố định; nếu đổi codec phải chuyển nhãn hoặc huấn luyện lại đầu ra tương ứng.
Thao tác và lý do
Với một số tokenizer có giám sát ngữ nghĩa, backbone dự đoán c0 giàu nội dung, rồi bộ dự đoán chiều sâu học các mã dư để giữ âm sắc. Đây là một phân rã thiết kế, không định luật của RVQ. Mã đầu vẫn chứa thông tin âm học, và mã sau không nhất thiết chỉ chứa giọng.
Đầu ra và cách đọc
Đầu ra là phân phối xác suất mã, chưa phải waveform. Sau khi chọn đủ mã cho khung, tra codebook và chạy decoder codec để phát tiếng. Khi học dùng teacher forcing, khi suy luận dùng mã chính mô hình sinh nên sai nhỏ có thể tích lũy.
4Profiling
- Kiểm đúng trước, đo sau
Báo CE từng codebook và kiểm định sinh tự hồi quy. So nội dung bằng ASR độc lập, độ giống giọng bằng phép đo phù hợp và đánh giá nghe; không quy một CE thấp thành phát âm chuẩn. Giữ codec, prompt và cách giải mã cố định khi so checkpoint.
- Giới hạn kết luận
Một câu trả lời bằng tiếng nói còn cần mô hình chọn nội dung hội thoại; lab chỉ ánh xạ nhãn tone thành mã, không học đối thoại.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Đối chiếu ô 3B và lab giai đoạn 5
LM của lab là MLP tanh 608 tham số, chỉ nhìn một mã trước và điều kiện hiện tại, không có attention. CE train 2.1214 → 0.0015; sóng sinh có MSE 0.002234 trên kiểm định. Tự kiểm: vì sao không gọi đây là Transformer thu nhỏ? Nó thiếu attention và ngữ cảnh nhiều khung.
Tự thực hành có hướng dẫn
Mở [bài Lab tổng hợp](/courses/llm-training-audio/train-audio-lab/ta-end-to-end-lab/) rồi tìm khối [5] trong output. Viết lại đầu vào, kết quả và giới hạn của khối đó trước khi thử thay một hằng số. Nếu cơ chế chỉ được giải thích chứ chưa được thực thi, không ghi PASS của lab thành bằng chứng cho cơ chế ấy.
6Thuật ngữ
- Backbone ngôn ngữ dự đoán codec token
- Codec-token language model là mô hình học phân phối của dãy mã audio có điều kiện trên chữ, giọng và các mã đã xuất hiện.
Glossary (1)
- Đối chiếu sơ đồ
- Ô 3B; giai đoạn 5 của lab. Một câu trả lời bằng tiếng nói còn cần mô hình chọn nội dung hội thoại; lab chỉ ánh xạ nhãn tone thành mã, không học đối thoại.