Huấn luyện tiếng nói
3A · Điều kiện TTS, speaker prompt và mặt nạ nhãn
Chuẩn bị chữ, mẫu giọng và codec token đích; dịch nhãn và che vùng điều kiện để học sinh tiếng nói.
1Định nghĩa
Điều kiện TTS là phần thông tin được cung cấp để mô hình quyết định nói nội dung gì và bằng giọng nào trước khi dự đoán mã audio.
Text-to-speech (TTS (chuyển chữ thành tiếng nói)) chuyển chữ thành tiếng nói. Chữ được tokenizer thành ID văn bản; mẫu giọng có thể thành embedding người nói hoặc mã codec tham chiếu. LM codec token học trên đáp án từ codec, dùng điều kiện làm ngữ cảnh chứ không coi mọi token prompt là đích phải chấm.
Ví dụ đời thường: diễn viên nhận kịch bản và bản hướng dẫn giọng đọc. Kịch bản quyết định lời cần nói, mẫu giọng gợi cách nói; chép nguyên mẫu giọng không phải hoàn thành kịch bản mới.
2Luồng
Các ô cùng bài có thể là chẩn đoán hoặc lựa chọn thiết kế, không mặc định là các bước nối tiếp.
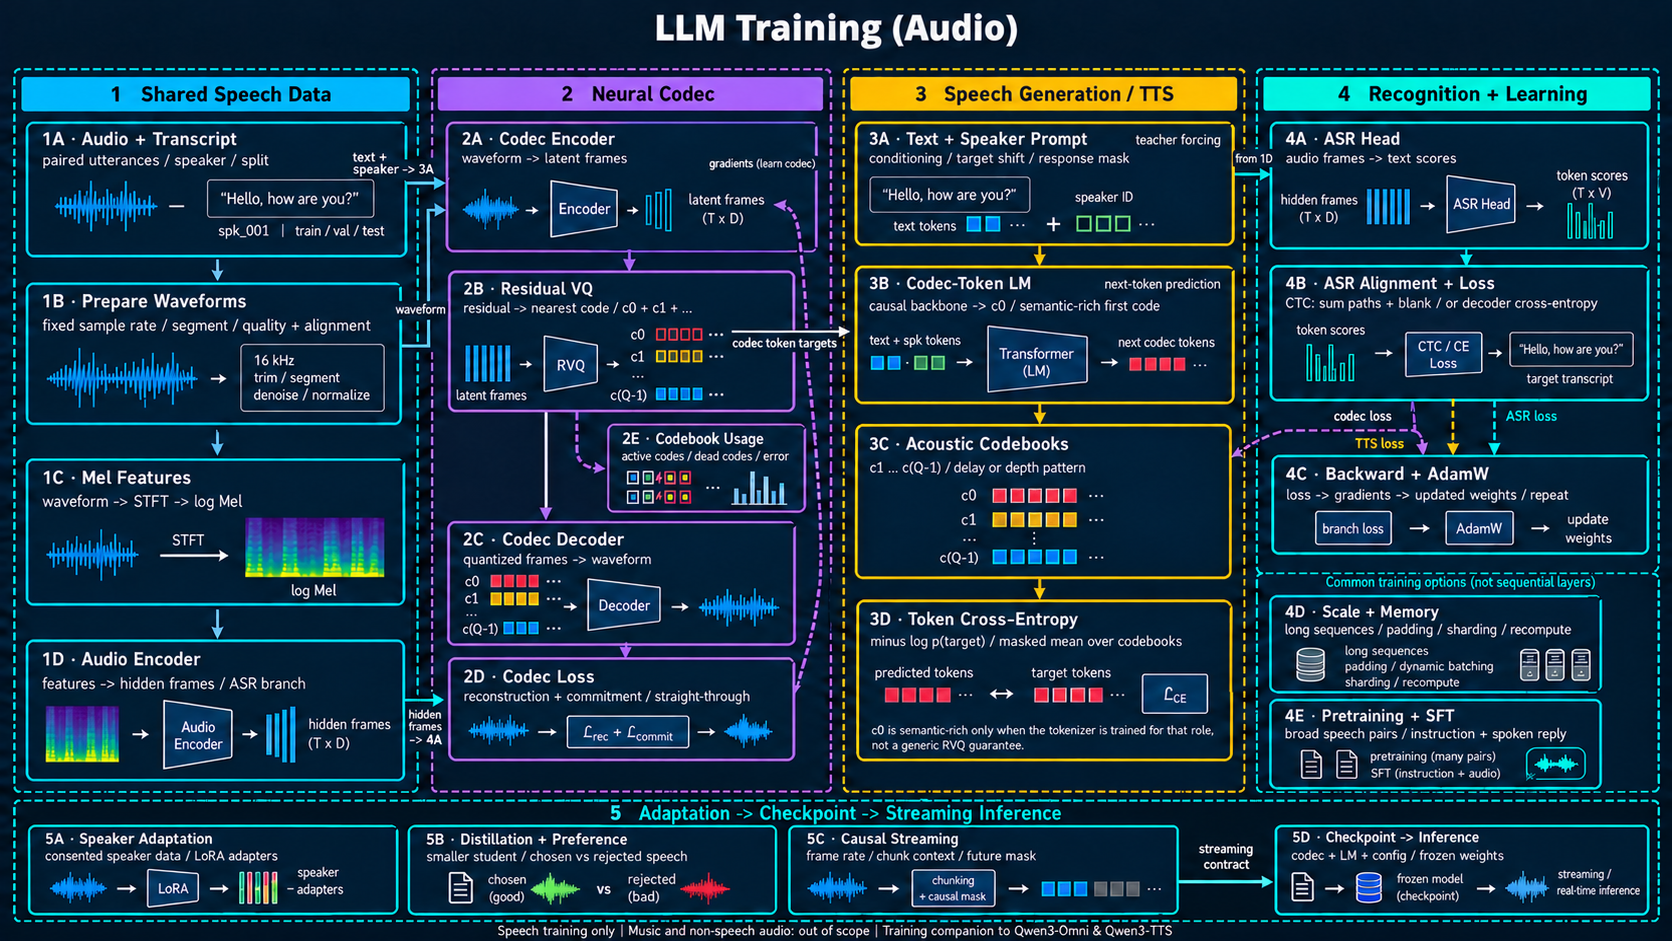
chữ + giọng + mã quá khứ → điều kiện3A · Chữ, giọng và nhãn TTS
Chuẩn bị chữ, mẫu giọng và codec token đích; dịch nhãn và che vùng điều kiện để học sinh tiếng nói.
- Nhận gì
- Text token, speaker prompt và mã đích từ codec đóng băng.
- Làm gì, vì sao
- Dịch mã đích, thêm BOS và mask vùng không chấm; teacher forcing đưa mã đúng quá khứ khi học để dạy dự đoán tiếp.
- Ra gì
- Điều kiện và lịch sử hợp lệ cho LM 3B, nhãn/mask cho loss 3D.
- Ví dụ, cách đọc ô
- Lab điều kiện A/B/C và speaker 0/1; dự đoán c0 từ BOS, rồi c1 từ c0.
- Lưu ý
- Mặt nạ loss chỉ quyết định chấm đâu, không tự cấm nhìn đáp án tương lai.
- Nhận đầu vào
Dữ liệu gồm text đúng, audio đích và speaker prompt được phép dùng. Nếu lấy prompt từ cùng bản ghi, kiểm tra rò nội dung: mô hình không được nhìn trước chính đoạn đích cần sinh qua một đường điều kiện không che.
- Biến đổi để học
Dịch chuỗi mã đích một vị trí, thêm BOS là ký hiệu bắt đầu, và chỉ đưa mã trước vào vị trí dự đoán mã sau. Teacher forcing dùng mã đúng quá khứ trong khi học; causal mask cấm nhìn đáp án tương lai. Mặt nạ loss bỏ padding và vùng điều kiện không cần chấm, mẫu số chỉ đếm nhãn hợp lệ.
- Đọc kết quả
Trả chuỗi điều kiện, đầu vào đã dịch, mã đích và các mặt nạ. Mặt nạ attention quyết định được nhìn đâu; mặt nạ loss quyết định chấm đâu. Chúng không thay thế nhau: bỏ chấm một vị trí không tự cấm vị trí đó tiết lộ đáp án.
Mã Mermaid
flowchart TD
  step1["Nhận đầu vào"]
  step2["Biến đổi để học"]
  step3["Đọc kết quả"]
  step1 --> step2
step2 --> step33Giải pháp
Đầu vào và kiến thức cần nhớ
Dữ liệu gồm text đúng, audio đích và speaker prompt được phép dùng. Nếu lấy prompt từ cùng bản ghi, kiểm tra rò nội dung: mô hình không được nhìn trước chính đoạn đích cần sinh qua một đường điều kiện không che.
Thao tác và lý do
Dịch chuỗi mã đích một vị trí, thêm BOS là ký hiệu bắt đầu, và chỉ đưa mã trước vào vị trí dự đoán mã sau. Teacher forcing dùng mã đúng quá khứ trong khi học; causal mask cấm nhìn đáp án tương lai. Mặt nạ loss bỏ padding và vùng điều kiện không cần chấm, mẫu số chỉ đếm nhãn hợp lệ.
Đầu ra và cách đọc
Trả chuỗi điều kiện, đầu vào đã dịch, mã đích và các mặt nạ. Mặt nạ attention quyết định được nhìn đâu; mặt nạ loss quyết định chấm đâu. Chúng không thay thế nhau: bỏ chấm một vị trí không tự cấm vị trí đó tiết lộ đáp án.
4Profiling
- Kiểm đúng trước, đo sau
Thử thay mã tương lai và kiểm logits quá khứ không đổi; đếm số nhãn thật theo codebook. Đánh giá cả câu mới và người nói mới theo giao thức đã chọn; không dùng prompt có nguyên câu đích để báo khả năng chuyển giọng.
- Giới hạn kết luận
Speaker ID giả chỉ đổi biên độ tone; không phải mô hình nhận dạng hay sao chép giọng người.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Đối chiếu ô 3A và lab giai đoạn 5
Lab mỗi ví dụ chỉ có một khung: điều kiện là A/B/C và speaker 0/1, sau BOS mô hình đoán c0 rồi c1. c1 lúc học nhận c0 đúng, lúc sinh nhận c0 vừa đoán. Tự kiểm: nếu đưa c1 vào đầu vào để đoán chính c1 thì CE thấp có còn là bằng chứng học TTS? Không, đó là rò nhãn.
Tự thực hành có hướng dẫn
Mở [bài Lab tổng hợp](/courses/llm-training-audio/train-audio-lab/ta-end-to-end-lab/) rồi tìm khối [5] trong output. Viết lại đầu vào, kết quả và giới hạn của khối đó trước khi thử thay một hằng số. Nếu cơ chế chỉ được giải thích chứ chưa được thực thi, không ghi PASS của lab thành bằng chứng cho cơ chế ấy.
6Thuật ngữ
- Điều kiện TTS, speaker prompt và mặt nạ nhãn
- Điều kiện TTS là phần thông tin được cung cấp để mô hình quyết định nói nội dung gì và bằng giọng nào trước khi dự đoán mã audio.
Glossary (1)
- Đối chiếu sơ đồ
- Ô 3A; giai đoạn 5 của lab. Speaker ID giả chỉ đổi biên độ tone; không phải mô hình nhận dạng hay sao chép giọng người.