Huấn luyện tiếng nói
4E · Học nền và SFT hội thoại tiếng nói
Chọn dữ liệu và vùng nhãn để chuyển từ học biểu diễn, đọc chữ sang làm theo chỉ dẫn và trả lời bằng giọng nói.
1Định nghĩa
Pretraining xây năng lực nền trên dữ liệu rộng, còn supervised fine-tuning (SFT) dùng ví dụ chỉ dẫn–đáp án để dạy một hành vi cụ thể.
Codec có thể pretrain tái tạo audio; LM speech học chữ–mã để đọc lời; mô hình hội thoại cần dữ liệu hỏi–đáp và mặt nạ chỉ chấm phần trả lời. Điều kiện và mặt nạ quyết định tín hiệu học, trong khi vòng backward–AdamW vẫn giữ nguyên nguyên tắc.
Ví dụ đời thường: học đọc to nhiều trang sách rồi tập trả lời câu hỏi của khách. Đọc trôi chảy không đồng nghĩa biết chọn đúng câu trả lời, và kịch bản hỏi–đáp ít mẫu có thể bị thuộc lòng.
2Luồng
Các ô cùng bài có thể là chẩn đoán hoặc lựa chọn thiết kế, không mặc định là các bước nối tiếp.
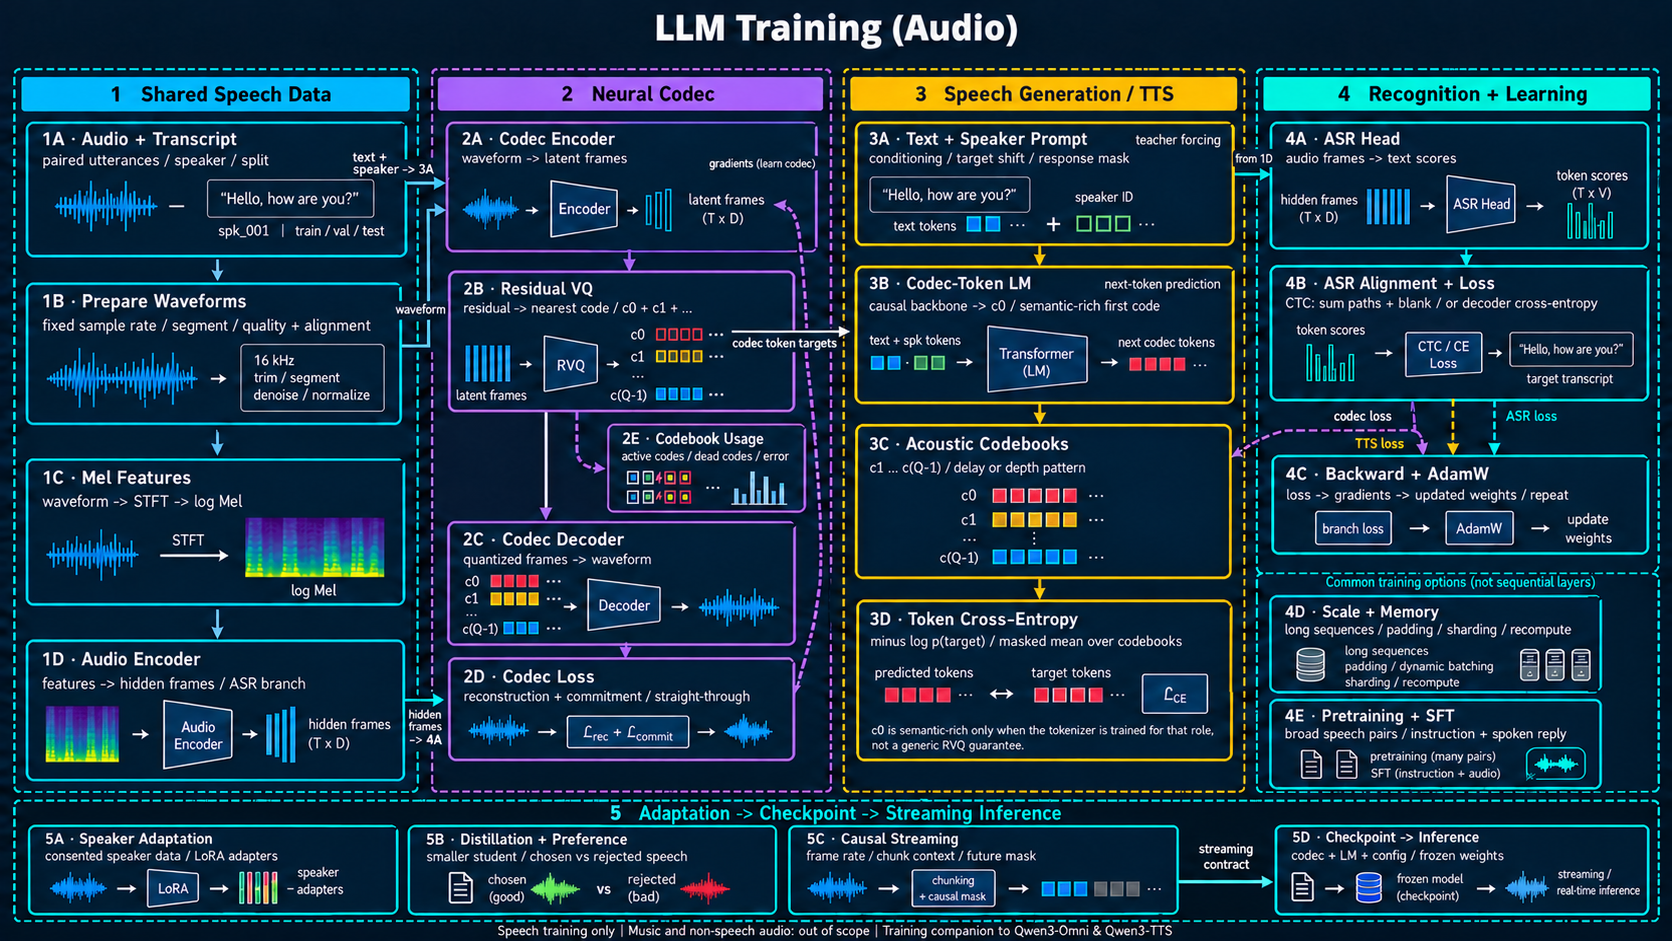
dữ liệu nền hoặc chỉ dẫn → mục tiêu học4E · Học nền và SFT
Chọn dữ liệu và vùng nhãn để chuyển từ học biểu diễn, đọc chữ sang làm theo chỉ dẫn và trả lời bằng giọng nói.
- Nhận gì
- Checkpoint xuất phát cùng corpus rộng hoặc ví dụ chỉ dẫn–trả lời.
- Làm gì, vì sao
- Pretraining học năng lực nền; SFT chấm phần trả lời để học hành vi hội thoại, dùng cùng nguyên tắc cập nhật.
- Ra gì
- Checkpoint phù hợp tác vụ; nội dung câu trả lời và giọng cần đánh giá riêng.
- Ví dụ, cách đọc ô
- Mask user=0, reply=1 là ví dụ SFT: user vẫn được đọc làm điều kiện nhưng không bị chấm.
- Lưu ý
- Lab không thực thi SFT; TTS đọc chữ không tự biết trả lời câu hỏi.
- Nhận đầu vào
Xác định checkpoint xuất phát, modality đầu vào và đầu ra cần học. Với spoken reply, nhãn có thể gồm nội dung text, audio hoặc cả hai theo lịch thiết kế. Không mặc định mọi model được pretrain từ đầu hoặc mọi loss đều chạy đồng thời.
- Biến đổi để học
Dùng corpus đa người nói/ngôn ngữ cho năng lực nền, rồi SFT trên ví dụ có vai trò user/assistant rõ. Response mask chấm nhãn trả lời, padding bị loại. Nếu audio đầu vào chứa câu hỏi, đừng cho mô hình nghe trước câu trả lời đích qua một nhánh encoder.
- Đọc kết quả
Lưu checkpoint kèm template hội thoại, codec và quy tắc mask. Eval tách chất lượng nội dung trả lời khỏi chất lượng giọng, độ đúng lời và khả năng dừng. Có thể giọng tốt nhưng câu trả lời sai, hoặc nội dung đúng mà phát âm kém.
Mã Mermaid
flowchart TD
  step1["Nhận đầu vào"]
  step2["Biến đổi để học"]
  step3["Đọc kết quả"]
  step1 --> step2
step2 --> step33Giải pháp
Đầu vào và kiến thức cần nhớ
Xác định checkpoint xuất phát, modality đầu vào và đầu ra cần học. Với spoken reply, nhãn có thể gồm nội dung text, audio hoặc cả hai theo lịch thiết kế. Không mặc định mọi model được pretrain từ đầu hoặc mọi loss đều chạy đồng thời.
Thao tác và lý do
Dùng corpus đa người nói/ngôn ngữ cho năng lực nền, rồi SFT trên ví dụ có vai trò user/assistant rõ. Response mask chấm nhãn trả lời, padding bị loại. Nếu audio đầu vào chứa câu hỏi, đừng cho mô hình nghe trước câu trả lời đích qua một nhánh encoder.
Đầu ra và cách đọc
Lưu checkpoint kèm template hội thoại, codec và quy tắc mask. Eval tách chất lượng nội dung trả lời khỏi chất lượng giọng, độ đúng lời và khả năng dừng. Có thể giọng tốt nhưng câu trả lời sai, hoặc nội dung đúng mà phát âm kém.
4Profiling
- Kiểm đúng trước, đo sau
So base và SFT trên cùng prompt chưa gặp, báo độ đúng nội dung, lỗi nhận dạng bản sinh và đánh giá nghe. Theo dõi quên năng lực nền; tỷ lệ dữ liệu và LR là lựa chọn cần thử, không lấy loss train thấp làm bằng chứng tốt hơn.
- Giới hạn kết luận
Học TTS theo transcript không tự tạo khả năng trả lời câu hỏi; cần nguồn nội dung và mục tiêu hội thoại phù hợp.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Đối chiếu ô 4E và lab giai đoạn 8
Tình huống tự kiểm: cặp user hỏi giờ, assistant nói câu trả lời. Vùng user có mask loss 0, các mã câu trả lời có 1; nhưng user vẫn được đọc làm điều kiện. Vì sao mask 0 không phải cấm attention? Nó chỉ bỏ chấm loss. Lab bước 8 nêu giới hạn và không thực thi SFT hội thoại.
Tự thực hành có hướng dẫn
Mở [bài Lab tổng hợp](/courses/llm-training-audio/train-audio-lab/ta-end-to-end-lab/) rồi tìm khối [8] trong output. Viết lại đầu vào, kết quả và giới hạn của khối đó trước khi thử thay một hằng số. Nếu cơ chế chỉ được giải thích chứ chưa được thực thi, không ghi PASS của lab thành bằng chứng cho cơ chế ấy.
6Thuật ngữ
- Học nền và SFT hội thoại tiếng nói
- Pretraining xây năng lực nền trên dữ liệu rộng, còn supervised fine-tuning (SFT) dùng ví dụ chỉ dẫn–đáp án để dạy một hành vi cụ thể.
Glossary (1)
- Đối chiếu sơ đồ
- Ô 4E; giai đoạn 8 của lab. Học TTS theo transcript không tự tạo khả năng trả lời câu hỏi; cần nguồn nội dung và mục tiêu hội thoại phù hợp.