Huấn luyện tiếng nói
1B · Chuẩn hóa, phân đoạn và lọc audio
Đưa sóng về một tần số lấy mẫu, cắt đoạn đúng lời và lọc cặp không khớp trước khi huấn luyện.
1Định nghĩa
Tiền xử lý audio là chuỗi phép biến đổi đưa các bản ghi khác định dạng về đầu vào có cùng hợp đồng thời gian và chất lượng.
Tần số lấy mẫu là số mẫu sóng trong một giây; resampling tính lại mẫu trên lưới thời gian mới có lọc chống aliasing. Cặp audio–transcript chỉ còn hữu ích nếu mỗi đoạn cắt vẫn khớp chính xác phần chữ đi cùng.
Ví dụ đời thường: cắt phụ đề đi kèm một video: đổi số khung hình không làm câu nói dài gấp đôi, còn cắt nhầm mốc thời gian sẽ đặt phụ đề của câu khác vào đoạn đang xem.
2Luồng
Các ô cùng bài có thể là chẩn đoán hoặc lựa chọn thiết kế, không mặc định là các bước nối tiếp.
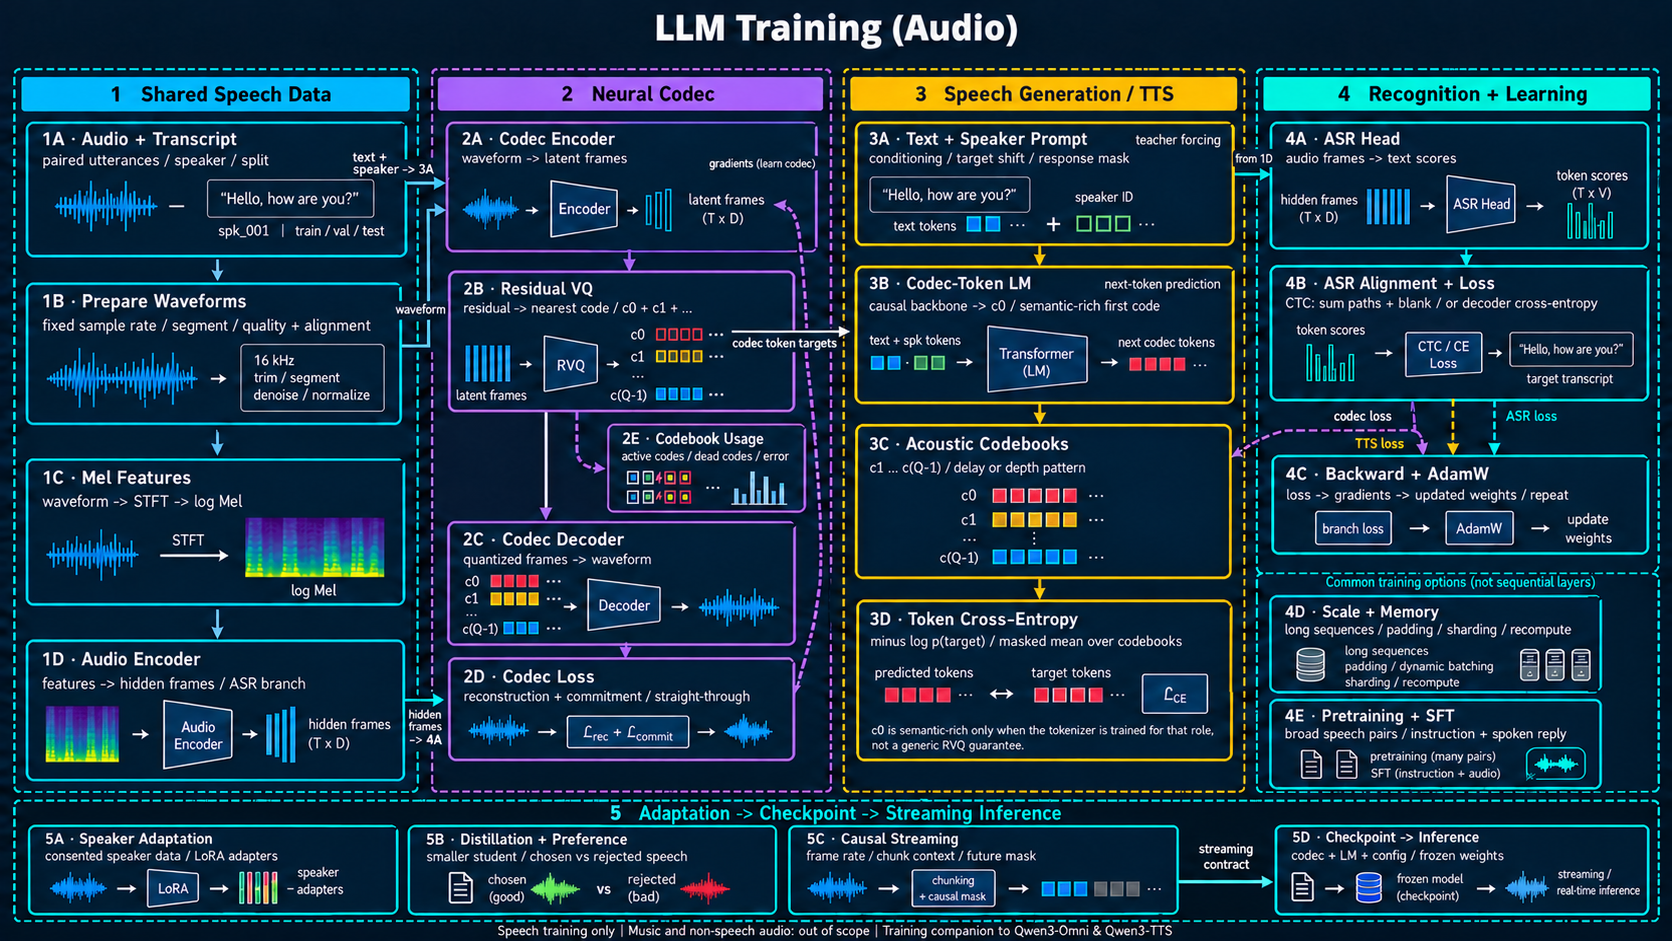
sóng → fixed sample rate → đoạn khớp lời1B · Chuẩn hóa và lọc sóng
Đưa sóng về một tần số lấy mẫu, cắt đoạn đúng lời và lọc cặp không khớp trước khi huấn luyện.
- Nhận gì
- Audio khác sample rate, độ dài và chất lượng, cùng transcript tương ứng.
- Làm gì, vì sao
- Resample có lọc chống aliasing về tần số cố định, cắt đoạn rồi lọc nhiễu và sai khớp chữ; giữ thời lượng thật.
- Ra gì
- Sóng chuẩn cho codec; sóng sang Mel cho ASR; chữ và speaker đi riêng tới 3A.
- Ví dụ, cách đọc ô
- Một giây 16 kHz đổi sang 8 kHz vẫn một giây; đây là tính tay, lab tạo thẳng 8 kHz.
- Lưu ý
- Lab không thực thi resampling, phân đoạn hay lọc chất lượng.
- Nhận đầu vào
Đọc đúng sample rate trong tệp, số kênh và mức biên độ. Đổi nhãn metadata từ 16 kHz sang 24 kHz không phải resampling: nó làm thời lượng và cao độ bị đọc sai. Khi hạ tần số, lọc bỏ thành phần vượt giới hạn mới trước khi lấy mẫu lại.
- Biến đổi để học
Dùng khoảng lặng hoặc bộ phát hiện tiếng nói để đề xuất ranh giới, rồi kiểm tra không cắt cụt từ. Cắt transcript bằng timestamp đã căn chỉnh. Lọc clipping (đỉnh bị cắt), quá nhiều im lặng, nhiễu nặng, sai ngôn ngữ và sai khớp audio–chữ; đặt ngưỡng dựa trên kiểm tra mẫu thay vì chép một ngưỡng chung.
- Đọc kết quả
Trả sóng ở fixed sample rate, độ dài thật, transcript đoạn và cờ chất lượng. Padding chỉ làm các chuỗi bằng chiều dài trong batch; phải giữ mặt nạ để vùng đệm không được chấm loss. Không xóa khoảng dừng mang ngữ điệu chỉ để làm dữ liệu ngắn.
Mã Mermaid
flowchart TD
  step1["Nhận đầu vào"]
  step2["Biến đổi để học"]
  step3["Đọc kết quả"]
  step1 --> step2
step2 --> step33Giải pháp
Đầu vào và kiến thức cần nhớ
Đọc đúng sample rate trong tệp, số kênh và mức biên độ. Đổi nhãn metadata từ 16 kHz sang 24 kHz không phải resampling: nó làm thời lượng và cao độ bị đọc sai. Khi hạ tần số, lọc bỏ thành phần vượt giới hạn mới trước khi lấy mẫu lại.
Thao tác và lý do
Dùng khoảng lặng hoặc bộ phát hiện tiếng nói để đề xuất ranh giới, rồi kiểm tra không cắt cụt từ. Cắt transcript bằng timestamp đã căn chỉnh. Lọc clipping (đỉnh bị cắt), quá nhiều im lặng, nhiễu nặng, sai ngôn ngữ và sai khớp audio–chữ; đặt ngưỡng dựa trên kiểm tra mẫu thay vì chép một ngưỡng chung.
Đầu ra và cách đọc
Trả sóng ở fixed sample rate, độ dài thật, transcript đoạn và cờ chất lượng. Padding chỉ làm các chuỗi bằng chiều dài trong batch; phải giữ mặt nạ để vùng đệm không được chấm loss. Không xóa khoảng dừng mang ngữ điệu chỉ để làm dữ liệu ngắn.
4Profiling
- Kiểm đúng trước, đo sau
Trước và sau resampling, so thời lượng tính bằng số mẫu chia sample rate và nghe kiểm tra cao độ. Báo tỷ lệ bị loại theo ngôn ngữ/người nói: bộ lọc có thể ưu tiên giọng dễ nghe và làm dữ liệu lệch.
- Giới hạn kết luận
Không gọi việc bỏ mỗi mẫu thứ hai là resampling đúng nếu chưa lọc chống aliasing.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Đối chiếu ô 1B và lab giai đoạn 1
Bài tính tay: một giây 16 kHz có 16000 mẫu; đổi sang 8 kHz còn khoảng 8000 mẫu nhưng vẫn một giây. Lab đã tạo trực tiếp ở 8000 mẫu/giây và biết sẵn ranh giới 64 mẫu, nên không kiểm chứng resampler hoặc bộ phân đoạn. Tự kiểm: chỉ đổi SAMPLE_RATE trong lab sẽ đổi cả tín hiệu được tạo, không phải chạy resampling.
Tự thực hành có hướng dẫn
Mở [bài Lab tổng hợp](/courses/llm-training-audio/train-audio-lab/ta-end-to-end-lab/) rồi tìm khối [1] trong output. Viết lại đầu vào, kết quả và giới hạn của khối đó trước khi thử thay một hằng số. Nếu cơ chế chỉ được giải thích chứ chưa được thực thi, không ghi PASS của lab thành bằng chứng cho cơ chế ấy.
6Thuật ngữ
- Chuẩn hóa, phân đoạn và lọc audio
- Tiền xử lý audio là chuỗi phép biến đổi đưa các bản ghi khác định dạng về đầu vào có cùng hợp đồng thời gian và chất lượng.
Glossary (1)
- Đối chiếu sơ đồ
- Ô 1B; giai đoạn 1 của lab. Không gọi việc bỏ mỗi mẫu thứ hai là resampling đúng nếu chưa lọc chống aliasing.