Huấn luyện tiếng nói
1C–1D · Mel và encoder cho ASR
Biến sóng thành năng lượng theo thời gian và tần số, rồi học biểu diễn khung để nhận dạng lời nói.
1Định nghĩa
Mel spectrogram là bảng năng lượng của audio trên các cửa sổ thời gian và các dải tần được bố trí theo thang Mel.
Phép biến đổi Fourier ngắn hạn (STFT) tách mỗi cửa sổ thành thành phần tần số; bộ lọc Mel gộp các thành phần và phép log nén dải năng lượng. Audio encoder học đổi bảng này thành vector theo khung cho đầu nhận dạng ASR (nhận dạng tiếng nói tự động); nó không phải encoder của codec RVQ.
Ví dụ đời thường: xem phổ màu của một bản nhạc theo từng lát thời gian thay vì nhìn dây sóng ngoằn ngoèo. Bảng màu giúp thấy mẫu lặp, nhưng tự nó chưa nói mẫu đó là từ nào.
2Luồng
Các ô cùng bài có thể là chẩn đoán hoặc lựa chọn thiết kế, không mặc định là các bước nối tiếp.
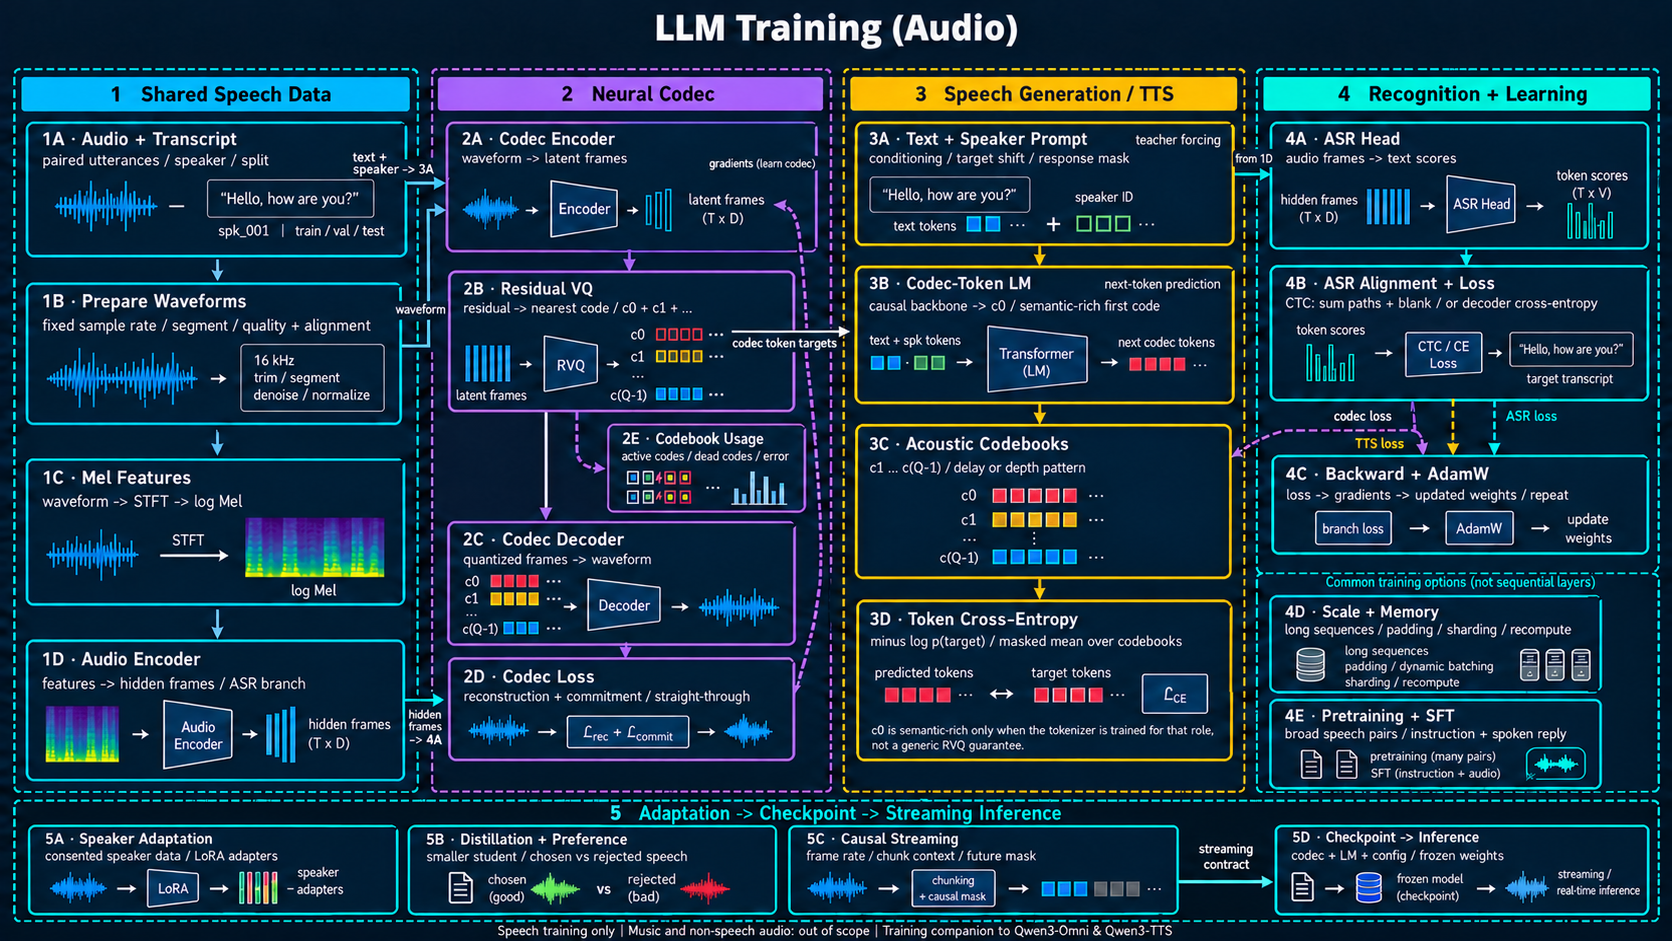
sóng → STFT → năng lượng Mel → log1C · Đặc trưng Mel
Biến sóng thành năng lượng theo thời gian và tần số, rồi học biểu diễn khung để nhận dạng lời nói.
- Nhận gì
- Sóng ở sample rate đã chọn từ 1B.
- Làm gì, vì sao
- STFT tách năng lượng từng cửa sổ theo tần số; bộ lọc Mel gộp dải và log nén năng lượng để dễ nhận dạng.
- Ra gì
- Bảng theo khung và dải tần đi tới audio encoder 1D.
- Ví dụ, cách đọc ô
- Lab mỗi khung 64 mẫu thành 12 dải Mel rồi log1p, chuẩn hóa bằng thống kê train.
- Lưu ý
- Cửa sổ 8 ms thu nhỏ không phải cấu hình log-Mel tiếng nói chuẩn.
- Nhận đầu vào
Nhận sóng đã đúng sample rate. Chọn độ dài cửa sổ và hop (bước dịch cửa sổ). Cửa sổ dài phân giải tần số tốt hơn nhưng gộp nhiều thay đổi thời gian hơn; hop ngắn tạo nhiều khung, tăng bộ nhớ. Cấu hình phải thống nhất giữa học và suy luận.
- Biến đổi để học
Nhân cửa sổ Hann để giảm rò phổ, lấy bình phương biên độ STFT, nhân bộ lọc tam giác Mel rồi log năng lượng với chặn số nhỏ. Encoder dùng convolution hoặc attention để gom ngữ cảnh, có thể giảm số khung bằng stride. Giữ độ dài sau stride cho loss ASR và mặt nạ.
- Đọc kết quả
Nếu có T khung và F dải Mel thì bảng có T hàng, F cột; encoder đổi mỗi hàng thành D số biểu diễn và có thể cho ít hàng hơn. Trục thời gian vẫn phải đủ dài cho transcript. Với streaming, cửa sổ nhìn tương lai và attention hai chiều là một phần của độ chờ.
Mã Mermaid
flowchart TD
  step1["Nhận đầu vào"]
  step2["Biến đổi để học"]
  step3["Đọc kết quả"]
  step1 --> step2
step2 --> step33Giải pháp
Đầu vào và kiến thức cần nhớ
Nhận sóng đã đúng sample rate. Chọn độ dài cửa sổ và hop (bước dịch cửa sổ). Cửa sổ dài phân giải tần số tốt hơn nhưng gộp nhiều thay đổi thời gian hơn; hop ngắn tạo nhiều khung, tăng bộ nhớ. Cấu hình phải thống nhất giữa học và suy luận.
Thao tác và lý do
Nhân cửa sổ Hann để giảm rò phổ, lấy bình phương biên độ STFT, nhân bộ lọc tam giác Mel rồi log năng lượng với chặn số nhỏ. Encoder dùng convolution hoặc attention để gom ngữ cảnh, có thể giảm số khung bằng stride. Giữ độ dài sau stride cho loss ASR và mặt nạ.
Đầu ra và cách đọc
Nếu có T khung và F dải Mel thì bảng có T hàng, F cột; encoder đổi mỗi hàng thành D số biểu diễn và có thể cho ít hàng hơn. Trục thời gian vẫn phải đủ dài cho transcript. Với streaming, cửa sổ nhìn tương lai và attention hai chiều là một phần của độ chờ.
4Profiling
- Kiểm đúng trước, đo sau
Kiểm tra đầu vào im lặng không sinh NaN, độ dài sau stride khớp cấu hình và thống kê chuẩn hóa chỉ khớp trên train. So ASR cùng tập kiểm định khi đổi hop; không chỉ so kích thước mảng để kết luận chất lượng.
- Giới hạn kết luận
Mel dùng cho nhận thức; codec trong lab nhận sóng trực tiếp. Đừng nối ASR sau RVQ chỉ vì hai nhánh đều bắt đầu bằng audio.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Đối chiếu ô 1C–1D và lab giai đoạn 2
Lab cho mỗi khung 64 mẫu qua 12 bộ lọc Mel rồi log1p năng lượng; đây là biến thể thu nhỏ, không cấu hình log-Mel tiếng nói chuẩn. Đầu ASR tuyến tính học trực tiếp từ 12 số, chưa có encoder ngữ cảnh. Tự kiểm: vì sao biết cao độ tone đủ phân loại A/B/C nhưng chưa đủ nhận ra một câu? Nhãn tone chỉ mã hóa ba tần số.
Tự thực hành có hướng dẫn
Mở [bài Lab tổng hợp](/courses/llm-training-audio/train-audio-lab/ta-end-to-end-lab/) rồi tìm khối [2] trong output. Viết lại đầu vào, kết quả và giới hạn của khối đó trước khi thử thay một hằng số. Nếu cơ chế chỉ được giải thích chứ chưa được thực thi, không ghi PASS của lab thành bằng chứng cho cơ chế ấy.
6Thuật ngữ
- Mel và encoder cho ASR
- Mel spectrogram là bảng năng lượng của audio trên các cửa sổ thời gian và các dải tần được bố trí theo thang Mel.
Glossary (1)
- Đối chiếu sơ đồ
- Ô 1C–1D; giai đoạn 2 của lab. Mel dùng cho nhận thức; codec trong lab nhận sóng trực tiếp. Đừng nối ASR sau RVQ chỉ vì hai nhánh đều bắt đầu bằng audio.