Huấn luyện tiếng nói
2C–2E · Decoder, loss tái tạo và sức khỏe codebook
Dùng sai số tái tạo và commitment để học codec, đồng thời theo dõi mã ít dùng và giới hạn của MSE.
1Định nghĩa
Huấn luyện neural codec là tối ưu encoder, bảng mã và decoder để bản sóng khôi phục giữ thông tin cần thiết dưới ngân sách mã rời rạc.
Decoder nhận tổng vector từ RVQ để dựng sóng; loss tái tạo đo khoảng cách đầu ra với sóng gốc. Commitment buộc encoder ở gần vector đã lượng tử, còn cập nhật codebook kéo mã về các latent được gán; chúng giải quyết các vai trò khác nhau.
Ví dụ đời thường: người vẽ phác, người đặt tên màu và người tô lại phải thống nhất bảng màu. Hình tô lại sai giúp sửa cả nhóm, nhưng chỉ nhìn độ lệch pixel chưa biết bức tranh có dễ nhận ra hay không.
2Luồng
Các ô cùng bài có thể là chẩn đoán hoặc lựa chọn thiết kế, không mặc định là các bước nối tiếp.
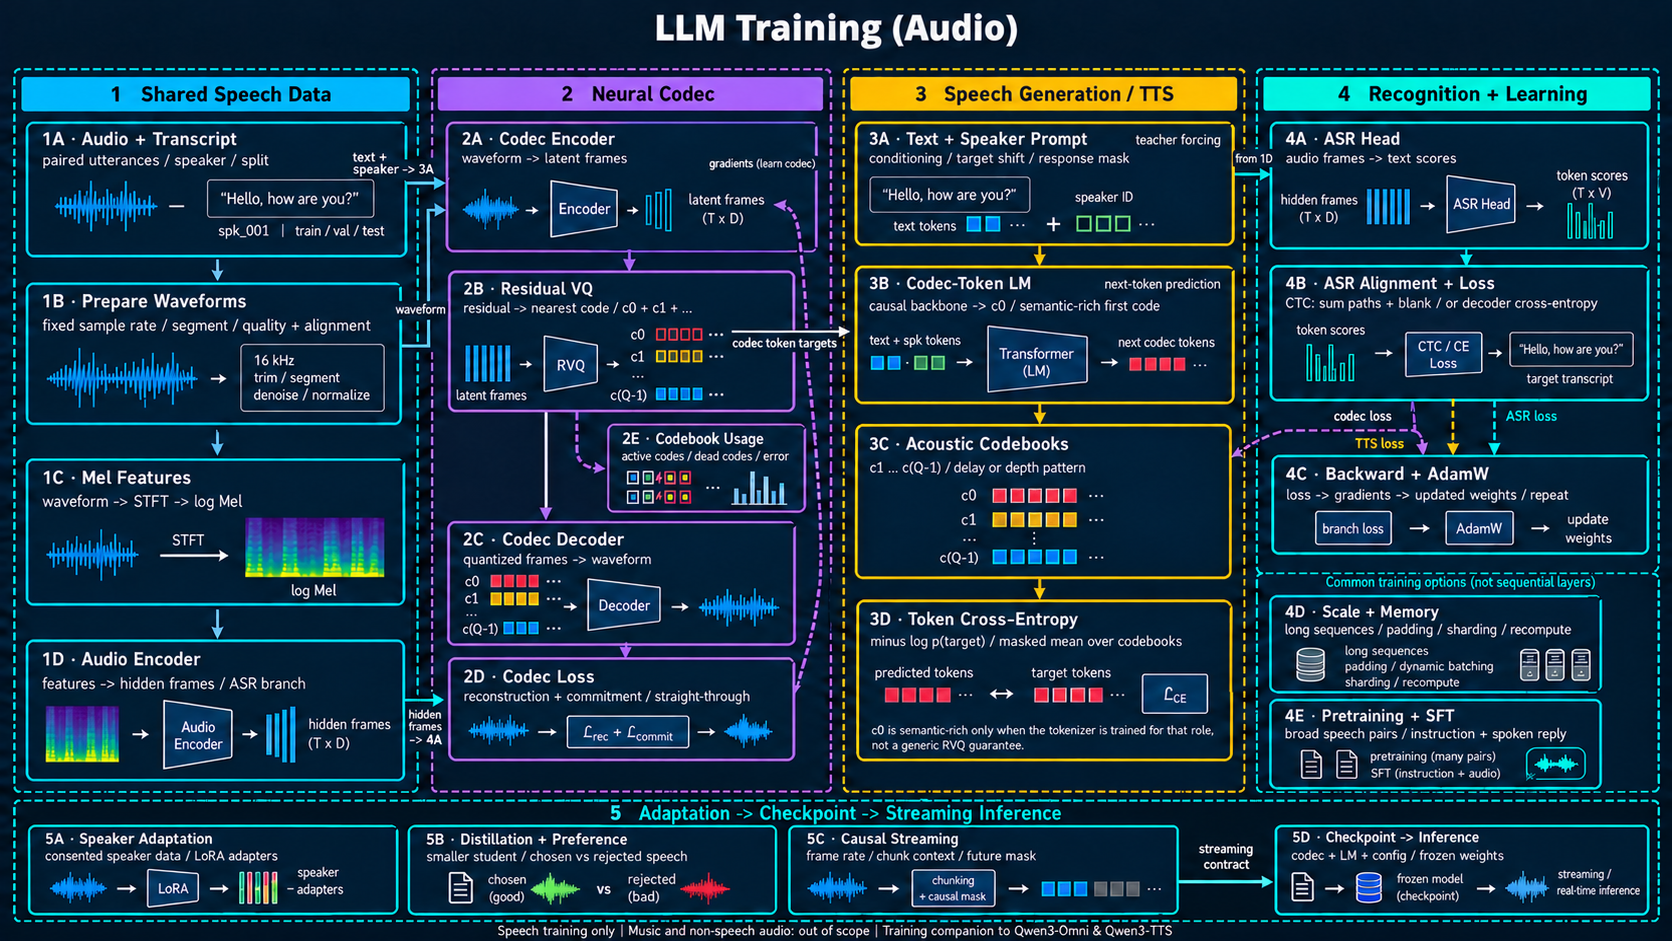
tổng vector mã → mẫu sóng2C · Decoder dựng lại sóng
Dùng sai số tái tạo và commitment để học codec, đồng thời theo dõi mã ít dùng và giới hạn của MSE.
- Nhận gì
- Tổng vector lượng tử từ các bảng ở 2B.
- Làm gì, vì sao
- Mạng giải mã biến vector khung về mẫu sóng; đầu ra liên tục cho phép đo sai số tái tạo.
- Ra gì
- Sóng khôi phục để so với sóng gốc ở 2D; suy luận cũng dùng decoder này sau LM.
- Ví dụ, cách đọc ô
- Lab decoder tuyến tính 12→64, không dùng GAN hoặc mạng tích chập giải mã tiếng nói thật.
- Lưu ý
- Sóng tái tạo đúng tone không chứng minh đọc được lời.
- Nhận đầu vào
Với N mẫu sóng, MSE bằng tổng bình phương sai lệch chia N. Nó cung cấp tín hiệu liên tục cho decoder. Codec thực tế có thể thêm loss đa độ phân giải phổ và adversarial loss, tức bộ phân biệt học chấm tính tự nhiên; bài lab chỉ minh họa MSE.
- Biến đổi để học
Argmin chọn mã không có đạo hàm hữu ích để học encoder. Straight-through dùng đạo hàm thay thế: forward dùng vector lượng tử q, backward truyền gradient tái tạo từ q về latent z như ánh xạ đồng nhất. Commitment là scalar loss BETA × mean((z−q)²); khi tính riêng đạo hàm này, giữ q cố định. Vì mean chia cho N=z.size (số phần tử latent), đóng góp vào gradient theo z là 2 × BETA × (z−q) / N, rồi mới truyền qua encoder bằng quy tắc chuỗi. Ví dụ tính tay một tọa độ: BETA=0,1, z=0,8, q=0,5, N=1 cho loss commitment 0,009 nhưng gradient 0,06; loss và gradient không phải cùng một đại lượng. Nhánh regression của codebook dùng residual dừng gradient. Đây không phải đạo hàm thật của argmin.
- Đọc kết quả
Theo dõi riêng MSE, commitment và số mã hoạt động. Mã chết là mã hầu như không được chọn; tùy thiết kế có thể khởi tạo lại từ latent gần đây hoặc điều chỉnh cân bằng. Dùng đủ mọi mã không phải mục tiêu duy nhất: dữ liệu đơn giản có thể chỉ cần vài mã.
Mã Mermaid
flowchart TD
  step1["Nhận đầu vào"]
  step2["Biến đổi để học"]
  step3["Đọc kết quả"]
  step1 --> step2
step2 --> step33Giải pháp
Đầu vào và kiến thức cần nhớ
Với N mẫu sóng, MSE bằng tổng bình phương sai lệch chia N. Nó cung cấp tín hiệu liên tục cho decoder. Codec thực tế có thể thêm loss đa độ phân giải phổ và adversarial loss, tức bộ phân biệt học chấm tính tự nhiên; bài lab chỉ minh họa MSE.
Thao tác và lý do
Argmin chọn mã không có đạo hàm hữu ích để học encoder. Straight-through dùng đạo hàm thay thế: forward dùng vector lượng tử q, backward truyền gradient tái tạo từ q về latent z như ánh xạ đồng nhất. Commitment là scalar loss BETA × mean((z−q)²); khi tính riêng đạo hàm này, giữ q cố định. Vì mean chia cho N=z.size (số phần tử latent), đóng góp vào gradient theo z là 2 × BETA × (z−q) / N, rồi mới truyền qua encoder bằng quy tắc chuỗi. Ví dụ tính tay một tọa độ: BETA=0,1, z=0,8, q=0,5, N=1 cho loss commitment 0,009 nhưng gradient 0,06; loss và gradient không phải cùng một đại lượng. Nhánh regression của codebook dùng residual dừng gradient. Đây không phải đạo hàm thật của argmin.
Đầu ra và cách đọc
Theo dõi riêng MSE, commitment và số mã hoạt động. Mã chết là mã hầu như không được chọn; tùy thiết kế có thể khởi tạo lại từ latent gần đây hoặc điều chỉnh cân bằng. Dùng đủ mọi mã không phải mục tiêu duy nhất: dữ liệu đơn giản có thể chỉ cần vài mã.
4Profiling
- Kiểm đúng trước, đo sau
Đầu tiên kiểm đạo hàm decoder bằng nhiễu một tham số khi mã cố định. Đừng kiểm straight-through bằng sai phân của argmin rồi tuyên bố gradient đúng. Báo MSE train/validation và histogram số lượt chọn; nếu MSE giảm nhưng giọng méo, cần đánh giá cảm nhận và nội dung.
- Giới hạn kết luận
Không gộp commitment và reconstruction thành một con số rồi so giữa các BETA khác nhau; thang và mục tiêu đã thay đổi.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Đối chiếu ô 2C–2E và lab giai đoạn 3
Lab đo MSE train 0.232382 → 0.001859 và kiểm định 0.002234, với [3,5] mã hoạt động trên tám mã mỗi bảng. Commitment cuối 0.004943. Tự kiểm: đây có phải codec bị hỏng vì chưa dùng hết tám mã? Chưa đủ kết luận: tone có ít biến thể; hãy kiểm histogram và tái tạo trước khi can thiệp.
Tự thực hành có hướng dẫn
Mở [bài Lab tổng hợp](/courses/llm-training-audio/train-audio-lab/ta-end-to-end-lab/) rồi tìm khối [3] trong output. Viết lại đầu vào, kết quả và giới hạn của khối đó trước khi thử thay một hằng số. Nếu cơ chế chỉ được giải thích chứ chưa được thực thi, không ghi PASS của lab thành bằng chứng cho cơ chế ấy.
6Thuật ngữ
- Decoder, loss tái tạo và sức khỏe codebook
- Huấn luyện neural codec là tối ưu encoder, bảng mã và decoder để bản sóng khôi phục giữ thông tin cần thiết dưới ngân sách mã rời rạc.
Glossary (1)
- Đối chiếu sơ đồ
- Ô 2C–2E; giai đoạn 3 của lab. Không gộp commitment và reconstruction thành một con số rồi so giữa các BETA khác nhau; thang và mục tiêu đã thay đổi.