Huấn luyện tiếng nói
5A · Thích nghi người nói và LoRA
Phân biệt cung cấp mẫu giọng lúc suy luận với cập nhật tham số; dùng LoRA khi dữ liệu thích nghi cần ít bộ nhớ.
1Định nghĩa
Speaker adaptation là điều chỉnh mô hình bằng dữ liệu một giọng hoặc miền tiếng nói mới để thay đổi cách phát âm, âm sắc hoặc phong cách.
Speaker prompt trong TTS (chuyển chữ thành tiếng nói) có điều kiện có thể đổi giọng mà không học tham số. LoRA thực sự học: giữ ma trận W gốc và thêm B×A hạng thấp; chỉ A, B nhận gradient. Hai cách không đồng nghĩa dù cùng nhằm điều khiển giọng.
Ví dụ đời thường: đưa người đọc mẫu giọng để bắt chước ngay khác với cho họ luyện nhiều buổi rồi thay kỹ năng lâu dài. Một tấm thẻ nhắc giọng không tự là buổi huấn luyện.
2Luồng
Các ô cùng bài có thể là chẩn đoán hoặc lựa chọn thiết kế, không mặc định là các bước nối tiếp.
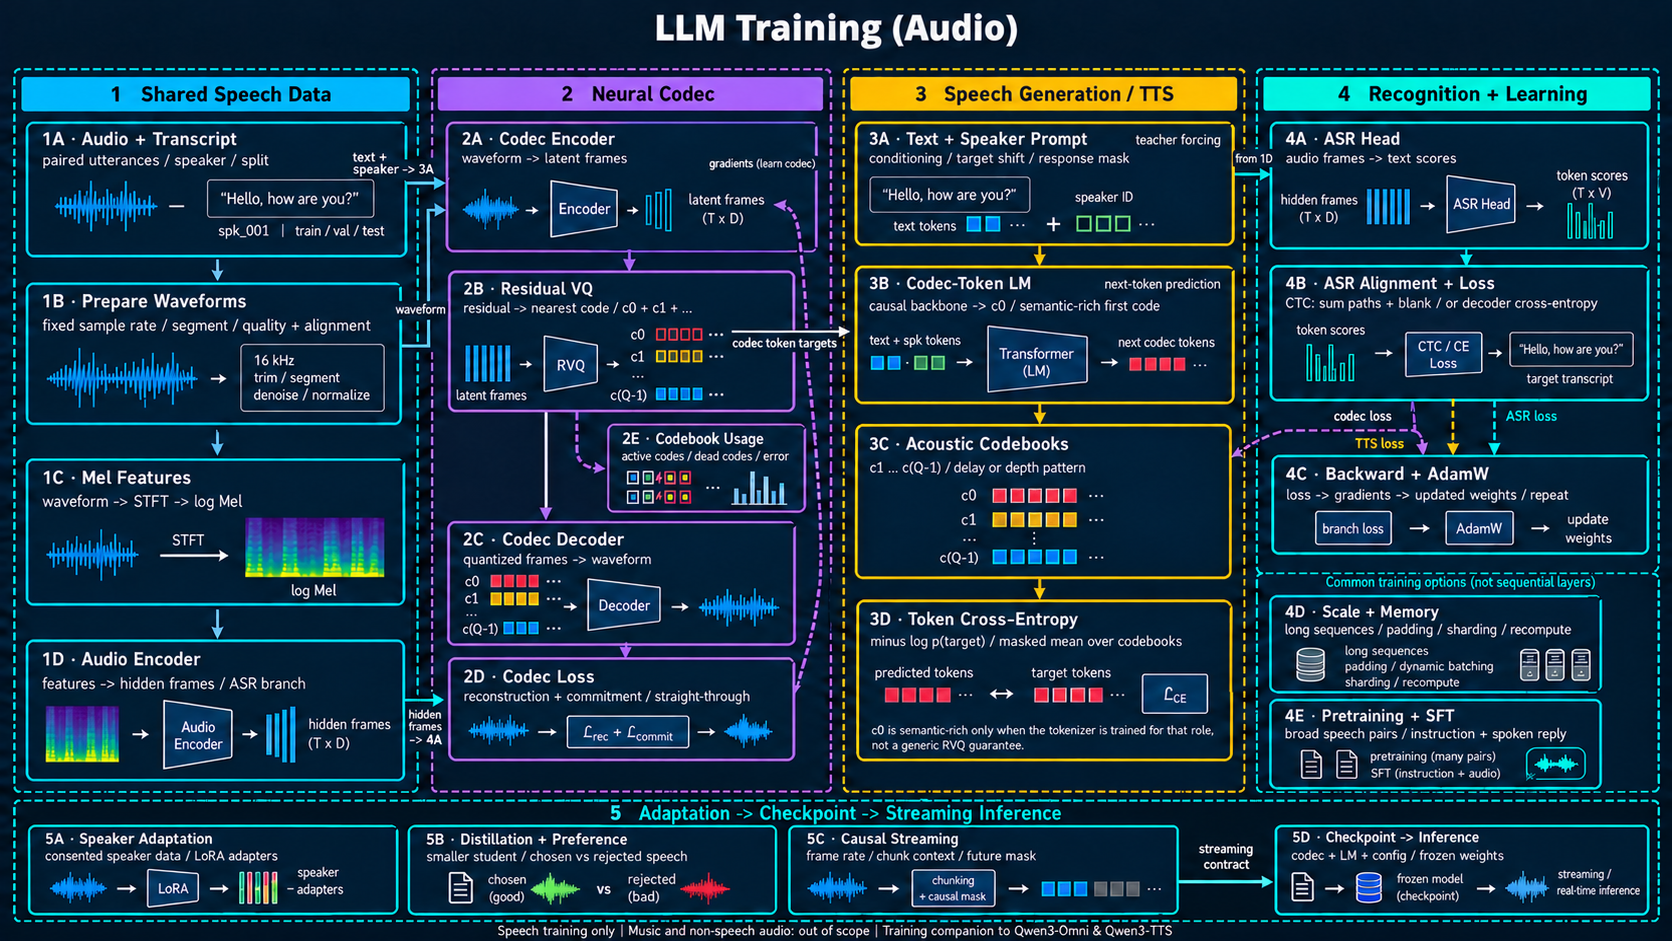
W đóng băng + B×A học được5A · Thích nghi giọng và LoRA
Phân biệt cung cấp mẫu giọng lúc suy luận với cập nhật tham số; dùng LoRA khi dữ liệu thích nghi cần ít bộ nhớ.
- Nhận gì
- Base checkpoint và dữ liệu giọng có đồng thuận, transcript khớp.
- Làm gì, vì sao
- Đóng băng W, học adapter B×A hạng thấp để đổi giọng hoặc miền mà không cập nhật toàn bộ W.
- Ra gì
- Adapter kèm định danh base/codec hoặc trọng số đã gộp được kiểm tương đương.
- Ví dụ, cách đọc ô
- Tính tay ma trận 16×16, rank 2: 64 tham số adapter so với 256 tham số gốc.
- Lưu ý
- Speaker prompt không sửa trọng số khác với fine-tune LoRA; lab không chạy adapter.
- Nhận đầu vào
Dùng dữ liệu có đồng thuận, transcript khớp và đủ nội dung/ngữ điệu đa dạng. Tách câu và bản ghi kiểm định để phát hiện học thuộc. Kiểm quyền dùng prompt và giới hạn sử dụng giọng cùng quy trình dữ liệu, không đưa dữ liệu tài khoản vào artifact.
- Biến đổi để học
Với W có d hàng và d cột, adapter rank r có 2dr tham số thay d². Khởi tạo một nhánh bằng 0 để mô hình ban đầu giữ hành vi gốc; chọn vị trí adapter trên backbone hoặc đầu dự đoán theo mục tiêu. LoRA giảm optimizer cho W nhưng không bỏ mọi activation hoặc bộ nhớ codec.
- Đọc kết quả
Lưu adapter kèm định danh base checkpoint, codec và cấu hình rank. Có thể gộp B×A vào W khi định dạng cho phép; kiểm đầu ra trước/sau gộp trong sai số số học. Nhầm base checkpoint có thể tạo âm sai mà vẫn nạp được kích thước.
Mã Mermaid
flowchart TD
  step1["Nhận đầu vào"]
  step2["Biến đổi để học"]
  step3["Đọc kết quả"]
  step1 --> step2
step2 --> step33Giải pháp
Đầu vào và kiến thức cần nhớ
Dùng dữ liệu có đồng thuận, transcript khớp và đủ nội dung/ngữ điệu đa dạng. Tách câu và bản ghi kiểm định để phát hiện học thuộc. Kiểm quyền dùng prompt và giới hạn sử dụng giọng cùng quy trình dữ liệu, không đưa dữ liệu tài khoản vào artifact.
Thao tác và lý do
Với W có d hàng và d cột, adapter rank r có 2dr tham số thay d². Khởi tạo một nhánh bằng 0 để mô hình ban đầu giữ hành vi gốc; chọn vị trí adapter trên backbone hoặc đầu dự đoán theo mục tiêu. LoRA giảm optimizer cho W nhưng không bỏ mọi activation hoặc bộ nhớ codec.
Đầu ra và cách đọc
Lưu adapter kèm định danh base checkpoint, codec và cấu hình rank. Có thể gộp B×A vào W khi định dạng cho phép; kiểm đầu ra trước/sau gộp trong sai số số học. Nhầm base checkpoint có thể tạo âm sai mà vẫn nạp được kích thước.
4Profiling
- Kiểm đúng trước, đo sau
Đánh giá cả độ giống giọng, nội dung, nhiễu và câu chưa gặp; đối chiếu phương án chỉ prompt trước khi fine-tune. Báo số tham số học, peak memory và khả năng quên giọng cũ, không suy chất lượng từ rank.
- Giới hạn kết luận
Tinh chỉnh trên ít phút không bảo đảm giữ phát âm và không thay thế đánh giá câu/người nói ngoài tập học.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Đối chiếu ô 5A và lab giai đoạn 8
Tính tay d=16, r=2: A và B có 64 tham số, so với 256 của W. Đây chỉ là một ma trận giả để hiểu tỷ lệ, không số đo hệ thật. Tự kiểm: nếu giữ prompt cố định mà A/B không đổi, có huấn luyện LoRA chưa? Chưa; phải có gradient và cập nhật adapter. Lab không triển khai adapter.
Tự thực hành có hướng dẫn
Mở [bài Lab tổng hợp](/courses/llm-training-audio/train-audio-lab/ta-end-to-end-lab/) rồi tìm khối [8] trong output. Viết lại đầu vào, kết quả và giới hạn của khối đó trước khi thử thay một hằng số. Nếu cơ chế chỉ được giải thích chứ chưa được thực thi, không ghi PASS của lab thành bằng chứng cho cơ chế ấy.
6Thuật ngữ
- Thích nghi người nói và LoRA
- Speaker adaptation là điều chỉnh mô hình bằng dữ liệu một giọng hoặc miền tiếng nói mới để thay đổi cách phát âm, âm sắc hoặc phong cách.
Glossary (1)
- Đối chiếu sơ đồ
- Ô 5A; giai đoạn 8 của lab. Tinh chỉnh trên ít phút không bảo đảm giữ phát âm và không thay thế đánh giá câu/người nói ngoài tập học.