Lab tổng hợp · 1A → 6B
Lab tổng hợp Qwen3-Omni & Qwen3-TTS-12Hz — chạy toàn trình 1A → 6B bằng NumPy
Chạy toàn trình kiến trúc Qwen3-Omni & Qwen3-TTS-12Hz bằng NumPy thuần: nén AuT 8×, TM-RoPE 3D, trích Lớp 24, đồng bộ Dual-Track 12.5 Hz, tự hồi quy 16-RVQ và giải mã sóng âm SnakeBeta.
1Định nghĩa
Bài học này là lab thực hành tổng hợp duy nhất của khóa Qwen3-Omni & Qwen3-TTS-12Hz Architecture, kết nối toàn bộ mười khối kiến trúc 1A đến 6B trên sơ đồ 4 cột thành một đường ống xử lý âm thanh - giọng nói khép kín chạy trực tiếp bằng NumPy trong trình duyệt. Bạn sẽ theo dõi một dải spectrogram Mel đi từ bộ mã hóa AuT 3× Conv2d stride-2 và trích ngang trạng thái ẩn Lớp 24 của Thinker sang vòng lặp đồng bộ Dual-Track 12.5 Hz của Talker.
Trọng tâm kỹ thuật của bài lab là chứng minh bằng số thật cách Qwen3-Omni vừa đạt độ trễ gói âm thanh đầu tiên 97 ms vừa giữ trọn độ trung thực của 16 sổ mã RVQ mà không cần mô hình Diffusion: tại mỗi khung 80 ms, Talker MoE chỉ dự đoán mã ngữ nghĩa chính c_0 rồi giao cho 5-Layer Depth Code Predictor tự hồi quy các mã âm học dư qua các đầu chiếu riêng, sau đó tra cứu một lần trên bảng nhúng gộp có độ lệch code_offset và phóng đại thành sóng âm qua hàm tuần hoàn SnakeBeta.
Ví dụ đời thường: Quy trình của lab giống như một đài phát thanh trực tiếp có ba bộ phận phối hợp nhịp nhàng: biên tập viên (Thinker Lớp 24) vừa nghĩ ra chữ nào là chuyển ngay xuống phòng đọc; phát thanh viên chính (Talker MoE) chốt cao độ âm tiết mỗi 80 ms cùng nhóm kỹ thuật viên âm sắc (Depth Code Predictor) điền đủ các hài âm; cuối cùng bộ khuếch đại sóng tuần hoàn (SnakeBeta Code2Wav) biến các mã số rời rạc thành sóng âm liên tục phát ra loa. Phép so sánh này dừng lại ở chỗ mọi bước trong lab đều là phép nhân ma trận và tích chập nhân quả tất định trên mảng NumPy.
2Luồng
Cách đọc hình 4 cột: bắt đầu ở 1A dưới đáy Cột 1 đi lên 1B → 2A; sang Cột 2 đi từ 3A → 3B → 3C để sinh mã ngữ nghĩa c_0; sang Cột 3 tại 4A (Depth Code Predictor sinh các mã âm học dư) xuống 6A (tra bảng nhúng gộp RVQ bằng code_offset và lấy trung bình); sau đó sang Cột 4 từ Pre-Transformer 5A ở dưới đi lên bộ giải mã sóng âm SnakeBeta 6B ở trên đỉnh. Mọi số liệu bên dưới lấy nguyên văn từ qwen3-omni-speech.py (seed 30).
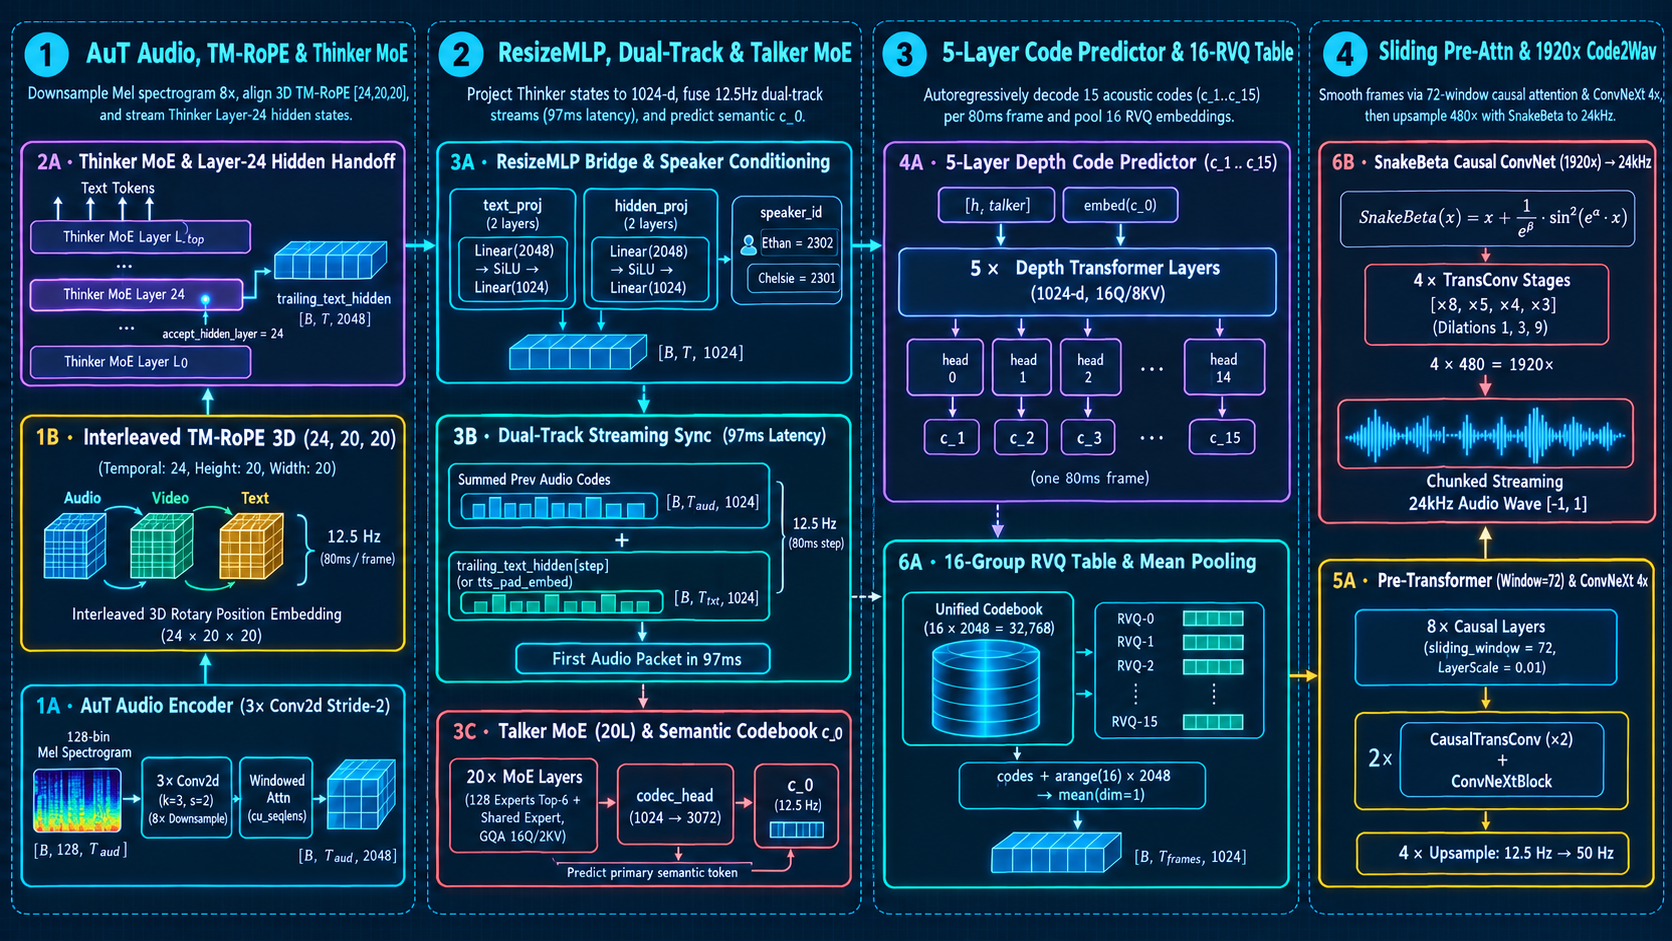
Mel [B, 128, T_mel] → 3× Conv2d(k=3, s=2) (8× Downsample) → Windowed Attn (cu_seqlens) → [B, T_aud, 2048]1A · AuT Audio Encoder (3× Conv2d Stride-2)
Điểm xuất phát ở đáy Cột 1: nén spectrogram 128 kênh Mel giảm 8 lần theo cả tần số lẫn thời gian qua 3 tầng Conv2d stride-2 và Windowed Attention.
Bắt đầu đọc sơ đồ từ góc dưới bên trái (1A): Qwen3OmniMoeAudioEncoder chia dải Mel spectrogram 128 kênh thành từng cửa sổ n_window, đưa qua 3 lớp tích chập 2 chiều Conv2d(kernel=3, stride=2) liên tiếp để giảm 2³ = 8 lần độ dài thời gian và số kênh tần số. Chuỗi đặc trưng sau đó cộng SinusoidsPositionEmbedding, chạy Attention cục bộ theo ranh giới cu_seqlens và chiếu qua MLP (1280 → GELU → 2048) để khớp với không gian ẩn của Thinker.
- 1A–1B · Nén AuT 8× & Xoay Interleaved TM-RoPE 3D
Hạ mẫu Mel (8, 16) → (1, 2) qua 3× Conv2d stride-2 và xoay 3 cặp tần số (T, H, W) bảo toàn chuẩn Euclid (sai lệch 0.00e+00).
- 2A–3A · Trích ngang Lớp 24 & Cầu nối ResizeMLP kép
Lấy trailing_text_hidden tại Lớp 24 của Thinker, hạ chiều từ 8 xuống 6 qua SiLU ResizeMLP và gắn hồ sơ giọng speaker_id = 2302 (Ethan).
- 3B–3C · Đồng bộ Dual-Track 12.5 Hz & Talker MoE sinh c_0
Ghép mã âm thanh bước trước với chữ (hoặc tts_pad_embed), định tuyến Top-2/6 chuyên gia (tổng trọng số 1.0000) và chọn c_0 = 4.
- 4A · 5-Layer Depth Code Predictor tự hồi quy c_1..c_3
Khởi tạo từ [h_talker, embed(c_0)] và chạy 3 bước vi mô qua lm_head[0..2] thu đủ bộ mã [4, 1, 6, 4] cho khung 0.
- 6A · Tra bảng RVQ gộp bằng code_offset & Mean Pooling
Cộng code_offset [0, 8, 16, 24] để ánh xạ [4, 1, 6, 4] thành dòng [4, 9, 22, 28] trong bảng 32 dòng rồi lấy trung bình.
- 5A–6B · Pre-Transformer (Window=2) & SnakeBeta 12× → Sóng âm
Áp dụng mặt nạ nhân quả cửa sổ trượt 2 khung, phóng đại 2 × 2 × 3 = 12 mẫu/khung bằng hàm tuần hoàn SnakeBeta ra 48 mẫu sóng âm.
Mã Mermaid
flowchart TD
  step1["1A–1B · Nén AuT 8× #amp; Xoay Interleaved TM-RoPE 3D"]
  step2["2A–3A · Trích ngang Lớp 24 #amp; Cầu nối ResizeMLP kép"]
  step3["3B–3C · Đồng bộ Dual-Track 12.5 Hz #amp; Talker MoE sinh c_0"]
  step4["4A · 5-Layer Depth Code Predictor tự hồi quy c_1..c_3"]
  step5["6A · Tra bảng RVQ gộp bằng code_offset #amp; Mean Pooling"]
  step6["5A–6B · Pre-Transformer (Window=2) #amp; SnakeBeta 12× → Sóng âm"]
  step1 --> step2
  step2 --> step3
  step3 --> step4
  step4 --> step5
step5 --> step63Giải pháp
Mục tiêu thực hành: sau khi đọc 10 bài giải phẫu ở Tab 01, bài lab này giúp bạn tự tay kiểm chứng toàn bộ đường ống âm thanh - giọng nói của Qwen3-Omni & Qwen3-TTS-12Hz trên một cấu hình thu nhỏ tất định (seed 30, THINKER_DIM = 8, TALKER_DIM = 6, 4 tầng RVQ × 8 mã, 4 khung 12.5 Hz, tổng hệ số phóng đại sóng âm 12×). Mọi bước đều in ra số thực cụ thể để bạn đối chiếu 1:1 với công thức trong mã nguồn.
Ở Cột 1 (1A → 1B → 2A), dải Mel đầu vào có kích thước (8, 16) đi qua 3 tầng Conv2d stride-2 giảm lần lượt còn (4, 8) → (2, 4) → (1, 2), tức giảm đúng 8 lần chiều thời gian từ 16 khung xuống 2 khung trước khi chạy Windowed Attention theo cu_seqlens = (0, 1, 2). Tại 1B, phép quay Interleaved TM-RoPE 3D xoay 3 cặp tần số đan xen (T, H, W) mà vẫn giữ nguyên chuẩn Euclid ||RoPE(q)|| = ||q|| = 0.353998 (sai lệch 0.00e+00). Tại 2A, Thinker sinh 2 token văn bản và trích ngang trạng thái ẩn Lớp 24 làm luồng trailing_text_hidden.
Ở Cột 2 (3A → 3B → 3C), hai cầu nối ResizeMLP hạ chiều nhúng chữ và trạng thái Lớp 24 từ (2, 8) xuống (2, 6) kèm vector giọng đọc speaker_id = 2302 (Ethan). Tại 3B, vòng lặp 4 khung 80 ms cho thấy rõ cơ chế Dual-Track: Khung 0 và Khung 1 lấy chữ từ trailing_text_hidden[0] và [1], còn khi chữ đã hết ở Khung 2 và Khung 3 thì mô hình tự động lấy vector đệm tts_pad_embed. Tại 3C, bộ định tuyến Talker MoE chọn Top-2 chuyên gia [0, 2] với trọng số chuẩn hóa [0.538, 0.462] (tổng = 1.0000) và chọn mã ngữ nghĩa c_0 = 4.
Ở Cột 3 và Cột 4 (4A → 6A → 5A → 6B), mạng Depth Code Predictor ở 4A nhận [h_talker, embed(c_0)] (chiều dài chuỗi nội bộ tăng từ 2 → 3 → 4) và dùng 3 đầu chiếu riêng lm_head[0..2] để sinh thêm c_1 = 1, c_2 = 6, c_3 = 4, tạo thành bộ mã [4, 1, 6, 4] cho Khung 0. Tại 6A, vector độ lệch code_offset = [0, 8, 16, 24] dịch bộ mã [4, 1, 6, 4] thành chỉ số dòng [4, 9, 22, 28] trên bảng gộp 32 dòng. Cuối cùng, khối 5A áp dụng mặt nạ nhân quả cửa sổ trượt 2 khung + phóng đại 2× (4 → 8 bước), và khối 6B dùng hàm tuần hoàn SnakeBeta phóng đại thêm 2 × 3 = 6× (tổng 12 mẫu/khung) để xuất 48 mẫu sóng âm nằm trong [-1, 1].
Giới hạn của kết luận: ba phép kiểm chứng cuối bài xác nhận (1) bảng gộp code_offset khớp tuyệt đối 0.00e+00 với 4 bảng rời; (2) chuẩn Euclid của TM-RoPE 3D và tổng trọng số Top-K MoE có sai số 0.00e+00; và (3) bộ giải mã Code2Wav đảm bảo tính nhân quả tuyệt đối (thay đổi khung cuối không rò rỉ 0.00e+00 về 3 khung đầu) đồng thời giải mã theo từng chunk có ghép left_context = 1 khớp 0.00e+00 với giải mã toàn chuỗi. Tuy nhiên, vì trọng số được khởi tạo ngẫu nhiên với seed 30, 48 mẫu sóng âm đầu ra chỉ dùng để kiểm chứng kiến trúc chứ không phát ra tiếng nói thật.
4Profiling
- Kiểm tra tính tương đương của Bảng nhúng gộp RVQ (Offset Indexing)
Đối chiếu kết quả của phép tra bảng gộp UNIFIED_RVQ_TABLE[codes + CODE_OFFSET].mean(axis=0) với trung bình cộng của 4 lần tra bảng con rời rạc: sai lệch tuyệt đối tối đa bằng đúng 0.00e+00.
- Kiểm tra cô lập nhân quả khi phát trực tuyến (Causal Streaming Isolation)
Thay đổi toàn bộ các mã RVQ tại khung thời gian cuối cùng (frame 3) rồi chạy lại toàn bộ Pre-Transformer và SnakeBeta Code2Wav: đo độ lệch trên 3 × 12 = 36 mẫu sóng âm của 3 khung đầu tiên (frames 0..2). Kết quả bằng 0.00e+00 chứng minh không có bất kỳ phép tính nào nhìn trộm sang khung tương lai.
- Kiểm tra tính khớp nối của Chunked Decode có Left Context
Chia 4 khung mã thành 2 chunk (mỗi chunk 2 khung, kèm left_context_size = 1 khung lịch sử bên trái) và cắt bỏ 1 × 12 = 12 mẫu đệm đầu của chunk thứ hai: toàn bộ 48 mẫu sóng âm thu được khớp tuyệt đối (sai lệch 0.00e+00) so với giải mã cả 4 khung trong một lần.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Bước 1 · Đọc quá trình hạ mẫu 8× của AuT và phép xoay TM-RoPE ở [1A] & [1B]
Chạy lab và xem mục [1A]: ma trận Mel (8, 16) đi qua 3 tầng conv2d stride-2 thu nhỏ dần thành (4, 8) → (2, 4) → (1, 2), giảm từ 16 khung xuống đúng 2 khung. Ở mục [1B], kiểm tra chuẩn Euclid của vector trước khi xoay (0.353998) và sau khi xoay 3 trục TM-RoPE (0.353998): độ lệch bằng 0.00e+00.
Bước 2 · Theo dõi chuyển giao Lớp 24 và vòng lặp Dual-Track ở [2A], [3A], [3B]
Ở mục [3B], quan sát nguồn chữ được cộng vào ở từng khung 80 ms: Khung 0 lấy trailing_text_hidden[0], Khung 1 lấy trailing_text_hidden[1], và ngay khi hết 2 token chữ thì Khung 2 và Khung 3 tự động chuyển sang lấy tts_pad_embed để duy trì chuỗi âm thanh.
Bước 3 · Kiểm tra tự hồi quy chiều sâu [4A], bảng gộp [6A] và sóng âm [6B]
Ở mục [4A], sau khi Talker chọn c_0 = 4 ở [3C], Depth Code Predictor chạy 3 bước vi mô (chiều dài chuỗi nội bộ tăng 2 → 3 → 4) sinh ra c_1 = 1, c_2 = 6, c_3 = 4. Sang [6A], cộng bộ mã [4, 1, 6, 4] với code_offset [0, 8, 16, 24] cho ra đúng dòng [4, 9, 22, 28]. Cuối cùng ở [6B] và [KIỂM TRA & THỬ NGHIỆM], kiểm tra 4 khung × 12 mẫu/khung = 48 mẫu sóng âm và 3 phép kiểm chứng đều đạt 0.00e+00.
6Thuật ngữ
- 3× Conv2d Stride-2 (8× Downsampling)
- Hạ mẫu dải Mel (8, 16) qua 3 tầng tích chập bước nhảy 2 liên tiếp: (8, 16) → (4, 8) → (2, 4) → (1, 2), giảm đúng 8 lần số khung thời gian.
- Dual-Track Sync (trailing_text_hidden + tts_pad_embed)
- Khung 0 và 1 cộng vector chữ thật từ Lớp 24; khi hết chữ ở khung 2 và 3, Talker tự động chuyển sang cộng vector đệm tts_pad_embed.
- Depth Autoregression (c_0 → c_1 .. c_3)
- Talker chọn mã ngữ nghĩa c_0 = 4, sau đó Depth Code Predictor chạy 3 bước vi mô qua lm_head[0..2] để sinh c_1 = 1, c_2 = 6, c_3 = 4.
- code_offset = [0, 8, 16, 24] (Prod: arange(16) × 2048)
- Vector độ lệch cộng vào từng tầng RVQ để tra cứu toàn bộ các tầng trong một bảng nhúng gộp duy nhất với sai lệch 0.00e+00.
Glossary (4)
- Thinker–Talker Dual-Track
- Kiến trúc tách khối suy luận sinh chữ (Thinker) và khối phát mã giọng nói 12.5 Hz (Talker) nối với nhau qua trạng thái ẩn Lớp 24.
- Depth Code Predictor
- Mạng Transformer 5 lớp tự hồi quy theo chiều sâu để sinh các mã âm học dư c_1..c_15 trong cùng một khung 80 ms.
- Unified RVQ Offset Table
- Gộp N sổ mã kích thước K vào một bảng (N×K) dòng và cộng độ lệch q×K khi tra cứu.
- SnakeBeta Causal ConvNet
- Bộ giải mã sóng âm nhân quả dùng hàm kích hoạt tuần hoàn x + (1/e^β)·sin²(e^α·x) phóng đại 1920× lên 24 kHz.
7Bài liên quan
8Nguồn
9Bài lab
Chạy thử toàn bộ kiến trúc Qwen3-Omni & Qwen3-TTS-12Hz (1A → 6B) bằng NumPy
Thực hành NumPy · giải phẫu toàn trình Qwen3-Omni & TTS-12Hz (1A–6B)Đây là bài Lab tổng hợp duy nhất của khóa học: một script NumPy chạy toàn trình từ nén spectrogram AuT 8× (1A), xoay TM-RoPE 3D (1B), trích Lớp 24 & ResizeMLP (2A–3A), đồng bộ Dual-Track & Talker MoE (3B–3C) đến tự hồi quy Depth Code Predictor, tra bảng RVQ gộp và giải mã sóng âm SnakeBeta (4A–6B). Hãy đọc hướng dẫn rồi bấm Chạy.
Bạn sẽ học được gì?
Sau bài lab này, bạn sẽ giải thích được bằng số cụ thể 5 cơ chế cốt lõi của Qwen3-Omni & Qwen3-TTS-12Hz: (1) cách 3 tầng Conv2d stride-2 nén giảm 8× độ dài spectrogram; (2) cách trích ngang trạng thái ẩn Lớp 24 của Thinker và hạ chiều qua ResizeMLP; (3) cách ghép luồng chữ và luồng âm thanh ở nhịp 12.5 Hz (khi hết chữ tự động chuyển sang tts_pad_embed); (4) cách tách dự đoán mã ngữ nghĩa c_0 (bởi Talker MoE) và các mã âm học dư (bởi Depth Code Predictor) rồi tra bảng gộp qua code_offset; và (5) cách phóng đại khung mã thành sóng âm nhân quả bằng SnakeBeta.
Mỗi khối từ [1A] đến [6B] trong màn hình kết quả khớp 1:1 với 10 khối trên sơ đồ 4 cột ở phía trên và 10 bài học ở Tab 01.
Đầu vào và cấu hình thu nhỏ của bài lab
Đầu vào gồm 1 dải Mel spectrogram có shape (8, 16) (8 kênh Mel × 16 khung thời gian), 2 token văn bản do Thinker sinh ra, và mã giọng đọc speaker_id = 2302 (Ethan). Vòng lặp phát giọng nói chạy qua 4 khung thời gian ở nhịp 12.5 Hz (mỗi khung 80 ms).
Cấu hình thu nhỏ giữ nguyên cấu trúc của bản thật: THINKER_DIM = 8 (bản thật 2048), TALKER_DIM = 6 (bản thật 1024), 6 chuyên gia chọn Top-2 (bản thật 128 chọn Top-6), 4 sổ mã RVQ × 8 mục (bản thật 16 × 2048), cửa sổ trượt SLIDING_WINDOW = 2 (bản thật 72), hệ số phóng đại sóng âm 2 × (2 × 3) = 12 mẫu/khung (bản thật 4 × 480 = 1920 mẫu/khung), seed cố định 30.
Bảng ánh xạ 1:1 giữa Sơ đồ Kiến trúc (Tab 1) và Code Lab (Tab 2)
Cột 1 & 2: [1A] run_aut_encoder nén (8, 16) → (1, 2); [1B] apply_interleaved_tm_rope xoay 3 cặp tần số (T, H, W); [2A] run_thinker_handoff trích h24; [3A] resize_text_mlp và resize_hidden_mlp hạ chiều 8 → 6; [3B] run_dual_track_frames ghép luồng qua 4 khung; [3C] talker_moe_step chọn Top-2 chuyên gia và dự đoán c_0 = 4.
Cột 3 & 4: [4A] run_depth_code_predictor tự hồi quy 3 bước sinh c_1 = 1, c_2 = 6, c_3 = 4; [6A] lookup_rvq_offset_mean cộng code_offset [0, 8, 16, 24] tra bảng gộp 32 dòng; [5A] run_pre_transformer_and_upsample áp mặt nạ cửa sổ trượt 2 khung và nhân 2× thời gian; [6B] run_snakebeta_decoder và chunked_decode_codes phóng đại thêm 6× (tổng 12×) ra 48 mẫu sóng âm.
Cách thực hiện và đọc từng khối output 1A–6B
1. Bấm nút Chạy cell. Ở [1A]–[2A], kiểm tra kích thước Mel giảm từ (8, 16) xuống (1, 2), độ lệch chuẩn Euclid sau TM-RoPE bằng 0.00e+00 và vector trích ngang tại Lớp 24.
2. Ở [3A]–[4A], xem 4 khung Dual-Track chuyển từ trailing_text_hidden[0..1] sang tts_pad_embed ở khung 2..3, trọng số Top-2 chuyên gia [0.538, 0.462] có tổng bằng 1.0000, và 3 bước Depth Predictor sinh ra bộ mã [4, 1, 6, 4].
3. Ở [6A], [5A], [6B] và [KIỂM TRA & THỬ NGHIỆM], đối chiếu phép dịch chỉ số [4, 1, 6, 4] + [0, 8, 16, 24] = [4, 9, 22, 28], ma trận mặt nạ cửa sổ trượt 4×4 và 3 kết luận kiểm chứng đều đạt 0.00e+00.
Kết quả này chứng tỏ điều gì và giới hạn ở đâu?
Ba phép kiểm chứng ở cuối output xác nhận: (1) tra cứu 1 lần trên bảng nhúng gộp với code_offset cho kết quả khớp tuyệt đối (0.00e+00) với tra 4 bảng rời; (2) phép quay 3D TM-RoPE bảo toàn chuẩn Euclid (0.00e+00) và bộ định tuyến MoE bảo toàn tổng xác suất 1.0; (3) toàn bộ bộ giải mã Code2Wav đảm bảo tính nhân quả tuyệt đối (đổi khung cuối không rò rỉ 0.00e+00 về các khung trước) và giải mã theo từng chunk có ghép left_context = 1 khớp 0.00e+00 với giải mã toàn chuỗi.
Giới hạn: trọng số trong lab được khởi tạo ngẫu nhiên với seed 30 chưa qua huấn luyện nên 48 mẫu sóng âm đầu ra chỉ dùng để kiểm chứng đường đi của tensor và tính đúng đắn toán học, không phát ra âm thanh lời nói thật.
Kết quả mong đợiOutput chia làm 10 khối [1A]..[6B] và [KIỂM TRA & THỬ NGHIỆM]. Mốc kiểm tra nhanh: Mel (8, 16) hạ mẫu 8× còn (1, 2); chuẩn TM-RoPE 0.353998 (lệch 0.00e+00); Khung 0 sinh bộ mã [4, 1, 6, 4] dịch thành [4, 9, 22, 28]; 4 khung nở thành 48 mẫu sóng âm; và 3 phép kiểm chứng đều báo 0.00e+00 + PASS.
Bài tập 1 · Đọc quá trình chuyển sang tts_pad_embed ở bước 3B
Quan sát mục [3B] trong kết quả chạy: khi Thinker chỉ sinh ra 2 token văn bản nhưng câu nói kéo dài 4 khung âm thanh (Khung 0..3), nguồn điều kiện chữ ở Khung 0, 1 khác gì so với Khung 2, 3?
Đối chiếu sau khi tự trả lời
Ở Khung 0 và Khung 1 (khi chỉ số khung t < 2), Talker lấy trực tiếp trailing_text_hidden[0] và trailing_text_hidden[1] do Lớp 24 của Thinker truyền xuống. Từ Khung 2 và Khung 3 trở đi (t >= 2, khi hàng đợi chữ đã tiêu thụ hết), Talker tự động chuyển sang cộng vector đệm cố định tts_pad_embed để duy trì nhịp phát âm cho đến khi gặp mã kết thúc.
Bài tập 2 · Kiểm tra phép dịch chỉ số code_offset trên bảng RVQ gộp ở bước 6A
Ở Khung 0, bộ 4 mã thu được sau bước [3C] và [4A] là [c_0, c_1, c_2, c_3] = [4, 1, 6, 4]. Với mỗi sổ mã có kích thước CODEBOOK_SIZE = 8 (code_offset = [0, 8, 16, 24]), hãy tính tay 4 chỉ số dòng được tra trong bảng gộp 32 dòng và đối chiếu với mục [6A].
Đối chiếu sau khi tự trả lời
Cộng từng mã với độ lệch tầng tương ứng q × 8: tầng 0 là 4 + 0 = 4; tầng 1 là 1 + 8 = 9; tầng 2 là 6 + 16 = 22; tầng 3 là 4 + 24 = 28. Bộ chỉ số [4, 9, 22, 28] khớp chính xác với cột đầu tiên của ma trận chỉ số dịch ở mục [6A].
Bài tập 3 · Giải thích ma trận mặt nạ cửa sổ trượt 4×4 ở bước 5A
Nhìn vào ma trận mặt nạ 4×4 ở mục [5A] (với SLIDING_WINDOW = 2): vì sao ở hàng q = 2, vị trí k = 0 lại bị chặn (dấu chấm) dù k = 0 nằm ở quá khứ của q = 2?
Đối chiếu sau khi tự trả lời
Vì điều kiện của mặt nạ nhân quả cửa sổ trượt với W = 2 là 0 <= q - k < 2: tại hàng q = 2, chỉ có k = 1 (khoảng cách 2 - 1 = 1 < 2) và k = 2 (khoảng cách 2 - 2 = 0 < 2) nằm trong cửa sổ trượt, còn k = 0 có khoảng cách 2 - 0 = 2 >= W nên bị cắt bỏ để giới hạn chi phí tính toán khi phát trực tuyến dài.
Bài tập 4 · Vì sao Chunked Decode cần ghép thêm left_context_size ở bước 6B?
Trong kiểm chứng (3) ở cuối bài, khi giải mã chunk thứ hai (gồm Khung 2 và Khung 3), vì sao hàm chunked_decode_codes phải lấy lùi thêm 1 khung bên trái (tức đưa Khung 1, 2, 3 vào rồi cắt bỏ 12 mẫu đầu) thì mới khớp 0.00e+00 với giải mã liền một mạch?
Đối chiếu sau khi tự trả lời
Vì trong khối 5A có lớp Pre-Transformer với cửa sổ trượt SLIDING_WINDOW = 2: để tính đúng trạng thái ẩn của Khung 2, lớp Attention nhân quả cần đọc cả Khung 1 đứng ngay trước nó. Nhờ ghép thêm left_context_size = 1 khung lịch sử (Khung 1) rồi cắt bỏ 1 × 12 = 12 mẫu sóng âm tương ứng với Khung 1 ở đầu ra, kết quả của Khung 2 và Khung 3 trùng khớp tuyệt đối (sai lệch 0.00e+00) với giải mã toàn chuỗi.