3A · ResizeMLP & Speaker Prompt
3A · Cầu nối ResizeMLP kép (2048 → 1024) & Điều kiện hóa giọng đọc Speaker ID
Hai mạng MLP hai tầng có kích hoạt SiLU hạ chiều nhúng chữ và trạng thái ẩn Lớp 24 từ 2048 về 1024, kết hợp mã định danh giọng đọc Speaker ID.
1Định nghĩa
Mũi tên từ đỉnh Cột 1 (Thinker Lớp 24) đi sang đầu Cột 2 gặp ngay một bài toán khớp kích thước: Thinker là mô hình lớn dùng chiều ẩn 2048, trong khi Talker cần chạy cực nhanh ở tần số 12.5 Hz nên được thiết kế gọn với chiều ẩn 1024. Khối 3A giải quyết việc chuyển đổi này bằng hai cầu nối phi tuyến riêng biệt mang tên text_projection và hidden_projection (cùng thuộc lớp Qwen3OmniMoeTalkerResizeMLP).
Mỗi cầu nối Qwen3OmniMoeTalkerResizeMLP là một mạng MLP 2 tầng có hàm kích hoạt SiLU: tầng thứ nhất giữ nguyên hoặc mở rộng về intermediate_size = 2048, đi qua SiLU, rồi tầng thứ hai hạ chiều xuống hidden_size = 1024. Đồng thời, tại bước khởi tạo chuỗi prefill cho Talker, hệ thống chèn mã giọng đọc speaker_id (chẳng hạn Ethan = 2302, Chelsie = 2301, Aiden = 2303) để định hình màu giọng trước khi vào bộ đồng bộ Dual-Track ở 3B.
Ví dụ đời thường: Hãy hình dung một biên tập viên chuyển bản thảo học thuật dày (2048 chiều) thành kịch bản phát thanh ngắn gọn (1024 chiều) qua hai bộ lọc: một bộ lọc tóm lược mặt chữ (text_projection) và một bộ lọc ghi chú sắc thái giọng (hidden_projection), đồng thời đính kèm thẻ tên phát thanh viên (Ethan hoặc Chelsie) ở đầu trang để phòng thu chọn đúng người đọc. Phép so sánh này dừng lại ở chỗ ResizeMLP là phép nhân ma trận liên tục chứ không cắt bỏ câu chữ.
2Luồng
Cách đọc hình (Cột 2, khối 3A trên đỉnh): nhận luồng 2048 chiều từ 2A sang đầu Cột 2, đưa qua hai nhánh text_proj và hidden_proj (Linear → SiLU → Linear về 1024 chiều) kèm thẻ speaker_id rồi truyền xuống 3B; xem bước [3A] trong [Bài Lab tổng hợp Qwen3-Omni](/courses/qwen3-omni-speech/qwen3-omni-lab/qwen3-omni-end-to-end-lab/) ở Tab 02.
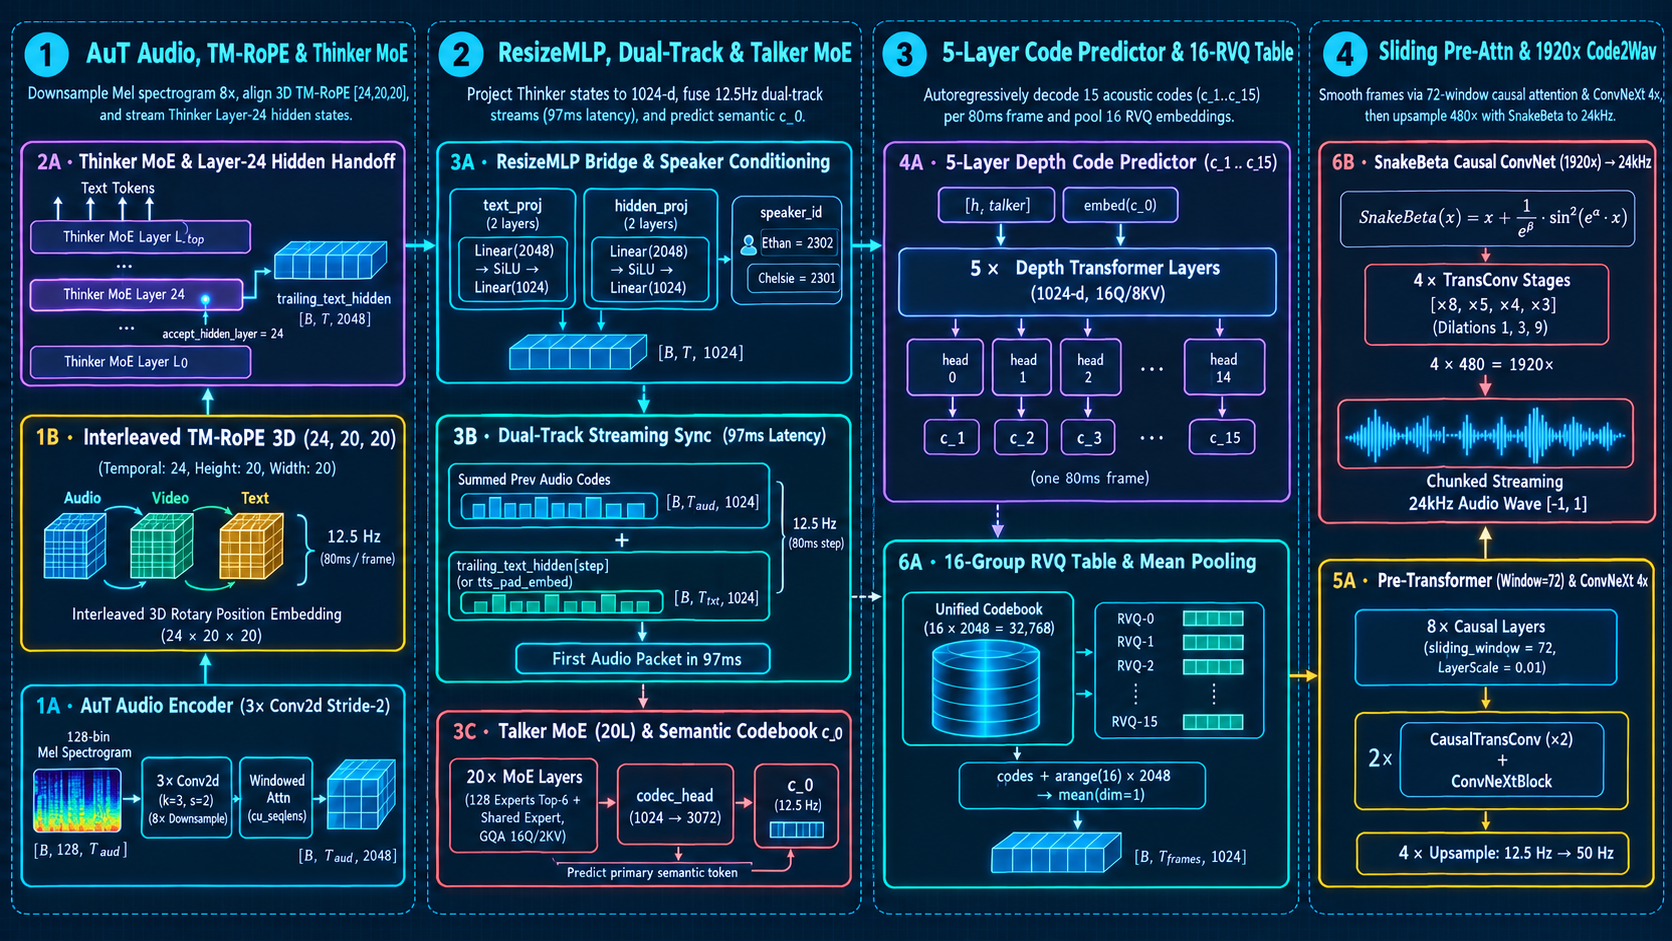
text_proj & hidden_proj: Linear(2048 → 2048) → SiLU → Linear(2048 → 1024) + speaker_id (Ethan=2302, Chelsie=2301)3A · ResizeMLP Bridge & Speaker Conditioning
Đầu Cột 2: hạ chiều luồng chữ và trạng thái ẩn Lớp 24 từ 2048 về 1024 thông qua hai cầu nối ResizeMLP riêng biệt và gắn mã giọng đọc Speaker ID.
Mũi tên từ 2A sang 3A ở đầu Cột 2: vì Thinker hoạt động ở chiều ẩn 2048 trong khi Talker được thiết kế gọn nhẹ ở chiều 1024 để đạt tốc độ thời gian thực, hai mô-đun Qwen3OmniMoeTalkerResizeMLP (text_projection và hidden_projection) thực hiện phép chiếu phi tuyến Linear(2048 → 2048) → SiLU → Linear(2048 → 1024). Đầu chuỗi prefill của Talker đồng thời được gắn mã định danh người nói speaker_id (như Ethan = 2302, Chelsie = 2301, Aiden = 2303) để khóa màu giọng xuyên suốt câu trả lời.
- 1. Nhận nhúng chữ và trạng thái ẩn Lớp 24 từ Thinker
Lấy embed(talker_input_ids) ∈ [B, T, 2048] và hidden_states[24] ∈ [B, T, 2048].
- 2. Chiếu qua text_projection & hidden_projection
Áp dụng Linear(2048 → 2048) → SiLU → Linear(2048 → 1024) cho từng luồng riêng biệt.
- 3. Gắn token điều khiển giọng đọc (speaker_id & codec_bos)
Chèn mã speaker_id (ví dụ Ethan = 2302) và codec_bos_id = 2149 vào đầu chuỗi điều kiện của Talker.
- 4. Chuyển luồng 1024 chiều xuống bộ ghép Dual-Track
Cung cấp trailing_text_hidden [B, T, 1024] đã hạ chiều cho vòng lặp 12.5 Hz ở khối 3B.
Mã Mermaid
flowchart TD
  step1["1. Nhận nhúng chữ và trạng thái ẩn Lớp 24 từ Thinker"]
  step2["2. Chiếu qua text_projection #amp; hidden_projection"]
  step3["3. Gắn token điều khiển giọng đọc (speaker_id #amp; codec_bos)"]
  step4["4. Chuyển luồng 1024 chiều xuống bộ ghép Dual-Track"]
  step1 --> step2
  step2 --> step3
step3 --> step43Giải pháp
Công thức toán học chính xác của lớp Qwen3OmniMoeTalkerResizeMLP trong modeling_qwen3_omni_moe.py là: $$y = W_2 \cdot \text{SiLU}(W_1 x + b_1) + b_2, \quad W_1 \in \mathbb{R}^{2048 \times 2048}, ; W_2 \in \mathbb{R}^{1024 \times 2048}$$ trong đó $\text{SiLU}(z) = z \cdot \sigma(z) = \frac{z}{1 + e^{-z}}$. Việc tách riêng hai bộ trọng số text_projection (dùng cho nhúng token văn bản ở bước prefill) và hidden_projection (dùng cho trạng thái ẩn Lớp 24 ở các bước phát trực tuyến) giúp mô hình không trộn lẫn hai phân phối có biên độ khác nhau.
Cách điều khiển giọng nói bằng speaker_id: trong bảng từ vựng 3072 mã của Talker, các chỉ số từ 2048 trở lên được dành riêng cho các token điều khiển đặc biệt (control tokens), bao gồm codec_pad_id = 2148, codec_bos_id = 2149, codec_eos_token_id = 2150 và các mã người nói Chelsie = 2301, Ethan = 2302, Aiden = 2303. Khi suy luận, các mã đặc biệt ở vùng cuối từ vựng bị chặn (talker_suppressed_tokens) ở đầu ra để Talker chỉ phát ra đúng các mã âm thanh hợp lệ.
Bạn có thể kiểm tra trực tiếp phép hạ chiều 2048 → 1024 (trong lab thu nhỏ là 8 → 6) và tác động của speaker_id lên chuỗi mã âm thanh tại mục [3A] trong Bài Lab tổng hợp Qwen3-Omni.
4Profiling
- Chi phí tính toán của cầu nối ResizeMLP
Chỉ chạy đúng 1 lần cho mỗi token văn bản (khoảng vài chục token mỗi câu) thay vì chạy ở mỗi khung âm thanh, nên chiếm chưa tới 0,5% tổng FLOPs của Talker.
- Độ nhạy điều khiển giọng theo speaker_id
Giữ nguyên câu văn bản từ Thinker và đổi speaker_id từ 2302 (Ethan) sang 2301 (Chelsie): kiểm tra vector prefill của Talker và chuỗi mã âm thanh đầu ra thay đổi hoàn toàn về âm sắc trong khi vẫn giữ nguyên nhịp nội dung.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
So sánh kích thước tensor trước và sau ResizeMLP
Mỗi token văn bản đi ra từ Lớp 24 của Thinker có chiều 2048; sau khi đi qua hidden_projection (Linear 2048→2048, SiLU, Linear 2048→1024), vector thu gọn còn 1024 chiều — khớp khít với chiều ẩn của 20 lớp Talker MoE.
6Thuật ngữ
- Qwen3OmniMoeTalkerResizeMLP
- Mô-đun chiếu 2 tầng Linear(2048 → 2048) → SiLU → Linear(2048 → 1024) nối không gian Thinker với không gian Talker.
- text_projection vs hidden_projection
- Hai bộ trọng số ResizeMLP tách biệt: một bộ chuyên chiếu vector nhúng từ vựng, một bộ chuyên chiếu trạng thái ẩn Lớp 24.
- speaker_id (2301, 2302, 2303)
- Mã token đặc biệt trong bảng mã của Talker quy định hồ sơ giọng nói (Chelsie = 2301, Ethan = 2302, Aiden = 2303).
Glossary (2)
- ResizeMLP
- Mạng MLP 2 tầng có kích hoạt SiLU chuyển đổi chiều ẩn từ không gian Thinker (2048) sang không gian Talker (1024).
- Control Tokens (2048..3071)
- Vùng mã đặc biệt trong từ vựng của Talker dùng cho BOS, EOS, PAD và định danh người nói (speaker_id).