Giới thiệu bài lab
Lab Qwen3-Omni và TTS-12Hz: chạy thử toàn trình thu nhỏ từ phổ Mel đến 48 mẫu sóng âm bằng NumPy
Bài lab là một script Python dùng NumPy (thư viện tính toán trên mảng số) chạy ngay trong trình duyệt. Nó dựng lại cả 10 khối 1A đến 6B ở kích thước thu nhỏ: spectrogram Mel 8 kênh × 16 khung, vector 8 chiều ở Thinker và 6 chiều ở Talker, 6 chuyên gia chọn 2, 4 sổ mã RVQ mỗi sổ 8 mục, và 4 khung 80 ms. Kết quả cuối là 48 mẫu sóng âm.
Nhiều bước của kiến trúc, như dịch chỉ số bằng code_offset, cửa sổ trượt hay giải mã theo từng đoạn, khó hình dung chỉ bằng chữ. Với số nhỏ, bạn tự cộng, tự đếm và đối chiếu được, ví dụ bộ mã [4, 1, 6, 4] cộng độ lệch [0, 8, 16, 24] ra chỉ số dòng [4, 9, 22, 28].
Bài lab gồm
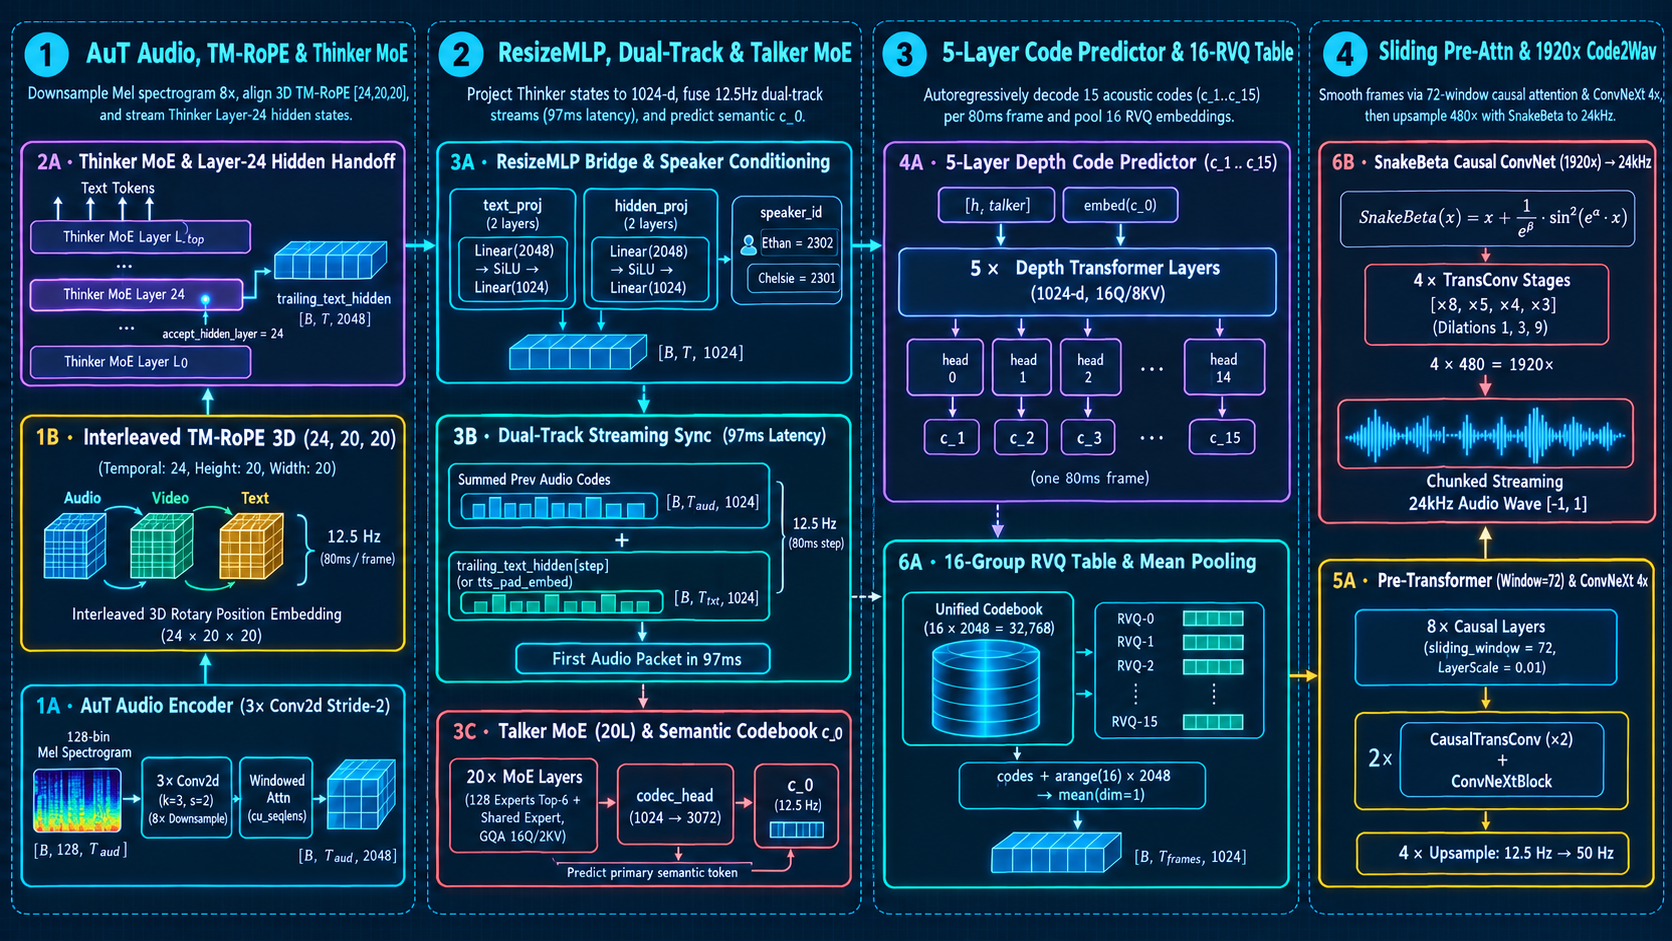
- Sơ đồ 4 cột có khung tương tác ở đầu trang, để biết mỗi bảng số thuộc khối nào.
- Bảng ánh xạ 1:1 cho từng mã 1A đến 6B: lab dựng gì và nhìn số nào để kiểm chứng.
- Trình chạy trực tiếp với mã
qwen3-omni-speech.pysửa được, và các nút Chạy cell, Dừng, Đặt lại. - Output chia thành các khối [1A] đến [6B], rồi mục [KIỂM TRA & THỬ NGHIỆM] với 3 phép kiểm chứng tự động.
- Trang bài đọc Lab đầy đủ (liên kết ở thanh công cụ) có hướng dẫn chi tiết và 4 bài tập kèm đáp án.
Làm xong, bạn có thể
- Giải thích bằng số vì sao Mel (8, 16) còn (1, 2) sau 3 tầng Conv2d bước nhảy 2 (mỗi tầng giảm một nửa).
- Đọc 4 khung Dual-Track: khung 0 và 1 dùng chữ thật từ lớp 24, khung 2 và 3 chuyển sang vector đệm tts_pad_embed vì chữ đã hết.
- Tự tính chỉ số dòng trong bảng RVQ gộp từ mã và code_offset.
- Đọc mặt nạ cửa sổ trượt 4×4 và giải thích vì sao giải mã theo từng đoạn cần ghép thêm một khung ngữ cảnh bên trái.
- Nói được lab chứng minh gì (đường đi của tensor và các phép tính đúng) và không chứng minh gì (48 mẫu sóng âm không phải giọng nói thật).
Phạm vi: lab chỉ chạy suy luận (forward) của một mô hình thu nhỏ và không có bước huấn luyện; trọng số là số ngẫu nhiên cố định bằng seed 30, nên chạy lại cho ra đúng các số cũ nhưng sóng âm đầu ra không phát ra lời nói. Muốn học huấn luyện, hãy xem khóa LLM Training (Text), vốn chỉ dạy mô hình văn bản; huấn luyện mô hình đa phương thức (âm thanh, giọng nói) chưa có bài nào trên site.
Cách dùng bài lab
- Xem sơ đồ 4 cột ở đầu trang: rê chuột hoặc bấm vào khung để mở pop-over, các nút lọc theo cột làm mờ khung của những cột còn lại, và nút Ẩn khung overlay cho bạn đọc ảnh gốc.
- Đọc bảng ánh xạ bên dưới: cột thứ ba cho biết lab dựng gì ở mỗi mã, cột thứ tư cho biết nhìn số nào để kiểm chứng.
- Đọc cấu hình thu nhỏ ở đầu mã, nơi mỗi hằng số có chú thích kích thước thật: spectrogram Mel (8, 16), 2 token chữ do Thinker sinh, người nói
speaker_id = 2302(Ethan), 4 khung ở 12,5 Hz vàseed 30. - Dự đoán trước rồi bấm Chạy cell. Ở [1A] đến [2A], kiểm tra Mel giảm từ (8, 16) xuống (1, 2) và chuẩn vector không đổi sau khi xoay TM-RoPE.
- Ở [3A] đến [4A], theo dõi 4 khung Dual-Track, hai trọng số chuyên gia Top-2 cộng lại bằng 1, và bộ mã [4, 1, 6, 4] của khung 0. Lưu ý output in [6A] trước [5A], vì 5A cần vector trung bình mà 6A tạo ra.
- Ở [6A], [5A], [6B] và [KIỂM TRA & THỬ NGHIỆM], đối chiếu phép dịch chỉ số, mặt nạ cửa sổ trượt 4×4, 48 mẫu sóng âm và 3 phép kiểm chứng. Bạn có thể sửa mã và chạy lại; nếu đổi cấu hình, các assert ở cuối có thể báo lỗi, và nút Đặt lại khôi phục mã gốc.
Đọc kết quả đúng cách: 48 mẫu sóng âm chỉ dùng để kiểm tra đường đi của tensor và độ đúng của phép tính; trọng số ngẫu nhiên không tạo ra giọng nói thật.
Mel [B, 128, T_mel] → 3× Conv2d(k=3, s=2) (8× Downsample) → Windowed Attn (cu_seqlens) → [B, T_aud, 2048]1A · AuT Audio Encoder (3× Conv2d Stride-2)
Điểm xuất phát ở đáy Cột 1: nén spectrogram 128 kênh Mel giảm 8 lần theo cả tần số lẫn thời gian qua 3 tầng Conv2d stride-2 và Windowed Attention.
Bắt đầu đọc sơ đồ từ góc dưới bên trái (1A): Qwen3OmniMoeAudioEncoder chia dải Mel spectrogram 128 kênh thành từng cửa sổ n_window, đưa qua 3 lớp tích chập 2 chiều Conv2d(kernel=3, stride=2) liên tiếp để giảm 2³ = 8 lần độ dài thời gian và số kênh tần số. Chuỗi đặc trưng sau đó cộng SinusoidsPositionEmbedding, chạy Attention cục bộ theo ranh giới cu_seqlens và chiếu qua MLP (1280 → GELU → 2048) để khớp với không gian ẩn của Thinker.
| Mã | Thành phần ở Tab 01 (bấm để mở bài) | Lab NumPy dựng gì (`qwen3-omni-speech.py`) | Cách đọc số liệu & phép kiểm chứng |
|---|---|---|---|
| 1A | AuT Audio Encoder (3× Conv2d Stride-2 & Windowed Attn) ↗ | Nén spectrogram Mel qua 3 tầng tích chập stride-2 (giảm 2³ = 8× thời gian & tần số), cộng SinusoidsPositionEmbedding và chạy Attention theo cu_seqlens. | Kiểm tra kích thước khung Mel giảm đúng 8 lần trước khi chiếu sang chiều ẩn của Thinker (2048). |
| 1B | Interleaved TM-RoPE 3D (24, 20, 20) @ 12.5 Hz ↗ | Đan xen các cặp tần số theo tỷ lệ [24, 20, 20] (Temporal, Height, Width) đồng bộ theo nhịp 12.5 Hz (80 ms/khung). | Xác nhận bảo toàn chuẩn Euclid ‖RoPE(q)‖ = ‖q‖ và tính bất biến góc tương đối giữa khung âm thanh và khung hình. |
| 2A | Thinker MoE & Trích ngang trạng thái ẩn Lớp 24 ↗ | Chạy chuỗi lớp Thinker MoE để phát văn bản ở tầng đỉnh, đồng thời trích ngang accept_hidden_layer = 24 làm luồng trailing_text_hidden. | Đối chiếu vector tại Lớp 24 giàu thông tin ngữ điệu hơn so với trạng thái đã ép sát từ vựng ở lớp cuối. |
| 3A | Cầu nối ResizeMLP kép & Điều kiện hóa Speaker ID ↗ | Chiếu text_projection và hidden_projection qua Linear(2048→2048) → SiLU → Linear(2048→1024) kèm nhúng speaker_id (Ethan=2302, Chelsie=2301). | Kiểm tra phép hạ chiều 2048 → 1024 và sự thay đổi phân phối mã âm thanh khi đổi speaker_id. |
| 3B | Đồng bộ Dual-Track Streaming 12.5 Hz (97 ms Latency) ↗ | Tại mỗi bước generation_step (80 ms), cộng vector tổng 16 sổ mã bước trước với trailing_text_hidden[step] (hoặc tts_pad_embed khi hết chữ). | Xác nhận Talker phát khung âm thanh đầu tiên ngay sau token chữ thứ nhất mà không cần chờ Thinker sinh hết câu. |
| 3C | Talker MoE (20 Lớp, 128 Experts Top-6) & Mã ngữ nghĩa c_0 ↗ | Chạy GQA (16Q/2KV) + MoE Top-6/128 chuyên gia + 1 chuyên gia chung, xuất h_talker và chiếu codec_head dự đoán mã ngữ nghĩa c_0. | Kiểm tra tổng trọng số Top-6 sau chuẩn hóa bằng 1.0 và mã ngữ nghĩa c_0 được chọn cho từng khung 80 ms. |
| 4A | 5-Layer Depth Code Predictor (Tự hồi quy c_1 .. c_15) ↗ | Đưa cặp prefill [h_talker, embed(c_0)] vào 5 lớp Depth Transformer và chạy 15 bước tự hồi quy qua 15 đầu lm_head[0..14] riêng biệt. | Kiểm chứng toàn bộ 15 mã âm học c_1..c_15 được sinh ngay trong cùng một khung 80 ms mà không phải gọi lại Talker 20 lớp. |
| 5A | Code2Wav Pre-Transformer (Window=72) & ConvNeXt 4× ↗ | Áp dụng mặt nạ nhân quả cửa sổ trượt 72 khung + LayerScale (0.01) và 2 tầng CausalTransConv(×2) + ConvNeXt nâng tần số 4× (12.5 Hz → 50 Hz). | Kiểm chứng mặt nạ cửa sổ trượt chặn tuyệt đối các khung tương lai (cô lập nhân quả 0.00e+00) và nhân đúng 4× số bước thời gian. |
| 6A | Bảng nhúng 16-Group RVQ (Offset 2048) & Mean Pooling ↗ | Cộng chỉ số 16 sổ mã với code_offset = arange(16) × K để tra cứu một lần trên bảng gộp rồi lấy trung bình .mean(dim=1). | Chứng minh tra bảng gộp với code_offset cho kết quả khớp 0.00e+00 so với 16 vòng lặp tra cứu rời rạc. |
| 6B | SnakeBeta Causal ConvNet 480× (Tổng 1920×) → Sóng âm 24 kHz ↗ | Kích hoạt tuần hoàn SnakeBeta(x) = x + (1/e^β)·sin²(e^α·x), phóng đại 4 tầng [×8, ×5, ×4, ×3] = 480× (tổng 4×480 = 1920 mẫu/khung) và cắt left_context khi giải mã theo chunk. | Xác nhận 1 khung 80 ms (12.5 Hz) nở ra đúng 1920 mẫu sóng âm 24 kHz nằm trong [-1, 1]. |
Nguồn công bố & mã nguồn tham chiếu
Danh sách bài học (11)
- 1A · AuT Audio Encoder (3× Conv2d Stride-2 & Windowed Attention)
- Lab tổng hợp Qwen3-Omni & Qwen3-TTS-12Hz — chạy toàn trình 1A → 6B bằng NumPy
- 1B · Interleaved TM-RoPE 3D (24, 20, 20) & Đồng bộ trục thời gian 12.5 Hz
- 2A · Thinker MoE Backbone & Chuyển giao trạng thái ẩn tại Lớp 24
- 3A · Cầu nối ResizeMLP kép (2048 → 1024) & Điều kiện hóa giọng đọc Speaker ID
- 3B · Đồng bộ Dual-Track Streaming 12.5 Hz (Độ trễ gói đầu 97 ms)
- 3C · Talker MoE (20 lớp, 128 Experts Top-6) & Đầu ra mã ngữ nghĩa c_0
- 4A · 5-Layer Depth Code Predictor (Tự hồi quy 15 mã âm học c_1 .. c_15 trong 80 ms)
- 5A · Code2Wav Pre-Transformer (Cửa sổ trượt 72) & Phóng đại ConvNeXt 4×
- 6A · Bảng nhúng 16-Group RVQ (Offset 2048) & Gộp trung bình Mean Pooling
- 6B · Chuỗi Causal ConvNet 4 tầng (480×), Hàm tuần hoàn SnakeBeta & Giải mã 24 kHz