3B · Dual-Track Streaming Sync
3B · Đồng bộ Dual-Track Streaming 12.5 Hz (Độ trễ gói đầu 97 ms)
Tại mỗi nhịp 80 ms (12.5 Hz), Talker cộng trực tiếp vector tổng 16 sổ mã âm thanh của bước trước với trạng thái ẩn chữ tương ứng để phát giọng nói tức thì.
1Định nghĩa
Ở giữa Cột 2 là trái tim giúp Qwen3-Omni và Qwen3-TTS-12Hz đạt độ trễ gói âm thanh đầu tiên chỉ 97 ms: cơ chế đồng bộ hai đường ray (Dual-Track Streaming). Trong các hệ thống TTS truyền thống, mô hình phải nhận trọn vẹn cả câu văn bản rồi mới bắt đầu sinh âm thanh; ngược lại, ở kiến trúc Dual-Track, ngay khi cầu nối ResizeMLP ở 3A vừa đẩy xuống đúng 1 token chữ đầu tiên, vòng lặp âm thanh 12.5 Hz đã lập tức khởi chạy.
Cụ thể, ở mỗi bước thời gian generation_step (tương ứng một khung âm thanh 80 ms), đầu vào đưa vào 20 lớp Talker MoE ở 3C là tổng của hai thành phần cùng có chiều 1024: (1) vector âm thanh tổng hợp từ 16 sổ mã RVQ của bước ngay trước đó (residual_codes) và (2) vector chữ thứ generation_step lấy từ hàng đợi trailing_text_hidden. Khi số bước âm thanh vượt quá độ dài hàng đợi chữ (vì một từ thường kéo dài qua nhiều khung 80 ms), thành phần thứ hai tự động chuyển sang cộng vector đệm tts_pad_embed.
Ví dụ đời thường: Hãy hình dung một thông dịch viên cabin dịch đuổi trực tiếp: ngay khi diễn giả vừa mở lời nói chữ đầu tiên, thông dịch viên đã bắt đầu phát âm luôn chữ đó trong khi tai vẫn tiếp tục nhận chữ thứ hai, thứ ba; và khi diễn giả đã dứt câu nhưng câu dịch vẫn còn vài âm tiết ngân cuối, thông dịch viên giữ nhịp thở đều (tts_pad_embed) để đọc nốt cho trọn câu. Phép so sánh này dừng lại ở chỗ sự kết hợp hai luồng trong Talker là phép cộng từng phần tử trên hai vector 1024 chiều.
2Luồng
Cách đọc hình (Cột 2, khối 3B ở giữa): nhận luồng chữ 1024 chiều từ 3A cộng với luồng phản hồi âm thanh từ 6A (Summed Prev Audio Codes) theo nhịp 12.5 Hz (80 ms/bước) rồi truyền xuống Talker MoE ở 3C; xem bước [3B] trong [Bài Lab tổng hợp Qwen3-Omni](/courses/qwen3-omni-speech/qwen3-omni-lab/qwen3-omni-end-to-end-lab/) ở Tab 02.
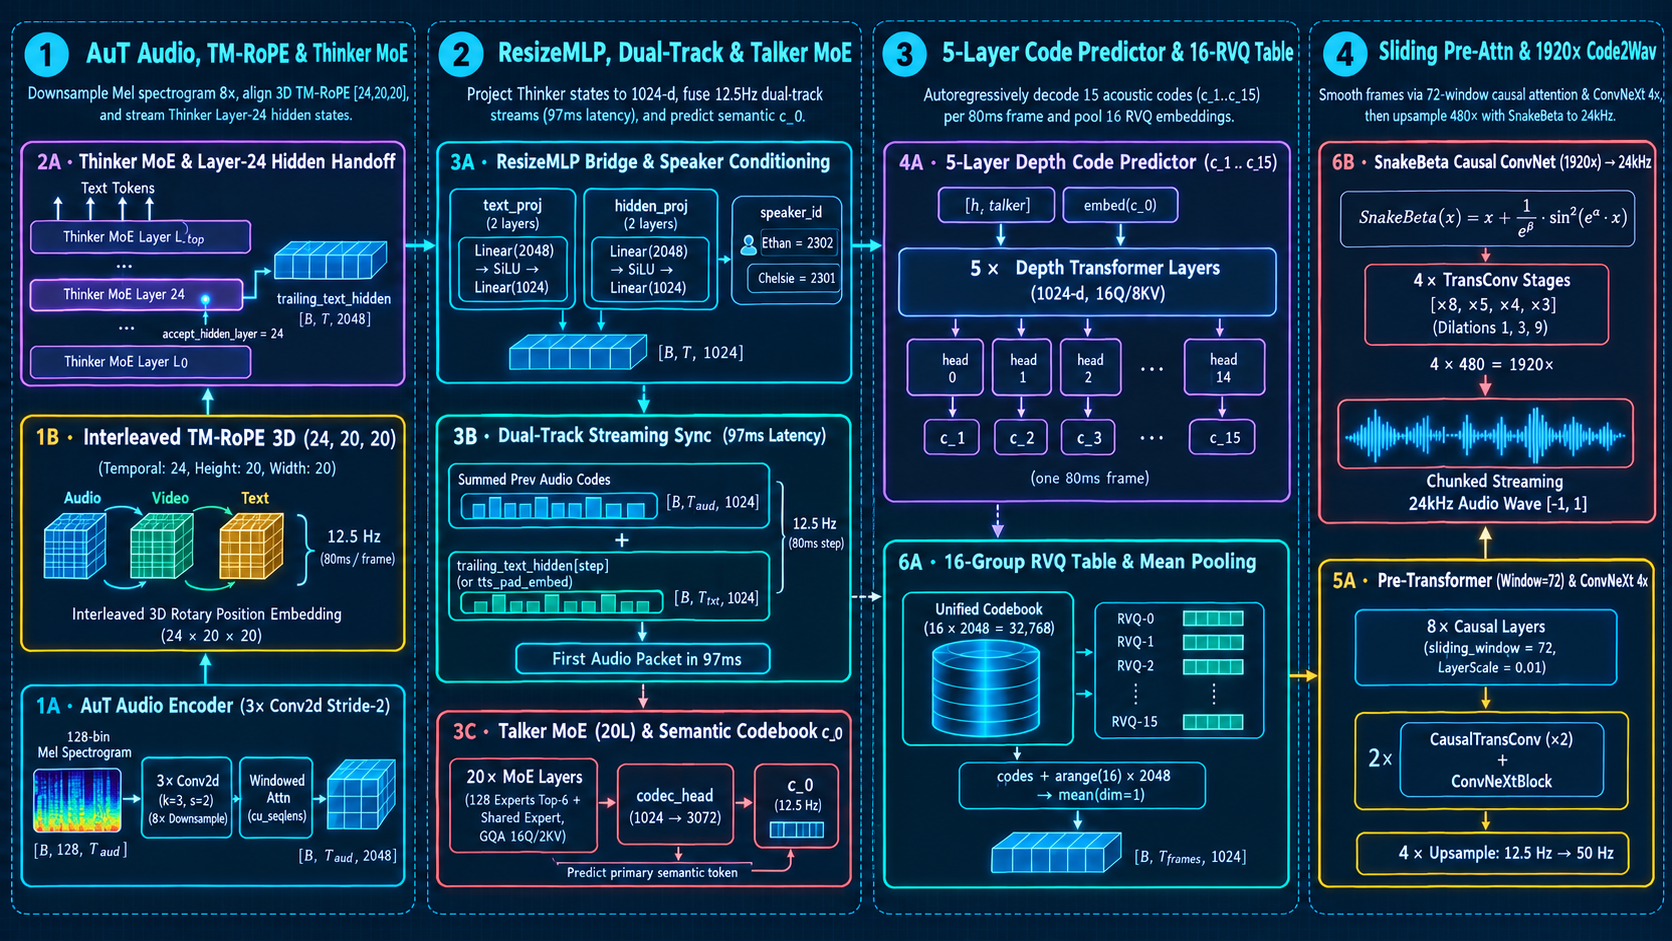
in_t = embed_sum(residual_codes_{t-1}) + trailing_text_hidden[step] (or tts_pad_embed) @ 12.5 Hz → 97ms First Packet3B · Dual-Track Streaming Sync (97ms Latency)
Giữa Cột 2: cộng chập vector âm thanh bước trước với trạng thái ẩn chữ tương ứng ở mỗi nhịp 80 ms (12.5 Hz), phát gói âm thanh đầu tiên chỉ sau 97 ms.
Ở giữa Cột 2 là cơ chế Dual-Track Streaming: tại mỗi bước sinh âm thanh generation_step (tương ứng 1 khung 80 ms ở tần số 12.5 Hz), vector đầu vào của Talker được tổng hợp trực tiếp bằng phép cộng hai làn: (1) tổng nhúng của 16 mã âm thanh vừa sinh ở khung trước (residual_codes) và (2) vector chữ thứ generation_step trong hàng đợi trailing_text_hidden (khi hết chữ sẽ tự động chuyển sang cộng vector đệm tts_pad_embed cho tới lúc phát mã kết thúc codec_eos_token_id = 2150).
- 1. Nhận tổng nhúng 16 mã RVQ từ khung trước (t - 1)
Lấy tổng/trung bình nhúng của c_0..c_15 vừa sinh ở khung trước làm vector âm thanh lịch sử.
- 2. Chọn vector chữ tại chỉ số generation_step
Nếu generation_step < len(trailing_text_hidden) thì lấy trailing_text_hidden[step]; ngược lại lấy tts_pad_embed.
- 3. Cộng chập hai làn (Dual-Track Fusion)
Tính inputs_embeds = audio_embed_{t-1} + text_cond_t trong không gian 1024 chiều.
- 4. Đưa vào Talker MoE kèm KV Cache thời gian
Chạy bước tự hồi quy tiếp theo ở nhịp 12.5 Hz và tăng generation_step thêm 1.
Mã Mermaid
flowchart TD
  step1["1. Nhận tổng nhúng 16 mã RVQ từ khung trước (t - 1)"]
  step2["2. Chọn vector chữ tại chỉ số generation_step"]
  step3["3. Cộng chập hai làn (Dual-Track Fusion)"]
  step4["4. Đưa vào Talker MoE kèm KV Cache thời gian"]
  step1 --> step2
  step2 --> step3
step3 --> step43Giải pháp
Công thức hợp nhất hai luồng tại bước thời gian âm thanh t (generation_step = t) của Talker là: $$e_t = \text{Embed}_{\text{audio}}(c_{t-1}^{(0..15)}) + \begin{cases} h_{\text{text}}[t] & \text{nếu } t < T_{\text{text}} \\ e_{\text{tts\_pad}} & \text{nếu } t \ge T_{\text{text}} \end{cases}$$ Nhờ phép cộng trực tiếp thay vì nối dài chuỗi (concatenation), mỗi khung thời gian 80 ms chỉ làm tăng độ dài KV Cache của Talker thêm đúng 1 vị trí duy nhất, giữ chi phí bộ nhớ và thời gian tính toán mỗi bước cực thấp.
Tại sao thiết kế này lại đạt độ trễ 97 ms và hỗ trợ cả chế độ phát trực tuyến (streaming) lẫn không trực tuyến (non-streaming) trong cùng một mô hình? Vì tại bước t, công thức trên chỉ phụ thuộc vào các token văn bản từ 0 đến t (không cần biết các từ ở cuối câu). Khi chạy streaming, cứ mỗi token chữ mới từ Thinker chảy xuống sẽ điền vào vị trí t tiếp theo; khi chạy offline, toàn bộ mảng trailing_text_hidden đã có sẵn nhưng vẫn được đọc tuần tự theo đúng chỉ số t.
Bạn có thể quan sát trực tiếp bảng đồng bộ từng khung t = 0, 1, 2, 3 (nơi khung 0 và 1 cộng chữ thật, còn khung 2 và 3 chuyển sang cộng tts_pad_embed) tại mục [3B] trong Bài Lab tổng hợp Qwen3-Omni.
4Profiling
- Tốc độ tăng trưởng KV Cache của Talker
Đếm số vị trí tăng thêm trong past_key_values của Talker sau mỗi khung 80 ms: chỉ tăng đúng 1 token/khung (12,5 token/giây) nhờ cộng chập chữ và âm thanh thay vì ghép nối đuôi.
- Độ trễ gói âm thanh đầu tiên (First-Packet TTFA)
Không phụ thuộc vào tổng độ dài câu trả lời: gói âm thanh đầu tiên luôn sẵn sàng ngay sau khi token chữ đầu tiên đi qua Lớp 24 và 1 bước khung 80 ms.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Theo dõi 4 khung âm thanh khi chỉ có 2 token chữ
Trong bài lab với 2 token chữ (T_text = 2) và 4 khung âm thanh (T_frames = 4): ở frame 0 và frame 1, Talker cộng trailing_text_hidden[0] và [1]; sang frame 2 và frame 3 (khi chữ đã hết), Talker tự động cộng vector tts_pad_embed để hoàn tất phần ngân giọng.
6Thuật ngữ
- Dual-Track Hybrid Streaming
- Cơ chế ghép 2 luồng đồng bộ ở mỗi bước: luồng văn bản từ Thinker (trailing_text_hidden) cộng với luồng phản hồi mã âm thanh bước trước (residual_codes).
- tts_pad_embed (tts_pad_token_id)
- Vector nhúng đệm được cộng thay thế vào luồng chữ khi tất cả các token văn bản đã được tiêu thụ hết nhưng câu nói vẫn đang phát nốt.
- 97 ms First-Packet Latency
- Thời gian từ lúc nhận ký tự đầu tiên cho tới khi xuất xong gói sóng âm đầu tiên (80 ms khung mã hóa + ~17 ms mạng nơ-ron).
Glossary (2)
- 12.5 Hz Frame Rate (80 ms/frame)
- Tốc độ khung của bộ mã hóa âm thanh: mỗi giây âm thanh được chia thành 12,5 khung, mỗi khung dài 80 mili-giây.
- Dual-Track Addition
- Cộng trực tiếp vector điều kiện văn bản và vector lịch sử âm thanh vào cùng một vị trí token.