1A · AuT Audio Encoder
1A · AuT Audio Encoder (3× Conv2d Stride-2 & Windowed Attention)
Bộ mã hóa âm thanh AuT nén spectrogram Mel 128 kênh giảm 8 lần theo cả tần số và thời gian qua 3 tầng Conv2d stride-2 rồi chạy Attention theo cửa sổ.
1Định nghĩa
Khi người dùng nói vào Qwen3-Omni, sóng âm thô được chuyển thành dải Mel spectrogram 128 kênh có tốc độ khung rất dày (100 khung mỗi giây). Nếu đẩy trực tiếp toàn bộ số khung này vào mô hình ngôn ngữ thì chuỗi sẽ dài gấp nhiều lần văn bản, vì vậy khối AuT Audio Encoder mở đầu ở góc dưới Cột 1 dùng 3 tầng tích chập hai chiều Conv2d(kernel=3, stride=2) liên tiếp để nén giảm 8 lần cả chiều thời gian lẫn chiều tần số trước khi bước vào Interleaved TM-RoPE 3D.
Sau 3 tầng tích chập hạ mẫu, mỗi khung đặc trưng đại diện cho một khoảng thời gian gọn hơn được cộng thêm vector vị trí hình sin SinusoidsPositionEmbedding và đi qua chuỗi lớp Attention hai chiều có giới hạn cửa sổ theo ranh giới cu_seqlens. Cuối cùng, mạng chiếu hai tầng Linear(1280 → 1280) kèm GELU và Linear(1280 → 2048) đưa đặc trưng âm thanh về đúng chiều ẩn 2048 của khối suy luận Thinker MoE.
Ví dụ đời thường: Hãy hình dung một thư ký tốc ký nghe đoạn ghi âm dài: thay vì chép từng mili-giây tiếng động rời rạc, người thư ký gom mỗi cụm 8 nhịp âm thanh liên tiếp thành một âm tiết hoàn chỉnh, lắng nghe trong phạm vi từng câu ngắn để phân biệt từ đồng âm rồi mới chuyển bản tóm tắt chuẩn hóa cho người chủ trì cuộc họp. Phép so sánh này dừng lại ở chỗ AuT thực hiện phép tích chập 2D cố định trên lưới thời gian - tần số chứ không tra từ điển chính tả.
2Luồng
Cách đọc hình (Cột 1, khối 1A dưới đáy): bắt đầu từ 1A ở góc dưới Cột 1 để nén spectrogram Mel 128 kênh giảm 8× qua 3 tầng Conv2d stride-2 và Windowed Attention, rồi đẩy luồng đặc trưng [B, T_aud, 2048] đi lên 1B → 2A; mở bước [1A] trong [Bài Lab tổng hợp Qwen3-Omni](/courses/qwen3-omni-speech/qwen3-omni-lab/qwen3-omni-end-to-end-lab/) ở Tab 02 để tự tay kiểm tra.
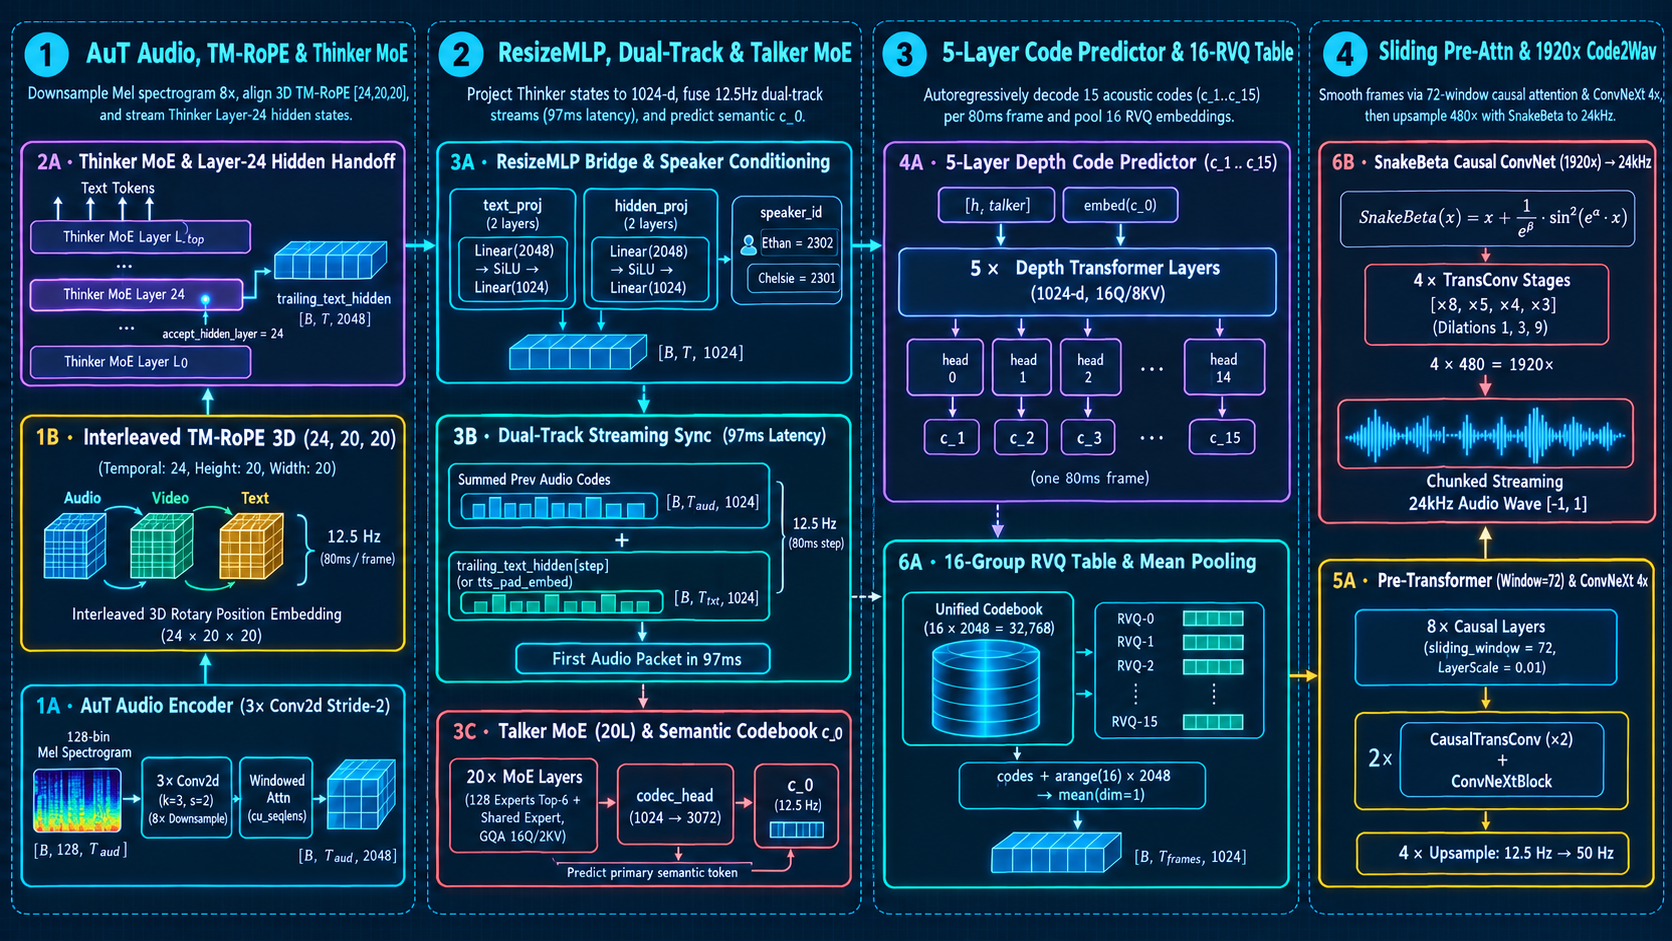
Mel [B, 128, T_mel] → 3× Conv2d(k=3, s=2) (8× Downsample) → Windowed Attn (cu_seqlens) → [B, T_aud, 2048]1A · AuT Audio Encoder (3× Conv2d Stride-2)
Điểm xuất phát ở đáy Cột 1: nén spectrogram 128 kênh Mel giảm 8 lần theo cả tần số lẫn thời gian qua 3 tầng Conv2d stride-2 và Windowed Attention.
Bắt đầu đọc sơ đồ từ góc dưới bên trái (1A): Qwen3OmniMoeAudioEncoder chia dải Mel spectrogram 128 kênh thành từng cửa sổ n_window, đưa qua 3 lớp tích chập 2 chiều Conv2d(kernel=3, stride=2) liên tiếp để giảm 2³ = 8 lần độ dài thời gian và số kênh tần số. Chuỗi đặc trưng sau đó cộng SinusoidsPositionEmbedding, chạy Attention cục bộ theo ranh giới cu_seqlens và chiếu qua MLP (1280 → GELU → 2048) để khớp với không gian ẩn của Thinker.
- 1. Chia cửa sổ Mel Spectrogram
Cắt dải Mel 128 kênh theo cửa sổ n_window và đệm chiều kênh thành (num_chunks, 1, 128, T).
- 2. Hạ mẫu 8× bằng 3× Conv2d Stride-2
Đi qua conv2d1, conv2d2, conv2d3 (stride=2) và trải phẳng trục kênh × tần số qua conv_out về d_model = 1280.
- 3. Windowed Self-Attention theo cu_seqlens
Cộng SinusoidsPositionEmbedding và chạy các lớp Qwen3OmniMoeAudioEncoderLayer trong từng cửa sổ độc lập.
- 4. Chiếu đầu ra sang không gian Thinker (2048)
Chuẩn hóa LayerNorm rồi đi qua proj1 → GELU → proj2 (1280 → 2048) để ghép vào chuỗi đa phương thức.
Mã Mermaid
flowchart TD
  step1["1. Chia cửa sổ Mel Spectrogram"]
  step2["2. Hạ mẫu 8× bằng 3× Conv2d Stride-2"]
  step3["3. Windowed Self-Attention theo cu_seqlens"]
  step4["4. Chiếu đầu ra sang không gian Thinker (2048)"]
  step1 --> step2
  step2 --> step3
step3 --> step43Giải pháp
Trong mã nguồn Qwen3OmniMoeAudioEncoder, một ảnh phổ Mel có F = 128 kênh tần số khi đi qua một tầng Conv2d(kernel=3, stride=2, padding=1) sẽ biến đổi kích thước theo công thức chuẩn: $$L_{\text{out}} = \left\lfloor \frac{L_{\text{in}} + 1}{2} \right\rfloor$$ Sau 3 tầng liên tiếp, số kênh tần số còn lại là (((128 + 1)//2 + 1)//2 + 1)//2 = 16, và số khung thời gian cũng giảm đi xấp xỉ 8 lần.
Tại sao phải dùng 3 tầng Conv2d có stride = 2 thay vì một tầng duy nhất có stride = 8? Ba tầng tích chập 3×3 nối tiếp kèm hàm kích hoạt phi tuyến giúp mở rộng vùng cảm thụ (receptive field) một cách mượt mà và trích xuất được các mẫu biên tần số (formants, âm bật) trước khi gộp thời gian, tránh hiện tượng răng cưa (aliasing) làm mất âm đầu.
Sau khi trải phẳng C_conv × 16 kênh tần số và chiếu tuyến tính conv_out về d_model = 1280, mô hình áp dụng Attention không nhân quả (is_causal = False) nhưng bị giới hạn chặt trong từng đoạn cu_seqlens. Thiết kế này cho phép AuT vừa nhìn hai chiều để hiểu rõ âm vị trong một cụm ngắn, vừa có thể xử lý âm thanh dài hàng giờ theo từng khối cố định mà không tràn bộ nhớ. Để thấy rõ ma trận Mel giảm 8× như thế nào, hãy chạy mục [1A] trong Bài Lab tổng hợp Qwen3-Omni.
4Profiling
- Tỷ lệ nén chiều dài chuỗi âm thanh (8× Downsampling)
Đo số khung thời gian trước conv2d1 (T_mel) và sau conv2d3 (T_aud ≈ T_mel / 8): giảm 8 lần số token đưa vào Thinker giúp giảm 64 lần chi phí bậc hai của Self-Attention trên chuỗi âm thanh.
- Độ cô lập giữa các cửa sổ cu_seqlens
Thay đổi giá trị spectrogram ở cửa sổ thứ hai và kiểm tra đầu ra của cửa sổ thứ nhất: sai lệch phải bằng 0.00e+00 nhờ tách đoạn theo cu_seqlens.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Tính kích thước đầu ra sau 3 tầng Conv2d stride-2
Với dải Mel đầu vào có F = 8 kênh tần số và T = 16 khung thời gian trong bài lab thu nhỏ: sau tầng Conv2d stride-2 thứ nhất còn (4, 8); sau tầng thứ hai còn (2, 4); và sau tầng thứ ba còn đúng (1, 2) — giảm chính xác 8 lần trên cả hai chiều.
6Thuật ngữ
- 3× Conv2d(k=3, s=2, p=1)
- Ba tầng tích chập 2 chiều bước nhảy 2 giúp giảm kích thước trục thời gian và trục tần số Mel đi 2³ = 8 lần.
- cu_seqlens (Cumulative Sequence Lengths)
- Mảng chỉ số tích lũy đánh dấu ranh giới từng đoạn cửa sổ âm thanh để FlashAttention không trộn lẫn các đoạn khác nhau.
- SinusoidsPositionEmbedding
- Bảng vị trí hình sin cố định cộng vào đặc trưng âm thanh sau khi hạ mẫu Conv2d.
Glossary (2)
- Mel Spectrogram (128 bins)
- Biểu diễn năng lượng âm thanh theo thang tần số cảm nhận của tai người gồm 128 dải tần.
- Downsampling 8×
- Giảm số bước thời gian đi 8 lần qua 3 tầng tích chập có bước nhảy stride = 2.