6A · 16-Group RVQ Offset Table
6A · Bảng nhúng 16-Group RVQ (Offset 2048) & Gộp trung bình Mean Pooling
Xếp toàn bộ 16 sổ mã (mỗi sổ 2048 mục) vào một bảng nhúng 32.768 dòng duy nhất, tra cứu song song bằng vector độ lệch code_offset và lấy trung bình cộng.
1Định nghĩa
Ở nửa dưới Cột 3, ngay bên dưới 5-Layer Depth Code Predictor (4A), ta có đầy đủ 16 mã số nguyên (c_0, c_1, ..., c_15) cho mỗi khung âm thanh 80 ms, trong đó mỗi mã nằm trong khoảng từ 0 đến 2047 (codebook_size = 2048, num_quantizers = 16). Nhiệm vụ của khối 6A là biến lưới chỉ số rời rạc [B, 16, T_frames] này thành chuỗi vector liên tục [B, T_frames, 1024] để vừa cấp cho Pre-Transformer ở Cột 4 (5A) vừa phản hồi về bộ đồng bộ Dual-Track ở 3B.
Nếu viết một vòng lặp Python duyệt qua 16 bảng nhúng rời rạc thì GPU sẽ phải phát 16 lệnh kernel nhỏ lẻ. Thay vào đó, Qwen3OmniMoeCode2Wav gộp cả 16 sổ mã vào một bảng nhúng khổng lồ duy nhất code_embedding có 16 × 2048 = 32.768 dòng (mỗi dòng 1024 chiều) và cộng thêm một hằng số dịch khung code_offset = [0, 2048, 4096, ..., 30720] trước khi tra bảng rồi lấy trung bình cộng dọc theo trục 16 tầng (.mean(1)).
Ví dụ đời thường: Hãy hình dung một bộ từ điển bách khoa 16 tập, mỗi tập dày đúng 2048 trang: thay vì để 16 cuốn sách rời trên kệ rồi mở từng cuốn, người thủ thư đóng gộp cả 16 tập thành một cuốn sách lớn 32.768 trang liên tiếp; muốn tra trang c_k của tập thứ k, bạn chỉ việc mở ngay trang số (k × 2048 + c_k) trong một lần lật duy nhất. Phép so sánh này dừng lại ở chỗ sau khi tra đủ 16 trang cho một khung 80 ms, mô hình cộng trung bình cả 16 vector lại thành một vector đại diện duy nhất.
2Luồng
Cách đọc hình (Cột 3, khối 6A nửa dưới): nhận 15 mã âm học từ 4A ngay phía trên cùng mã c_0 từ 3C, cộng vector độ lệch arange(16) × 2048 để tra cứu trên trụ Unified Codebook (32.768 dòng) và lấy trung bình .mean(dim=1) trước khi chuyển sang 5A ở Cột 4; xem bước [6A] trong [Bài Lab tổng hợp Qwen3-Omni](/courses/qwen3-omni-speech/qwen3-omni-lab/qwen3-omni-end-to-end-lab/) ở Tab 02.
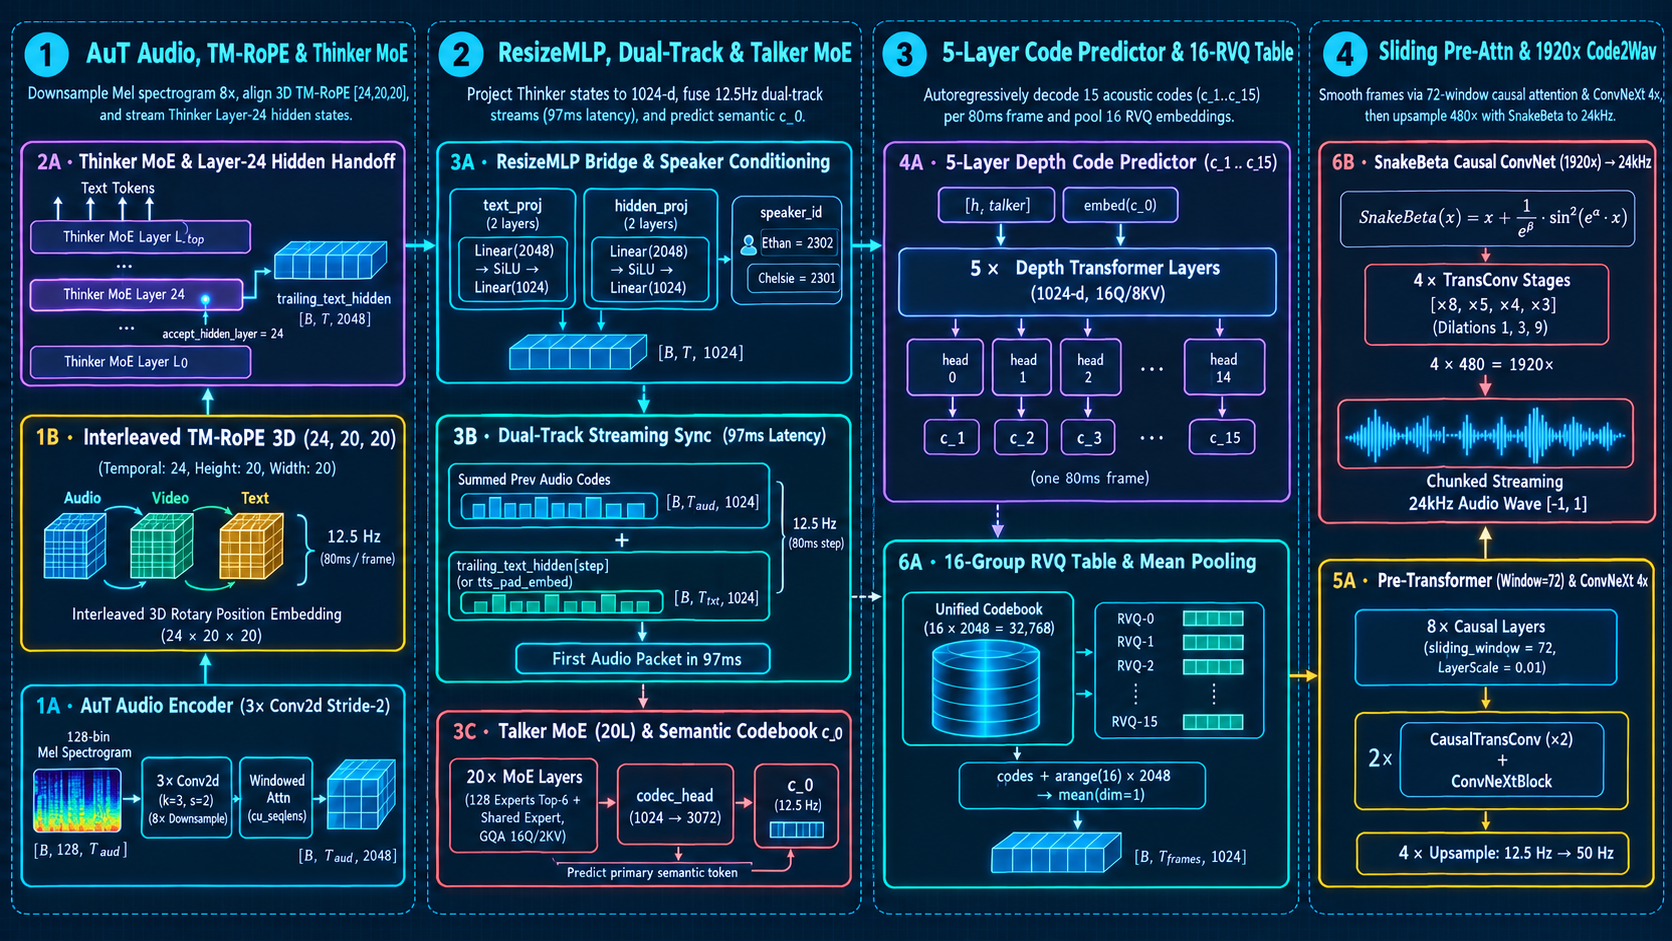
Unified Table [16 × 2048 = 32,768, 1024] · idx = codes + arange(16) × 2048 → code_embedding(idx).mean(dim=1) ∈ [B, T, 1024]6A · 16-Group RVQ Table & Mean Pooling
Nửa dưới Cột 3: tra cứu đồng thời cả 16 sổ mã (c_0 .. c_15) trên một bảng nhúng gộp 32.768 dòng bằng độ lệch code_offset và lấy trung bình cộng.
Nằm ngay dưới 4A ở Cột 3 là bảng mã hợp nhất của bộ giải mã: thay vì thực hiện 16 vòng lặp tra cứu rời rạc cho 16 tầng RVQ, mô hình xếp toàn bộ 16 sổ mã (mỗi sổ 2048 mục, chiều 1024) vào một bảng code_embedding duy nhất có 16 × 2048 = 32.768 dòng. Bằng cách cộng chỉ số mã với vector độ lệch code_offset = [0, 2048, 4096, ..., 30720], toàn bộ 16 tầng được tra cứu trong một phép tính song song rồi lấy trung bình cộng .mean(dim=1) để tái tạo vector khung âm thanh liên tục [B, T_frames, 1024].
- 1. Tập hợp ma trận mã [B, 16, T_frames]
Ghép mã ngữ nghĩa c_0 (từ Talker 3C) và 15 mã âm học c_1..c_15 (từ Code Predictor 4A).
- 2. Cộng độ lệch phân vùng code_offset
Tính shifted_codes = codes + arange(16).view(1, 16, 1) * 2048 để dịch chỉ số tầng k vào đoạn [2048k, 2048(k+1)).
- 3. Tra bảng code_embedding một lần duy nhất
Lấy toàn bộ tensor nhúng [B, 16, T_frames, 1024] chỉ bằng 1 phép indexing song song.
- 4. Gộp trung bình .mean(dim=1) → [B, T_frames, 1024]
Cộng trung bình 16 tầng để chuyển sang Pre-Transformer ở 5A (Cột 4) và phản hồi lịch sử âm thanh về 3B.
Mã Mermaid
flowchart TD
  step1["1. Tập hợp ma trận mã #91;B, 16, T_frames#93;"]
  step2["2. Cộng độ lệch phân vùng code_offset"]
  step3["3. Tra bảng code_embedding một lần duy nhất"]
  step4["4. Gộp trung bình .mean(dim=1) → #91;B, T_frames, 1024#93;"]
  step1 --> step2
  step2 --> step3
step3 --> step43Giải pháp
Trong lớp Qwen3OmniMoeCode2Wav (modeling_qwen3_omni_moe.py), toàn bộ bước khôi phục đặc trưng từ 16 sổ mã được viết gọn trong đúng 2 dòng lệnh: $$\text{offset} = \begin{bmatrix} 0 & 1 & \dots & 15 \end{bmatrix}^T \times 2048, \quad h_{\text{frame}} = \frac{1}{16} \sum_{q=0}^{15} E\big[\text{codes}[b, q, t] + \text{offset}[q]\big]$$ trong đó $E \in \mathbb{R}^{32768 \times 1024}$ là ma trận trọng số của self.code_embedding.
Tại sao ở đây lấy trung bình cộng (mean(1), tức chia cho 16) thay vì chỉ lấy tổng đơn thuần? Khi 16 vector độc lập có phương sai cỡ $\sigma^2$ được cộng trực tiếp lại với nhau, phương sai của tổng sẽ vọt lên gấp 16 lần ($16\sigma^2$, biên độ tăng gấp 4 lần), dễ đẩy các lớp Pre-Transformer phía sau vào vùng bão hòa. Chia trung bình cho 16 giữ cho biên độ đầu vào của Code2Wav luôn ổn định.
Trong mục [6A] và phần [KIỂM TRA & THỬ NGHIỆM] của Bài Lab tổng hợp Qwen3-Omni, bạn sẽ kiểm chứng trực tiếp rằng phép tra bảng gộp với code_offset cho ra vector trung bình khớp tuyệt đối (sai lệch 0.00e+00) so với việc tra cứu 16 bảng rời rạc rồi cộng trung bình.
4Profiling
- Tương đương số học giữa Bảng gộp (Offset Table) và 16 Bảng rời
So sánh kết quả của code_embedding(codes + code_offset).mean(1) với trung bình của 16 lần tra bảng con E_q[codes[:, q]]: độ lệch tuyệt đối tối đa phải bằng đúng 0.00e+00.
- Gộp lệnh gọi GPU Kernel (1 Kernel thay vì 16 Kernels)
Giảm số lần đọc bảng nhúng từ 16 xuống 1 lần duy nhất cho mỗi chunk giải mã sóng âm.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Tính chỉ số dòng thực tế trong bảng gộp 32.768 dòng
Giả sử tại khung t = 0, mã ngữ nghĩa ở tầng q = 0 là c_0 = 15 và mã âm học ở tầng q = 3 là c_3 = 42. Nhờ cộng code_offset = q × 2048, tầng 0 tra dòng 0 × 2048 + 15 = 15, còn tầng 3 tra dòng 3 × 2048 + 42 = 6186 — hai tầng không bao giờ đụng độ nhau.
6Thuật ngữ
- code_embedding (32,768 × 1024)
- Bảng nhúng hợp nhất chứa toàn bộ 16 sổ mã RVQ (num_quantizers = 16 × codebook_size = 2048).
- code_offset = arange(16) × 2048
- Vector độ lệch [0, 2048, 4096, ..., 30720] cộng vào chỉ số mã của từng tầng để ánh xạ vào đúng phân vùng trong bảng gộp.
- .mean(1) (Quantizer Mean Pooling)
- Phép lấy trung bình cộng trên trục 16 tầng lượng tử hóa để giữ ổn định phương sai của vector khung âm thanh.
Glossary (2)
- RVQ (Residual Vector Quantization)
- Lượng tử hóa vector đa tầng: mỗi tầng sau mã hóa phần dư còn lại của tầng trước để tăng độ trung thực của âm thanh.
- Offset Indexing Trick
- Kỹ thuật cộng bội số kích thước bảng (q × K) vào chỉ số tra cứu để gộp nhiều bảng nhúng vào một ma trận duy nhất.