3C · Talker MoE & Semantic c_0
3C · Talker MoE (20 lớp, 128 Experts Top-6) & Đầu ra mã ngữ nghĩa c_0
Mạng Talker MoE gồm 20 lớp (128 chuyên gia chọn Top-6 + 1 chuyên gia chung) biến đổi luồng Dual-Track để xuất trạng thái ẩn h_talker và dự đoán mã ngữ nghĩa c_0.
1Định nghĩa
Ở đáy Cột 2, vector hợp nhất từ bộ đồng bộ Dual-Track (3B) đi vào thân chính của bộ phát giọng nói: Qwen3OmniMoeTalkerForConditionalGeneration. Đây là một mạng Transformer giải mã gồm 20 lớp MoE (num_hidden_layers = 20, hidden_size = 1024), sử dụng cơ chế Grouped-Query Attention (16 Q head chia sẻ 2 KV head, mỗi head 128 chiều) kết hợp tầng chuyên gia thưa ở mỗi lớp.
Trong mỗi lớp Talker MoE, bộ định tuyến Qwen3OmniMoeTalkerTextTopKRouter chấm điểm 128 chuyên gia định tuyến (moe_intermediate_size = 384) để chọn ra Top-6 chuyên gia phù hợp nhất và chuẩn hóa tổng trọng số về 1 (norm_topk_prob = True), đồng thời cộng thêm đầu ra của 1 chuyên gia chung (shared_expert_intermediate_size = 768). Ở cuối lớp thứ 20, trạng thái ẩn h_talker đi qua đầu chiếu codec_head (Linear 1024 → 3072) để lấy mẫu mã âm thanh đầu tiên c_0 trước khi bàn giao sang 5-Layer Depth Code Predictor ở Cột 3.
Ví dụ đời thường: Hãy hình dung một nhạc trưởng điều khiển dàn nhạc 128 nhạc cụ (128 chuyên gia): ở mỗi nhịp 80 ms, nhạc trưởng chỉ gọi đúng 6 nhạc cụ phù hợp nhất với âm tiết hiện tại cùng 1 bè trầm nền luôn đánh (Shared Expert) để chốt nốt nhạc giai điệu chính (mã ngữ nghĩa c_0), rồi giao phần hòa âm 15 bè phụ cho nhóm phối khí nhanh ở Cột 3. Phép so sánh này dừng lại ở chỗ mỗi chuyên gia trong Talker là một mạng SwiGLU 1024 → 384 → 1024.
2Luồng
Cách đọc hình (Cột 2, khối 3C dưới đáy): nhận vector Dual-Track từ 3B, chạy qua 20 lớp Talker MoE (128 Experts Top-6 + Shared Expert, GQA 16Q/2KV) và chiếu codec_head để sinh mã ngữ nghĩa c_0, sau đó đẩy cặp [h_talker, c_0] sang 4A ở đầu Cột 3; xem bước [3C] trong [Bài Lab tổng hợp Qwen3-Omni](/courses/qwen3-omni-speech/qwen3-omni-lab/qwen3-omni-end-to-end-lab/) ở Tab 02.
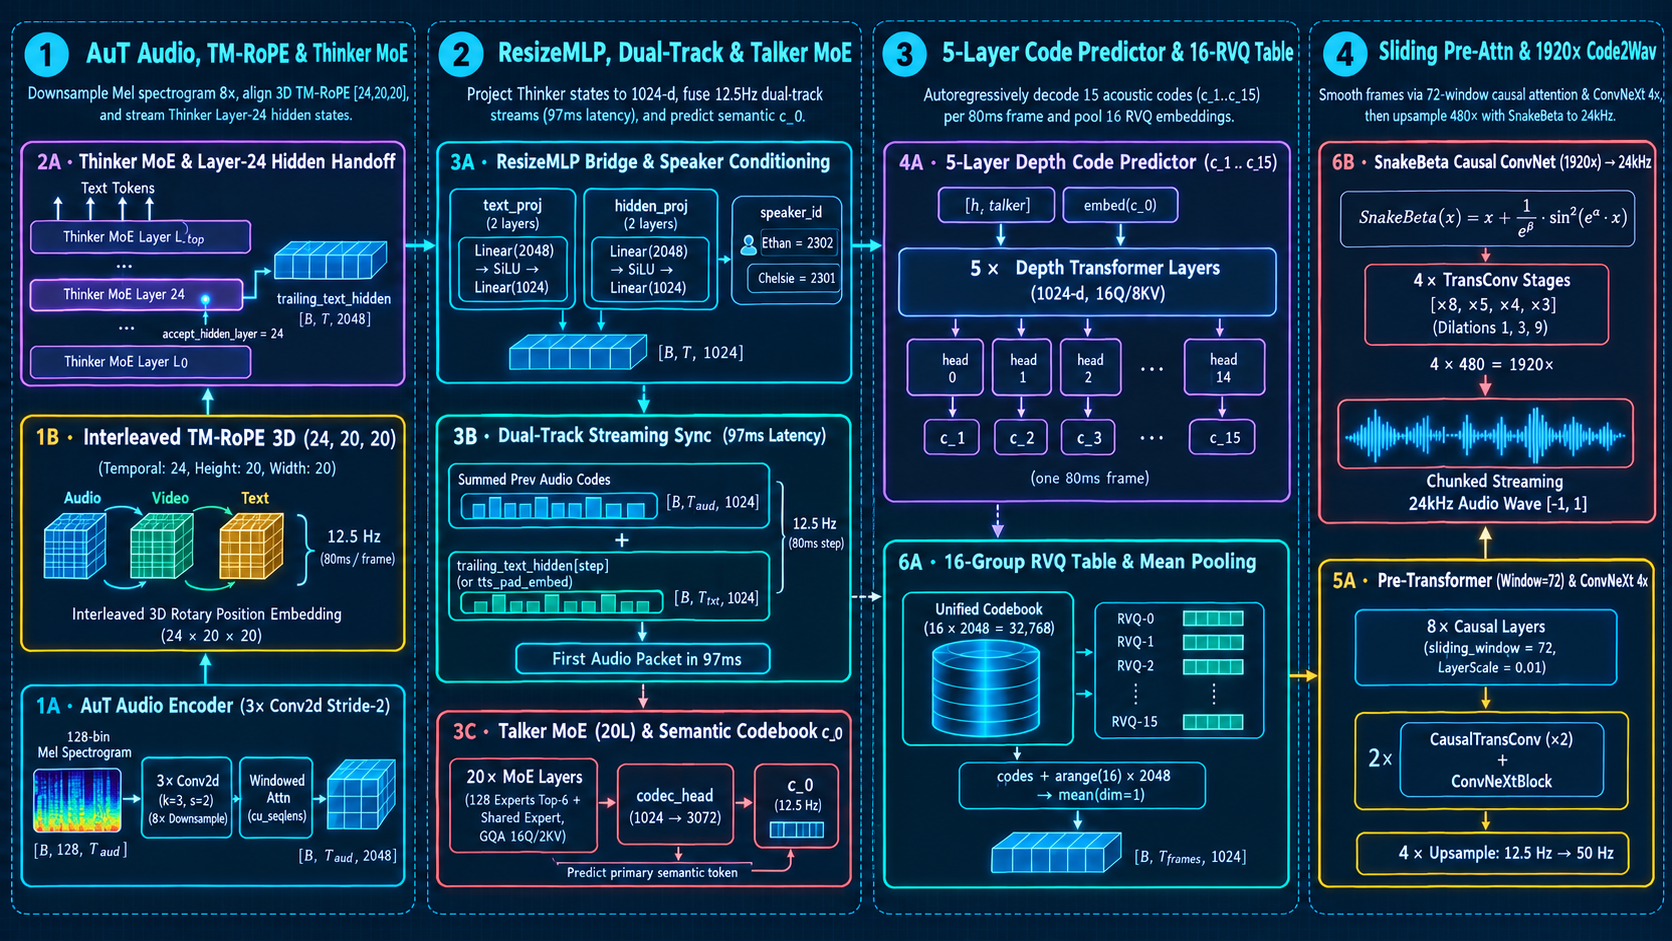
20× MoE Layers (1024-d, GQA 16Q/2KV, 128 Experts Top-6 + Shared) → codec_head(1024 → 3072) → Semantic Token c_03C · Talker MoE (20L) & Semantic Codebook c_0
Đáy Cột 2: chạy 20 lớp Talker MoE (128 chuyên gia chọn Top-6 + 1 chuyên gia chung) để xuất vector h_talker và dự đoán mã ngữ nghĩa chính c_0.
Ở đáy Cột 2, Qwen3OmniMoeTalkerForConditionalGeneration gồm 20 lớp MoE (chiều ẩn 1024, GQA 16 Q head / 2 KV head, định tuyến Top-6 trên 128 chuyên gia kích thước 384 cộng 1 chuyên gia chung kích thước 768). Ở cuối lớp thứ 20, mô hình xuất vector ngữ cảnh h_talker [B, 1, 1024] và chiếu qua codec_head (1024 → 3072) để lấy mẫu mã âm thanh đầu tiên c_0 — sổ mã nắm giữ nội dung phát âm và nhịp điệu chính của khung 80 ms hiện tại.
- 1. Chạy GQA (16 Q heads, 2 KV heads, head_dim = 128)
Áp dụng RMSNorm, xoay TM-RoPE 3D và tính Causal Self-Attention có lưu KV Cache theo từng khung 80 ms.
- 2. Định tuyến Top-6 trên 128 chuyên gia + 1 Shared Expert
Tính softmax trên 128 chuyên gia, chọn Top-6, chuẩn hóa lại tổng xác suất về 1 và cộng với nhánh Shared Expert.
- 3. Xuất h_talker sau 20 lớp và chiếu qua codec_head
Đưa last_hidden_state (h_talker ∈ [B, 1, 1024]) qua codec_head (1024 → 3072) và lấy mẫu mã c_0.
- 4. Chuyển cặp (h_talker, c_0) sang Cột 3 (4A)
Cung cấp cả vector ngữ cảnh h_talker lẫn mã c_0 vừa chọn làm đầu vào prefill cho 5-Layer Code Predictor.
Mã Mermaid
flowchart TD
  step1["1. Chạy GQA (16 Q heads, 2 KV heads, head_dim = 128)"]
  step2["2. Định tuyến Top-6 trên 128 chuyên gia + 1 Shared Expert"]
  step3["3. Xuất h_talker sau 20 lớp và chiếu qua codec_head"]
  step4["4. Chuyển cặp (h_talker, c_0) sang Cột 3 (4A)"]
  step1 --> step2
  step2 --> step3
step3 --> step43Giải pháp
Tại mỗi lớp MoE của Talker, với vector ẩn x ∈ R^{1024}, bộ định tuyến tính phân phối xác suất p = softmax(W_r x) ∈ R^{128}, chọn tập chỉ số Top-6 là S (|S| = 6) và chuẩn hóa lại trọng số (do norm_topk_prob = True): $$w_i = \frac{p_i}{\sum_{j \in S} p_j}, \quad y_{\text{MoE}} = \text{SharedMLP}(x) + \sum_{i \in S} w_i \cdot \text{Expert}_i(x)$$ Nhờ chỉ kích hoạt 6 chuyên gia nhỏ (384) và 1 chuyên gia chung (768), tổng chiều FFN hoạt động ở mỗi lớp chỉ là 6 × 384 + 768 = 3072 — nhẹ bằng một mô hình đặc cỡ ~0,8B tham số nhưng có dung lượng biểu diễn 128 phong cách âm học khác nhau.
Tại sao Talker chỉ dự đoán đúng 1 mã đầu tiên c_0 mà không dự đoán luôn cả 16 sổ mã? Vì 16 sổ mã tại cùng một khung 80 ms có phụ thuộc xác suất chặt chẽ với nhau (mã âm học c_1 phụ thuộc vào mã ngữ nghĩa c_0 vừa chọn, c_2 phụ thuộc vào c_1...). Nếu dự đoán độc lập song song cả 16 mã từ h_talker thì âm thanh sẽ bị rè do xung đột lượng tử hóa; còn nếu chạy tuần tự bằng một mạng Depth nhỏ hơn ở 4A thì vừa giữ được phụ thuộc nhân quả giữa các sổ mã vừa không tốn chi phí chạy lại 20 lớp MoE.
Bạn có thể kiểm tra trực tiếp bước định tuyến Top-6 (tổng trọng số chuẩn hóa bằng 1.0000) và việc chọn mã c_0 tại mục [3C] trong Bài Lab tổng hợp Qwen3-Omni.
4Profiling
- Tỷ lệ tham số FFN kích hoạt trong Talker MoE
So sánh chiều FFN kích hoạt (6 × 384 + 768 = 3072) với tổng chiều của cả 128 chuyên gia (128 × 384 + 768 = 49.920): mỗi khung 80 ms chỉ kích hoạt 3072 / 49920 ≈ 6,15% tổng tham số chuyên gia của Talker.
- Tỷ lệ nén KV Cache nhờ GQA 16Q / 2KV
Với 16 Q head nhưng chỉ 2 KV head, dung lượng KV Cache của 20 lớp Talker giảm đi 16 / 2 = 8 lần so với Multi-Head Attention tiêu chuẩn.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Kiểm tra chuẩn hóa trọng số Top-6 (norm_topk_prob = True)
Giả sử 6 chuyên gia đứng đầu có xác suất softmax gốc là [0.18, 0.14, 0.11, 0.09, 0.08, 0.05] (tổng = 0.65). Nhờ bật norm_topk_prob = True, mỗi trọng số được chia cho 0.65 để tổng 6 trọng số đưa vào tổ hợp tuyến tính bằng đúng 1.0.
6Thuật ngữ
- Talker MoE (128 Routed Top-6 + 1 Shared)
- Mỗi lớp trong 20 lớp của Talker kích hoạt 6 trên 128 chuyên gia (chiều ẩn 384) cộng 1 chuyên gia chung (chiều ẩn 768).
- codec_head (Linear 1024 → 3072)
- Đầu chiếu từ vựng của Talker (chia sẻ trọng số với bảng nhúng codec_embedding) dùng để dự đoán mã ngữ nghĩa đầu tiên c_0.
- Semantic Codebook c_0
- Sổ mã đầu tiên ở mỗi khung 12.5 Hz, nắm giữ cấu trúc âm vị và ngữ điệu chính của tiếng nói.
Glossary (2)
- norm_topk_prob = True
- Chuẩn hóa lại tổng xác suất của K chuyên gia được chọn về bằng 1 trước khi nhân với đầu ra từng chuyên gia.
- GQA 16Q / 2KV
- Cơ chế 16 đầu truy vấn chia sẻ 2 đầu khóa/giá trị (mỗi nhóm 8 Q head dùng chung 1 KV head).