2A · Thinker Layer-24 Handoff
2A · Thinker MoE Backbone & Chuyển giao trạng thái ẩn tại Lớp 24
Khối suy luận Thinker MoE vừa phát văn bản ở tầng đỉnh, vừa trích ngang trạng thái ẩn tại lớp thứ 24 (accept_hidden_layer = 24) để chuyển sang Talker.
1Định nghĩa
Ở đỉnh Cột 1, sau khi các luồng âm thanh, hình ảnh và văn bản đã được gắn góc xoay TM-RoPE 3D, chúng đi vào mô hình ngôn ngữ trung tâm mang tên Thinker (Qwen3OmniMoeThinkerForConditionalGeneration). Thinker đóng vai trò là "bộ não suy luận": nó hiểu câu hỏi đa phương thức và sinh ra từng token văn bản trả lời với chiều ẩn 2048.
Nếu bắt bộ phát giọng nói phải chờ Thinker đọc xong từ vựng hoặc chỉ nhận chuỗi chữ cái khô khan thì giọng nói sẽ mất hết ngữ điệu cảm xúc. Vì vậy, Qwen3-Omni thiết kế một điểm trích ngang ngay tại lớp ẩn thứ 24 (accept_hidden_layer = 24): mỗi khi Thinker vừa sinh ra một token chữ mới, trạng thái ẩn tại lớp 24 của vị trí đó được đóng gói vào luồng trailing_text_hidden và đẩy ngay sang cầu nối ResizeMLP ở Cột 2.
Ví dụ đời thường: Hãy hình dung một diễn giả vừa suy nghĩ vừa nói: tầng cuối cùng của suy nghĩ là bản tốc ký chỉ ghi chữ cái trên giấy, nhưng ở tầng suy nghĩ sâu thứ 24 trước đó vẫn còn nguyên ý định nhấn giọng, sự ngạc nhiên hay nhịp nghỉ câu; truyền thẳng luồng ý định ở tầng 24 này xuống thanh quản (Talker) giúp giọng đọc tự nhiên hơn hẳn việc đọc lại từ mặt giấy. Phép so sánh này dừng lại ở chỗ trạng thái lớp 24 chỉ là một vector số thực 2048 chiều trích từ mảng hidden_states[24].
2Luồng
Cách đọc hình (Cột 1, khối 2A trên đỉnh): nhận chuỗi đã gắn TM-RoPE từ 1B, chạy qua chồng lớp Thinker MoE để phát Text Tokens ở đỉnh đồng thời mở nhánh trích ngang tại accept_hidden_layer = 24 (trailing_text_hidden [B, T, 2048]) đẩy sang 3A ở đầu Cột 2; xem bước [2A] trong [Bài Lab tổng hợp Qwen3-Omni](/courses/qwen3-omni-speech/qwen3-omni-lab/qwen3-omni-end-to-end-lab/) ở Tab 02.
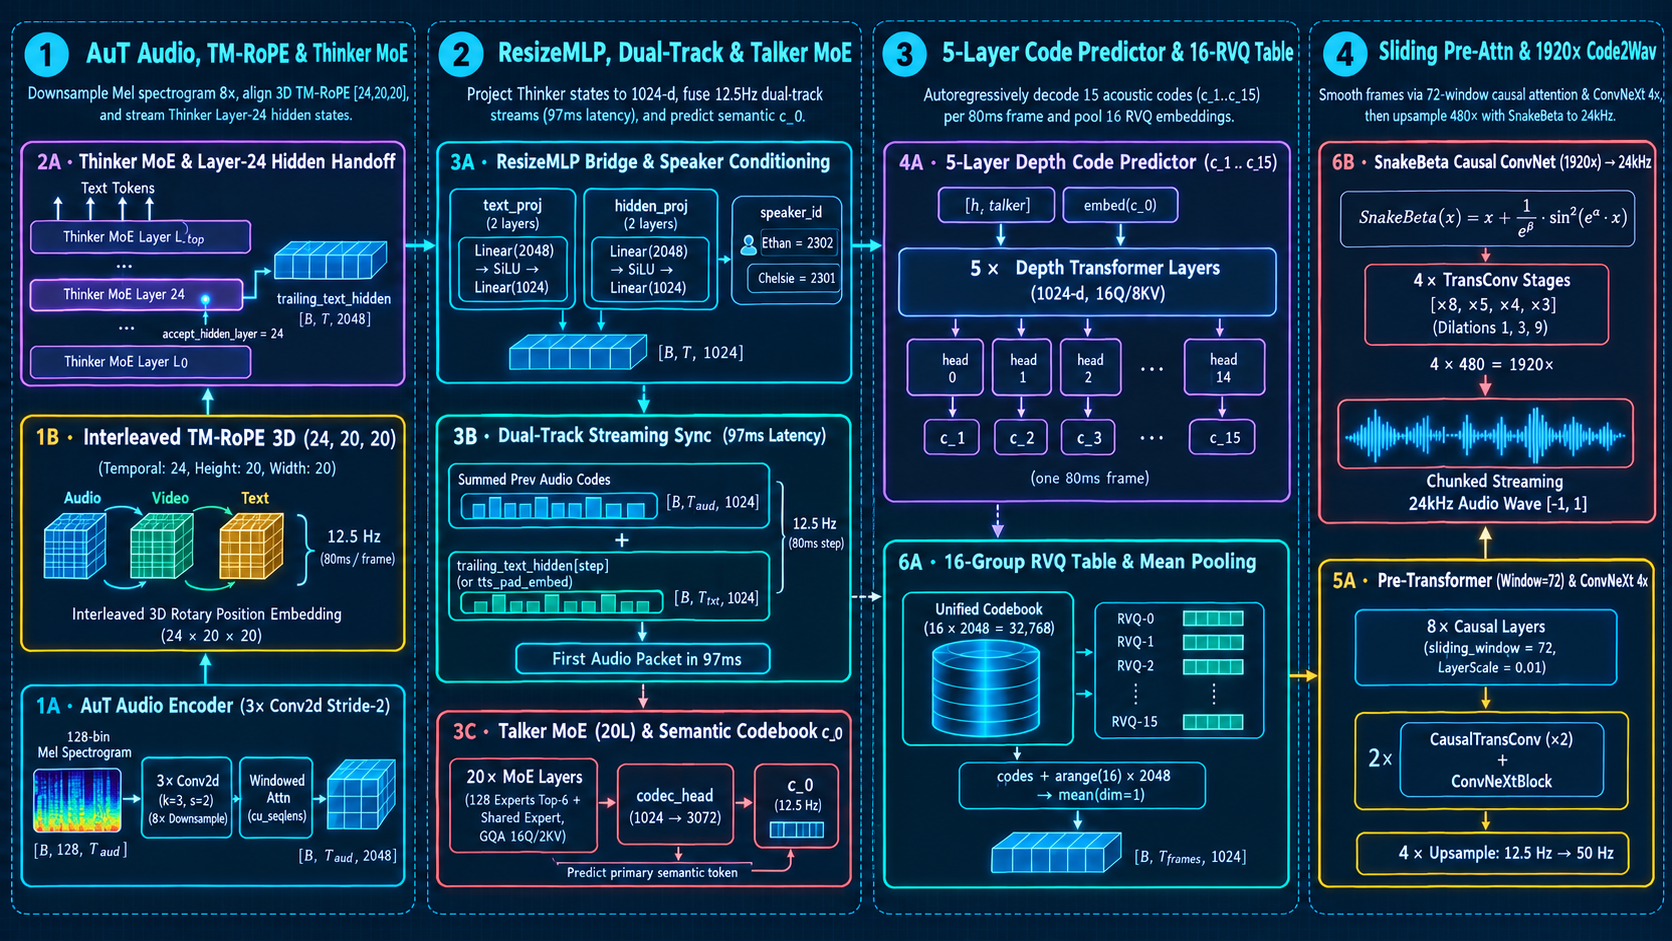
Thinker MoE L0..L_top → Text Tokens + tap at accept_hidden_layer = 24 → trailing_text_hidden [B, T_txt, 2048]2A · Thinker MoE & Layer-24 Hidden Handoff
Ở đỉnh Cột 1: khối Thinker MoE vừa sinh văn bản phản hồi ở tầng cuối, vừa trích ngang trạng thái ẩn tại lớp 24 (accept_hidden_layer = 24) truyền sang Talker.
Trên đỉnh Cột 1, khối suy luận trung tâm Thinker (Qwen3OmniMoeThinkerForConditionalGeneration) xử lý ngữ cảnh đa phương thức để sinh chuỗi token văn bản. Điểm thiết kế tinh tế là Talker không đọc trạng thái ẩn ở lớp cuối cùng (vốn đã bị ép quá sát về không gian từ vựng chữ viết) mà trích ngang trạng thái ẩn tại lớp thứ 24 (accept_hidden_layer = 24, chiều 2048) làm luồng trailing_text_hidden giàu ngữ điệu để chuyển sang Cột 2 ngay khi từng chữ vừa xuất hiện.
- 1. Chạy tiền xử lý & Prefill trên Thinker MoE
Đưa chuỗi đa phương thức qua các lớp MoE của Thinker với output_hidden_states = True.
- 2. Sinh token văn bản ở tầng đỉnh (LM Head)
Tầng cuối cùng chiếu ra từ vựng để trả về câu trả lời văn bản trực tiếp cho người dùng.
- 3. Trích ngang hidden_states[24] (accept_hidden_layer)
Lấy vector ẩn chiều 2048 tại lớp thứ 24 cho từng token văn bản vừa sinh.
- 4. Đẩy trailing_text_hidden sang Talker theo thời gian thực
Chuyển ngay cặp (talker_input_ids, hidden_states[24]) sang Cột 2 để bắt đầu phát âm thanh.
Mã Mermaid
flowchart TD
  step1["1. Chạy tiền xử lý #amp; Prefill trên Thinker MoE"]
  step2["2. Sinh token văn bản ở tầng đỉnh (LM Head)"]
  step3["3. Trích ngang hidden_states#91;24#93; (accept_hidden_layer)"]
  step4["4. Đẩy trailing_text_hidden sang Talker theo thời gian thực"]
  step1 --> step2
  step2 --> step3
step3 --> step43Giải pháp
Tại sao không lấy trạng thái ẩn của lớp cuối cùng (last_hidden_state) mà lại lấy ở lớp trung gian accept_hidden_layer = 24? Ở các lớp sát đầu ra LM Head của một mô hình ngôn ngữ tự hồi quy, không gian biểu diễn bị nén mạnh để tối ưu xác suất dự đoán đúng 1 từ tiếp theo (next-token prediction), làm rơi rớt các thông tin toàn cục về ngữ cảnh câu hỏi, cảm xúc âm thanh đầu vào và sắc thái biểu cảm. Lớp 24 nằm ở điểm cân bằng lý tưởng: vừa đã hình thành xong ý nghĩa của từ sắp nói, vừa giữ nguyên đặc trưng đa phương thức.
Trong hàm generate của Qwen3OmniMoeForConditionalGeneration, Thinker được gọi với return_dict_in_generate = True, output_hidden_states = True. Với mỗi bước sinh văn bản thứ s, hệ thống gom hidden_states[s][accept_hidden_layer] để tạo thành tensor trailing_text_hidden có shape [B, T_text, 2048].
Nhờ tách biệt hoàn toàn trọng số của Thinker (chuyên suy luận đa phương thức) và Talker (chuyên tổng hợp mã âm thanh), việc huấn luyện khả năng nói hoàn toàn không làm suy giảm điểm số toán học hay lập trình của Thinker (zero unimodal regression). Bạn có thể xem cách trích xuất lớp trung gian này tại mục [2A] của Bài Lab tổng hợp Qwen3-Omni.
4Profiling
- Độ phong phú thông tin (Phương sai / Entropy đặc trưng) tại Lớp 24 so với Lớp cuối
So sánh phân phối trạng thái ẩn tại lớp trung gian (accept_hidden_layer) và lớp ngay trước LM Head: lớp trung gian giữ lại thành phần phương sai ngữ cảnh đa phương thức để điều khiển ngữ điệu Talker.
- Băng thông truyền giữa Thinker và Talker
Mỗi token văn bản chỉ cần truyền 1 vector 2048 số BF16 (4 KB/token) trong bộ nhớ GPU, chi phí truyền gần như bằng 0.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Đối chiếu hai nhánh đầu ra của Thinker ở khối 2A
Cùng một lượt chạy Thinker: nhánh thẳng lên đỉnh đi qua lm_head để in chữ lên màn hình chat; nhánh ngang ở lớp 24 xuất vector 2048 chiều làm đầu vào cho ResizeMLP ở Cột 2.
6Thuật ngữ
- accept_hidden_layer = 24
- Chỉ số tầng ẩn của Thinker được trích ngang để truyền biểu diễn ngữ nghĩa - ngữ điệu sang Talker.
- trailing_text_hidden
- Hàng đợi chứa các vector trạng thái ẩn lớp 24 của những token văn bản mà Thinker sinh ra sau bước prefill.
- talker_input_ids
- Chuỗi mã token văn bản do Thinker sinh ra, dùng để cấp nhúng chữ và tính vị trí 3D RoPE cho Talker.
Glossary (2)
- Thinker–Talker Architecture
- Kiến trúc tách mô hình thành 2 khối MoE độc lập: Thinker chuyên hiểu/suy luận sinh chữ và Talker chuyên sinh mã giọng nói từ trạng thái ẩn của Thinker.
- Unimodal Non-Regression
- Đảm bảo khả năng suy luận văn bản thuần túy không bị giảm chất lượng khi thêm khả năng phát giọng nói.