5A · Pre-Transformer & ConvNeXt 4×
5A · Code2Wav Pre-Transformer (Cửa sổ trượt 72) & Phóng đại ConvNeXt 4×
Làm mượt chuỗi vector khung 12.5 Hz bằng 8 lớp Attention nhân quả có cửa sổ trượt 72 khung (LayerScale 0.01) rồi nâng tần số 4× lên 50 Hz qua 2 tầng ConvNeXt.
1Định nghĩa
Sau khi bảng nhúng 16-Group RVQ ở 6A gộp 16 sổ mã thành một chuỗi vector liên tục ở tần số 12.5 Hz, tín hiệu được chuyển sang nửa dưới Cột 4 (5A) để bước vào giai đoạn đầu của bộ giải mã Qwen3OmniMoeCode2Wav. Nếu đưa thẳng các vector vừa cộng trung bình từng khung vào mạng tích chập phóng đại sóng âm thì tại ranh giới giữa hai khung 80 ms liền kề rất dễ xuất hiện tiếng nổ nhỏ (click/pop artifacts) do thiếu sự chuyển tiếp mượt mà.
Để khử hiện tượng đứt gãy biên khung mà vẫn giữ được khả năng phát trực tuyến (streaming), khối 5A cho chuỗi vector đi qua mạng pre_transformer gồm 8 lớp Attention nhân quả có cửa sổ trượt sliding_window = 72 và hệ số LayerScale khởi tạo bằng 0.01. Ngay sau đó, tín hiệu đi qua 2 tầng phóng đại sơ cấp (upsampling_ratios = [2, 2]), mỗi tầng gồm một lớp tích chập chuyển vị nhân quả Qwen3OmniMoeCausalTransConvNet(×2) đi kèm một khối Qwen3OmniMoeConvNeXtBlock để nâng tốc độ khung từ 12.5 Hz lên 50 Hz trước khi đẩy lên bộ giải mã SnakeBeta 480× ở 6B.
Ví dụ đời thường: Hãy hình dung việc dựng một bộ phim hoạt hình từ các bức tranh tĩnh tốc độ 12,5 hình/giây: trước khi phóng to độ phân giải từng bức, người kỹ thuật viên đặt một thước ngắm trượt dài 72 hình đã qua để làm mượt chuyển động giữa các hình liền nhau, rồi chèn thêm các hình trung gian để tăng tốc độ khung hình lên gấp 4 lần (50 hình/giây). Phép so sánh này dừng lại ở chỗ mọi phép nội suy trong 5A đều là Attention nhân quả và tích chập chuyển vị một chiều.
2Luồng
Cách đọc hình (Cột 4, khối 5A nửa dưới): nhận vector khung [B, T_frames, 1024] từ 6A (Cột 3) sang Cột 4 dưới, chạy qua 8 lớp Causal Pre-Transformer (sliding_window = 72, LayerScale = 0.01) và 2 chặng CausalTransConv(×2) + ConvNeXtBlock để phóng đại 4× (12.5 Hz → 50 Hz) rồi đẩy lên 6B; xem bước [5A] trong [Bài Lab tổng hợp Qwen3-Omni](/courses/qwen3-omni-speech/qwen3-omni-lab/qwen3-omni-end-to-end-lab/) ở Tab 02.
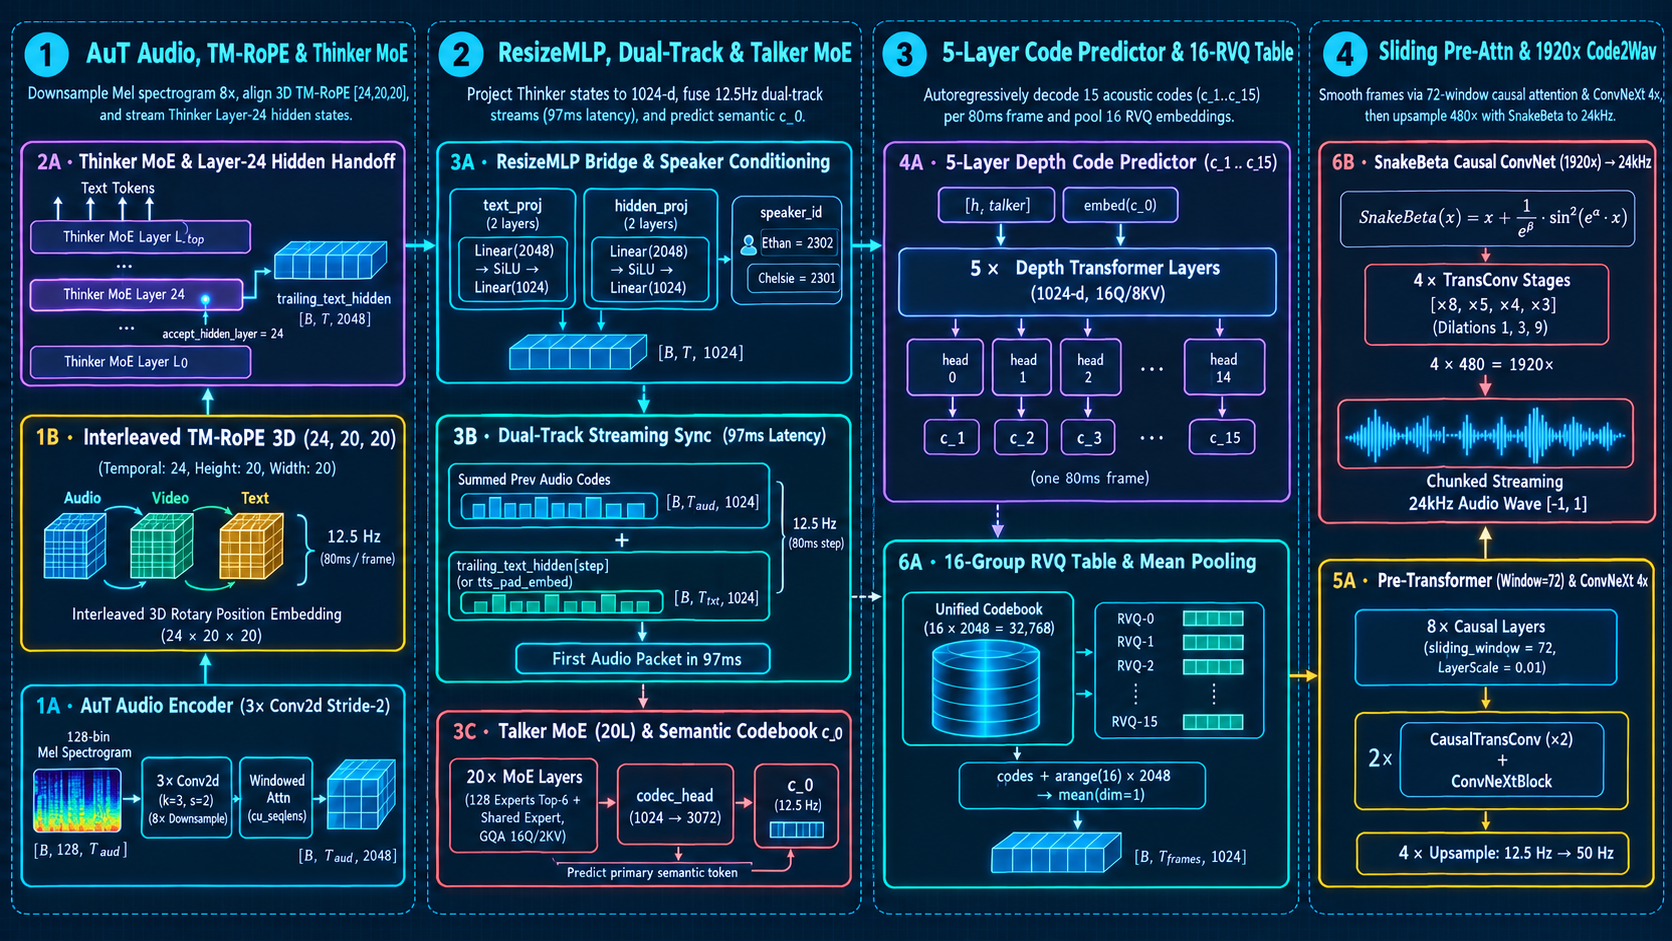
8× Causal Layers (sliding_window = 72, LayerScale = 0.01) → 2× [CausalTransConv(×2) + ConvNeXtBlock] (12.5 Hz → 50 Hz)5A · Pre-Transformer (Window=72) & ConvNeXt 4×
Nửa dưới Cột 4: làm mượt chuỗi khung RVQ qua 8 lớp Attention nhân quả cửa sổ trượt 72 khung và nâng tần số 4× (12.5 Hz → 50 Hz) bằng ConvNeXt.
Vector trung bình từ 6A (Cột 3) đi sang 5A ở nửa dưới Cột 4: trước khi phóng đại thành sóng âm, chuỗi khung đi qua pre_transformer gồm 8 lớp Attention nhân quả có cửa sổ trượt sliding_window = 72 (chỉ nhìn tối đa 72 khung đứng trước ≈ 5,76 giây để giữ độ trễ cố định khi phát trực tuyến dài) kèm hệ số LayerScale khởi tạo ở 0.01. Tiếp đó, 2 tầng CausalTransConvNet(×2) kết hợp ConvNeXtBlock phóng đại trục thời gian lên 2 × 2 = 4 lần (từ 12.5 Hz lên 50 Hz).
- 1. Nhận chuỗi vector trung bình 16-RVQ [B, T, 1024]
Lấy đầu ra từ phép code_embedding(codes + code_offset).mean(1) ở khối 6A.
- 2. Chạy 8 lớp Pre-Transformer (Sliding Window = 72)
Áp dụng mặt nạ nhân quả cửa sổ trượt 72 khung, xoay RoPE và nhân LayerScale (0.01) trên từng lớp.
- 3. Đảo trục [B, T, 1024] → [B, 1024, T] cho tích chập 1D
Chuyển trục thời gian về cuối để đưa vào chuỗi tích chập nhân quả 1 chiều.
- 4. Phóng đại 2 × 2 = 4× qua CausalTransConvNet & ConvNeXtBlock
Nhân đôi số bước thời gian 2 lần liên tiếp (T → 2T → 4T, từ 12.5 Hz lên 50 Hz) và đẩy lên khối 6B.
Mã Mermaid
flowchart TD
  step1["1. Nhận chuỗi vector trung bình 16-RVQ #91;B, T, 1024#93;"]
  step2["2. Chạy 8 lớp Pre-Transformer (Sliding Window = 72)"]
  step3["3. Đảo trục #91;B, T, 1024#93; → #91;B, 1024, T#93; cho tích chập 1D"]
  step4["4. Phóng đại 2 × 2 = 4× qua CausalTransConvNet #amp; ConvNeXtBlock"]
  step1 --> step2
  step2 --> step3
step3 --> step43Giải pháp
Mặt nạ nhân quả cửa sổ trượt (Sliding-Window Causal Mask) với kích thước W = 72 trong pre_transformer chỉ cho phép vị trí truy vấn q đọc vị trí khóa k khi thỏa mãn đồng thời hai bất đẳng thức: $$0 \le q - k < 72$$ Điều kiện thứ nhất (k ≤ q) đảm bảo tính nhân quả tuyệt đối: khi đang phát trực tuyến ở khung q, mô hình không cần biết khung q + 1 ở tương lai. Điều kiện thứ hai (q − k < 72) giới hạn vùng nhìn quá khứ trong đúng 72 khung (5,76 giây), giúp độ phức tạp tính toán mỗi khung là hằng số O(W) bất kể cuộc hội thoại kéo dài bao lâu.
Sau 8 lớp Pre-Transformer, tensor được hoán vị từ (B, T, 1024) sang (B, 1024, T) và đi qua 2 chặng trong self.upsample (ứng với upsampling_ratios = [2, 2]). Mỗi chặng gồm một lớp tích chập chuyển vị nhân quả Qwen3OmniMoeCausalTransConvNet(1024, 1024, kernel=2, stride=2) nhân đôi chiều dài thời gian, theo sau là khối Qwen3OmniMoeConvNeXtBlock (tích chập chiều sâu depthwise 7×1 → LayerNorm → Linear mở rộng → GELU → Linear thu hẹp → cộng residual).
Bạn có thể kiểm chứng cả hai tính chất — độ dài thời gian tăng đúng 4× và tính cô lập nhân quả tuyệt đối (thay đổi khung cuối không làm rò rỉ 0.00e+00 về các khung trước) — tại mục [5A] của Bài Lab tổng hợp Qwen3-Omni.
4Profiling
- Cô lập nhân quả trên Pre-Transformer và CausalTransConvNet
Thay đổi mã RVQ tại khung thời gian cuối cùng (frame T-1) và đo sai lệch trên các khung 0..T-2 sau khi đi qua 5A: sai lệch phải bằng đúng 0.00e+00.
- Hệ số phóng đại thời gian sơ cấp (4×)
Với T_frames khung đầu vào ở tần số 12.5 Hz, chiều dài trục thời gian sau khối 5A luôn bằng đúng 4 × T_frames (tương ứng 50 Hz).
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Biến đổi kích thước qua khối 5A
Nếu đầu vào từ 6A có 4 khung thời gian ở chiều ẩn 1024 (shape [1, 4, 1024]): sau 8 lớp Pre-Transformer vẫn là [1, 4, 1024]; sau tầng upsample ×2 thứ nhất thành [1, 1024, 8]; và sau tầng upsample ×2 thứ hai thành [1, 1024, 16] (tăng đúng 4 lần số bước thời gian).
6Thuật ngữ
- sliding_window = 72 (Causal Pre-Transformer)
- Mỗi khung âm thanh chỉ nhìn về tối đa 72 khung đứng trước nó (72 × 80 ms = 5,76 giây) và không bao giờ nhìn sang tương lai.
- layer_scale_initial_scale = 0.01
- Vector hệ số nhân dọc theo kênh ở đầu ra mỗi nhánh Attention/MLP giúp ổn định biên độ trong 8 lớp Pre-Transformer.
- upsampling_ratios = [2, 2] (CausalTransConv + ConvNeXt)
- Hai chặng phóng đại trục thời gian ×2 liên tiếp (tổng 4×), đưa tần số khung từ 12.5 Hz lên 50 Hz.
Glossary (2)
- Causal Transposed Convolution
- Phép tích chập chuyển vị dùng đệm lệch trái để phóng đại trục thời gian mà không làm rò rỉ thông tin từ tương lai về quá khứ.
- ConvNeXt Block 1D
- Khối tích chập hiện đại gồm Depthwise Conv1D nhân 7 kết hợp MLP đảo ngược (Inverted Bottleneck) và chuẩn hóa kênh.