4A · 5-Layer Code Predictor
4A · 5-Layer Depth Code Predictor (Tự hồi quy 15 mã âm học c_1 .. c_15 trong 80 ms)
Mạng Transformer 5 lớp theo chiều sâu nhận [h_talker, embed(c_0)] và chạy 15 bước vi mô qua 15 đầu lm_head riêng để sinh nốt các mã âm học c_1 đến c_15.
1Định nghĩa
Ở nửa trên Cột 3 là mô-đun giải quyết nghịch lý giữa chất lượng âm thanh cao (cần nhiều sổ mã RVQ) và độ trễ thấp: Qwen3OmniMoeTalkerCodePredictorModelForConditionalGeneration. Sau khi 20 lớp Talker MoE ở 3C vừa chốt xong mã ngữ nghĩa đầu tiên c_0 cho khung 80 ms hiện tại, ta còn phải tìm thêm 15 mã âm học chi tiết (c_1 đến c_15) để đủ 16 tầng lượng tử hóa (num_code_groups = 16).
Thay vì bắt mạng Talker 20 lớp nặng nề phải chạy thêm 15 lần, Qwen3-Omni giao việc này cho một mạng Transformer đặc chỉ có 5 lớp (num_hidden_layers = 5, hidden_size = 1024, 16 Q head, 8 KV head, FFN 3072). Mạng này chạy tự hồi quy theo trục chiều sâu (Depth Autoregression) ngay bên trong khung 80 ms đó: bước đầu tiên nhận cặp prefill dài 2 vị trí [h_talker, embed(c_0)] để dự đoán c_1; các bước tiếp theo lần lượt đưa c_1 vào để sinh c_2, cứ thế cho đến c_15 rồi chuyển toàn bộ 16 mã xuống bảng nhúng 16-Group RVQ ở 6A.
Ví dụ đời thường: Hãy hình dung một họa sĩ trưởng (Talker 20 lớp) phác nét chính của mỗi khung hình hoạt hình (c_0), rồi chuyển ngay khung đó cho một nhóm 5 trợ lý tô màu nhanh (5-Layer Code Predictor) ngồi ngay cạnh để tô nối tiếp 15 lớp bóng đổ và chất liệu chi tiết (c_1..c_15) trước khi chuyển sang khung hình tiếp theo. Phép so sánh này dừng lại ở chỗ mỗi lớp chi tiết k trong Code Predictor dùng một bảng nhúng và một ma trận chiếu đầu ra lm_head[k] riêng biệt.
2Luồng
Cách đọc hình (Cột 3, khối 4A nửa trên): nhận cặp [h_talker, embed(c_0)] từ 3C (Cột 2), chạy qua 5 lớp Depth Transformer và 15 đầu chiếu riêng head 0..14 để sinh tuần tự c_1 → c_2 → ... → c_15 trong cùng một khung 80 ms, sau đó chuyển đủ 16 mã xuống bảng RVQ ở 6A; xem bước [4A] trong [Bài Lab tổng hợp Qwen3-Omni](/courses/qwen3-omni-speech/qwen3-omni-lab/qwen3-omni-end-to-end-lab/) ở Tab 02.
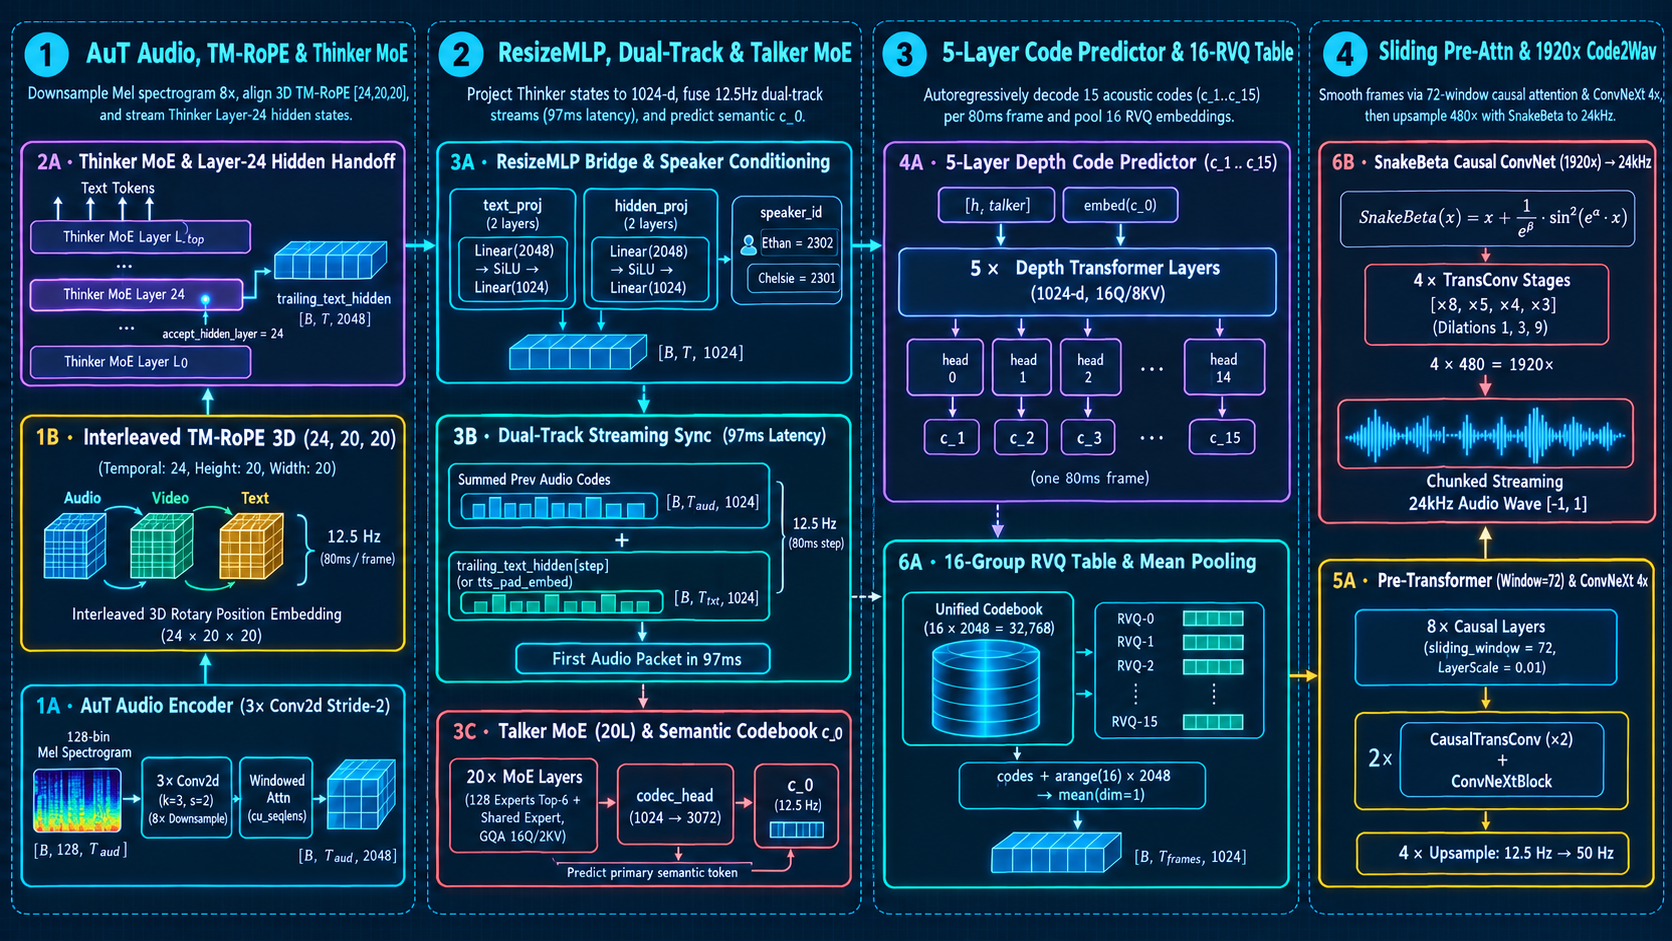
Prefill [h_talker, embed(c_0)] → 5× Depth Layers (1024-d, 16Q/8KV) → 15× Step Heads lm_head[0..14] (1024 → 2048) → c_1..c_154A · 5-Layer Depth Code Predictor (c_1 .. c_15)
Nửa trên Cột 3: mạng Transformer 5 lớp theo chiều sâu tự hồi quy sinh nốt 15 mã âm học chi tiết (c_1 .. c_15) ngay bên trong một khung 80 ms.
Ở nửa trên Cột 3, nếu bắt Talker 20 lớp chạy nối tiếp 16 lần cho 16 sổ mã thì tốc độ sẽ chậm gấp 16 lần. Thay vào đó, Qwen3-Omni đưa cặp [h_talker, embed(c_0)] vào một mạng Qwen3OmniMoeTalkerCodePredictorModel chỉ sâu 5 lớp (chiều ẩn 1024, GQA 16Q/8KV, FFN 3072). Mạng này chạy 15 bước vi mô theo trục chiều sâu: ở bước k (từ 0 đến 14), nó dùng bảng nhúng riêng embed_tokens[k-1] và đầu dự đoán riêng lm_head[k] (Linear 1024 → 2048) để sinh lần lượt c_1, c_2, ..., c_15.
- 1. Prefill 2 vị trí [h_talker, embed(c_0)] (generation_steps = 0)
Ghép trạng thái ẩn của Talker và nhúng của mã ngữ nghĩa c_0 đưa qua 5 lớp Depth Transformer, dùng lm_head[0] sinh c_1.
- 2. Lặp các bước vi mô generation_steps = 1 .. 14
Tại bước k, tra bảng nhúng riêng embed_tokens[k-1](c_k), chạy qua 5 lớp (có dùng KV Cache nội bộ) và chiếu lm_head[k] sinh c_{k+1}.
- 3. Thu đủ bộ 16 mã rời rạc [c_0, c_1, ..., c_15]
Ghép mã c_0 của Talker với 15 mã âm học c_1..c_15 của Code Predictor cho khung 80 ms hiện tại.
- 4. Xóa KV Cache nội bộ của Code Predictor khi sang khung mới
Vì Code Predictor chỉ tự hồi quy theo chiều sâu trong phạm vi 1 khung 80 ms, sang khung thời gian t+1 nó bắt đầu lại từ [h_talker_{t+1}, c_0_{t+1}].
Mã Mermaid
flowchart TD
  step1["1. Prefill 2 vị trí #91;h_talker, embed(c_0)#93; (generation_steps = 0)"]
  step2["2. Lặp các bước vi mô generation_steps = 1 .. 14"]
  step3["3. Thu đủ bộ 16 mã rời rạc #91;c_0, c_1, ..., c_15#93;"]
  step4["4. Xóa KV Cache nội bộ của Code Predictor khi sang khung mới"]
  step1 --> step2
  step2 --> step3
step3 --> step43Giải pháp
Hãy nhìn trực tiếp vào hàm forward của Qwen3OmniMoeTalkerCodePredictorModelForConditionalGeneration trong modeling_qwen3_omni_moe.py: ở bước prefill khi inputs_embeds có chiều dài chuỗi bằng 2 (gồm h_talker và embed(c_0)), chỉ số bước được tính là generation_steps = inputs_embeds.shape[1] - 2 = 0, và đầu ra lấy từ self.lm_head[0](hidden_states) để sinh mã c_1. Ở các bước giải mã tiếp theo (generation_steps = 1..14), đầu vào chỉ dài 1 token và được tra từ bảng nhúng riêng của tầng trước đó: inputs_embeds = self.model.get_input_embeddings()[generation_steps - 1](input_ids), rồi chiếu qua self.lm_head[generation_steps](hidden_states).
Tại sao mỗi tầng RVQ k lại phải có một đầu lm_head[k] và bảng embed_tokens[k] riêng thay vì dùng chung một bảng 2048 mã? Trong lượng tử hóa vector phần dư (Residual Vector Quantization — RVQ), tầng k mã hóa phần sai số còn sót lại sau khi đã trừ đi các tầng 0..k-1: tầng 1 nắm đường bao phổ thô, tầng 5 nắm cấu trúc hài âm trung bình, còn tầng 15 nắm nhiễu tần số cao rất nhỏ. Do ý nghĩa vật lý và biên độ của mã số 42 ở tầng 1 hoàn toàn khác mã số 42 ở tầng 15, việc tách riêng 15 bảng nhúng và 15 đầu chiếu lm_head là bắt buộc.
Hơn nữa, vì chuỗi chiều sâu trong một khung 80 ms chỉ dài tối đa 16 vị trí (2 vị trí prefill + 14 vị trí tiếp theo) và mạng chỉ sâu 5 lớp, toàn bộ 15 bước của Code Predictor chỉ tốn vài mili-giây trên GPU. Bạn có thể theo dõi từng bước generation_steps sinh ra các mã c_1..c_3 trong cấu hình thu nhỏ tại mục [4A] của Bài Lab tổng hợp Qwen3-Omni.
4Profiling
- Độ dài chuỗi tối đa của KV Cache trong Code Predictor
Đếm số vị trí trong past_key_values của Code Predictor khi kết thúc 1 khung 80 ms: chỉ đúng 16 vị trí (h_talker + c_0..c_14), sau đó được giải phóng ngay khi sang khung 80 ms tiếp theo.
- Tỷ lệ giảm chiều sâu mạng mỗi bước mã âm học
So sánh 5 lớp đặc của Code Predictor với 20 lớp MoE của Talker: giảm 4 lần số lớp phải đi qua cho mỗi mã trong 15 mã âm học dư.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Theo dõi chỉ số generation_steps từ 0 đến 14
Bước 0 (prefill 2 vị trí [h_talker, c_0]): dùng lm_head[0] → sinh c_1. Bước 1 (đầu vào c_1 qua embed[0]): dùng lm_head[1] → sinh c_2. ... Bước 14 (đầu vào c_14 qua embed[13]): dùng lm_head[14] → sinh c_15. Tổng cộng thu đủ 16 mã [c_0, c_1, ..., c_15].
6Thuật ngữ
- num_code_groups = 16 (1 Semantic + 15 Acoustic)
- Tổng số sổ mã tại mỗi khung 80 ms: sổ 0 do Talker dự đoán, 15 sổ còn lại (1..15) do Code Predictor dự đoán.
- Per-Step lm_head = ModuleList(15 × Linear)
- 15 đầu chiếu tuyến tính riêng biệt (1024 → 2048), mỗi đầu chuyên dự đoán phân phối từ vựng của đúng một tầng RVQ thứ k.
- generation_steps (0 .. 14)
- Chỉ số bước vi mô bên trong một khung 80 ms, dùng để chọn đúng bảng nhúng embed_tokens[step-1] và đầu ra lm_head[step].
Glossary (2)
- Depth Transformer (RQ-Transformer)
- Mạng Transformer nhỏ chạy dọc theo trục các tầng lượng tử hóa (codebooks) tại cùng một thời điểm thay vì chạy dọc theo trục thời gian.
- Step-Specific Embeddings & Heads
- Bộ bảng nhúng và ma trận đầu ra tách riêng cho từng tầng RVQ thứ k.