Lab tổng hợp · 1A → 6B
Lab tổng hợp DeepSeek-V4.1-Flash — chạy toàn trình 1A → 6B bằng NumPy
Chạy toàn trình kiến trúc DeepSeek-V4.1-Flash bằng NumPy thuần: prompt đa phương thức, Engram, mHC, CSA2, MLA, MoE, ngân sách KV và DSpark, khớp mã khối 1A–6B.
1Định nghĩa
Bài học này là lab tổng hợp của khoá: nó ghép mười mã khối 1A – 6B của sơ đồ kiến trúc DeepSeek-V4.1-Flash thành một lượt forward duy nhất chạy bằng NumPy thuần, trong trình duyệt. Từng bài rời như ranh giới Causal Encoder–Decoder hay CSA2 nén và chia sẻ KV dạy một cơ chế riêng; ở đây bạn thấy mối nối giữa chúng: hidden state mà attention đọc đúng bằng hc_pre mà mHC (2A) vừa gộp xong, và mỗi con số in ở một mã khối đến từ đúng trạng thái mà mã liền trước đã ghi lại.
Một lượt chạy gồm prefill của DEMO_PROMPT = [1, 2, 3, 4] (vị trí 1 là token ảnh, bị che bằng DEAD = -1 trên bản đồ token nén — xem Aligner đa phương thức), hai bước decode tại start_pos 4 và 5, rồi các phép kiểm chứng. Cache chỉ được ghi tại lớp nguồn: Engram bộ nhớ có điều kiện chặn băm cắt ngang ảnh, Compressor tỉ lệ r gộp hai token thành một latent, còn MLA và W_O nhóm cho cả hai Q head dùng chung một bộ K/V một head. L2 và L4 không mang cache riêng, chỉ đọc lại mảng của L1 và L3; phần kiểm chứng đối chiếu array_equal và độ lệch decode dưới 1e-9.
Ví dụ đời thường: giống như một xưởng đóng gói theo dây chuyền có kho chung. Trang ảnh được dán nhãn riêng trước khi vào dây chuyền (1A), câu chữ được đánh chỉ mục nhưng bỏ qua trang ảnh (1B), bốn bản thảo song song được trộn đúng tỉ lệ đã cân bằng (2A), kho chỉ giữ bản nén thay cho bản gốc (3B), quầy xuất hóa đơn niêm yết giá sẵn (6A), còn trợ lý nhỏ phác giá trị thử trước khi bản chính thức được tính (6B). Bảng 890 B/token là giá niêm yết khai báo, không phải hóa đơn đo đạc.
2Luồng
Cách đọc hình 4 cột: bắt đầu ở 1A dưới đáy Cột 1 đi lên 1B → 2A; sang Cột 2 đi từ 3A → 3B → 3C để cấp KV và chỉ mục cho 4A ở nửa trên Cột 3 (nối hai chiều Store/Load với trụ bộ nhớ HBM 6A 890 B/tok ở nửa dưới Cột 3); sau đó sang Cột 4 từ mạng chuyên gia 5A ở dưới đi lên đầu ra 6B (Logits + DSpark). Mọi số liệu bên dưới lấy nguyên văn từ deepseek-v41-flash.py (seed 41).
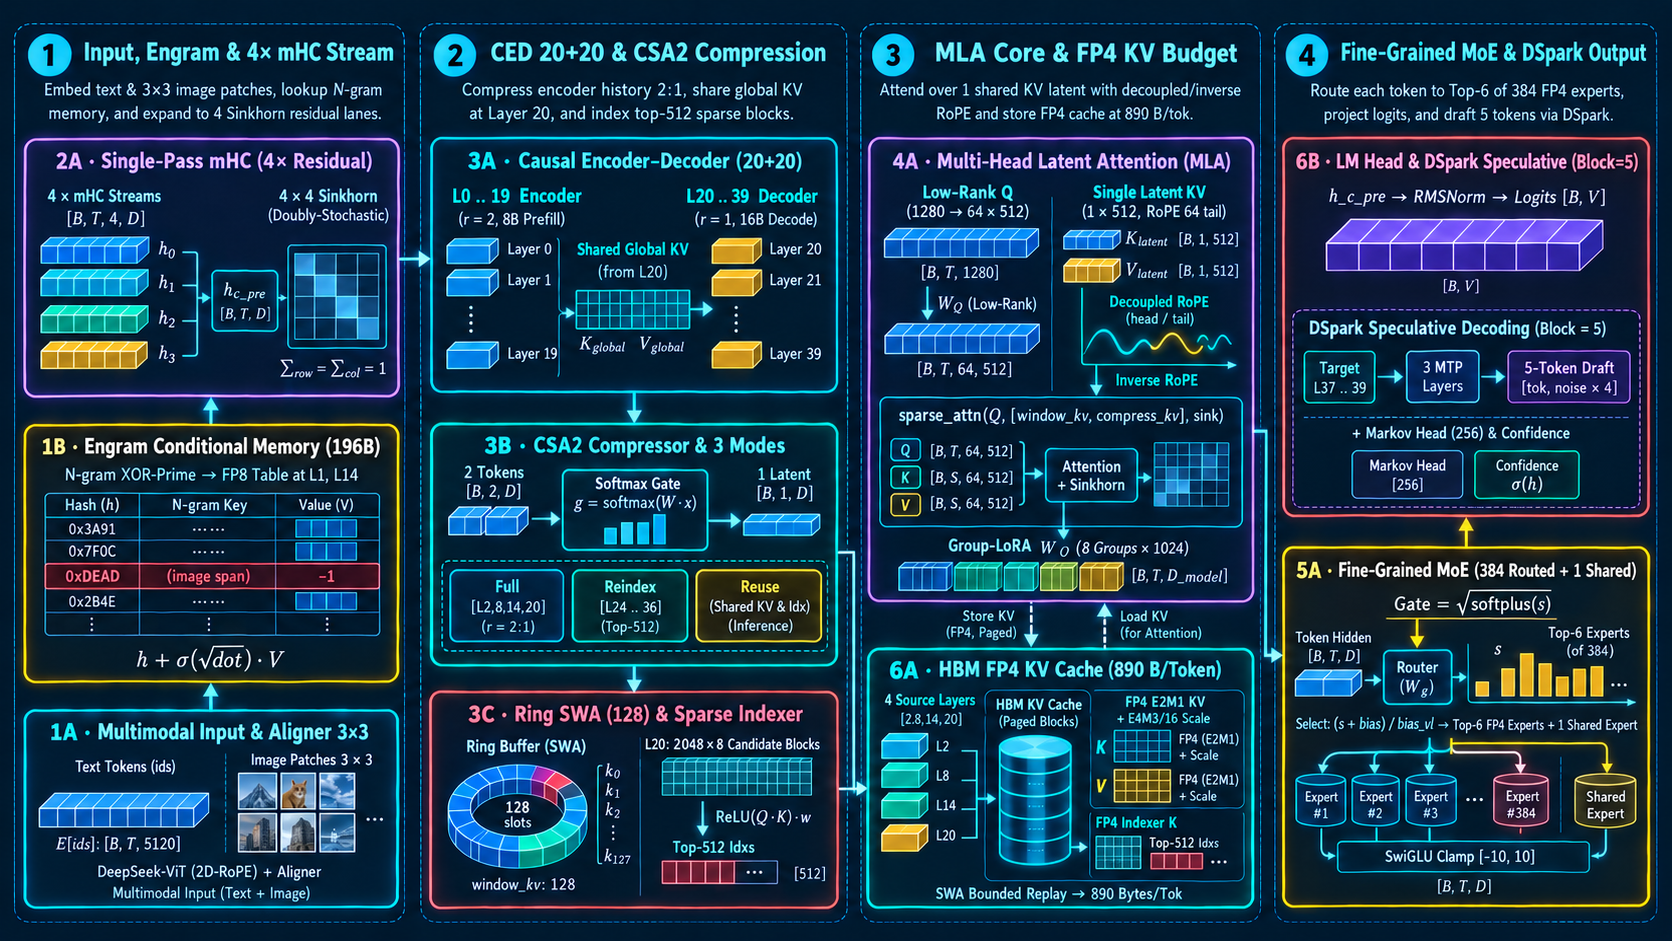
E[ids]: [B, T, 5120] · Image Patches 3×3 → DeepSeek-ViT (2D-RoPE) + Aligner → [B, N_img, 5120]1A · Multimodal Input & Aligner 3×3
Điểm xuất phát ở đáy Cột 1: nhúng token chữ E[ids] và gộp mỗi ô 3×3 patch ảnh từ DeepSeek-ViT (2D-RoPE) phủ đè vào vị trí ảnh.
Bắt đầu đọc sơ đồ từ góc dưới bên trái (1A): các token văn bản được tra bảng E[ids] thành khối vector [B, T, 5120] (ở lab là [4, 8]). Nếu đầu vào có ảnh, DeepSeek-ViT (32 lớp, xoay vị trí 2D-RoPE) mã hóa các patch rồi Aligner gộp mỗi cụm 3×3 patch thành 1 vector (giảm 9 lần số token ảnh) và ghi đè trực tiếp lên span <|deepseek_image|> trước khi đẩy luồng ẩn đi lên 1B.
- 1A–1B · Đầu vào đa phương thức và bộ nhớ Engram
Nhúng token chữ và phủ đè vector gộp ảnh 3×3 tại vị trí 1; băm n-gram XOR-prime bị chặn khi chạm DEAD.
- 2A · mHC một lượt — 4 làn residual
Mở rộng trạng thái thành 4 làn, trộn bằng ma trận Sinkhorn 4×4 chuẩn hóa kép, gộp hc_pre làm đầu vào lớp.
- 3A–3C · CED, Compressor r và Indexer phân cấp
Chia vai trò lớp nguồn (L1, L3) và lớp dùng lại (L2, L4); gộp 2 token thành 1 latent; chọn tối đa một latent bằng relu(q·k)×w.
- 4A · MLA: Q low-rank, K/V một head
Chiếu Q hạng 4, K/V một head chỉ xoay RoPE nửa cuối, attention sink, inverse RoPE và W_O nhóm.
- 5A · MoE fine-grained tách vai trò chọn và nhân
Top-2 chuyên gia theo scores + bias (có bias_vl), trọng số nhân từ sqrt(softplus) thô, SwiGLU có clamp.
- 6A–6B · Ngân sách KV và dự đoán cuối + DSpark
Cộng dồn đơn giá FP4 thành 890 B/token và so với GQA/MHA; gộp logits từ 4 làn, vẽ 3 token nháp bằng MarkovHead.
Mã Mermaid
flowchart TD
  step1["1A–1B · Đầu vào đa phương thức và bộ nhớ Engram"]
  step2["2A · mHC một lượt — 4 làn residual"]
  step3["3A–3C · CED, Compressor r và Indexer phân cấp"]
  step4["4A · MLA: Q low-rank, K/V một head"]
  step5["5A · MoE fine-grained tách vai trò chọn và nhân"]
  step6["6A–6B · Ngân sách KV và dự đoán cuối + DSpark"]
  step1 --> step2
  step2 --> step3
  step3 --> step4
  step4 --> step5
step5 --> step63Giải pháp
Bài toán cần giải quyết: sau khi học từng cơ chế rời, bạn cần chứng minh chúng ghép được thành một pipeline có thứ tự và vẫn giữ tính nhân quả khi token được xử lý lần lượt. Đầu vào là một prompt đa phương thức nhỏ, mọi tensor in thẳng ra màn hình; mỗi mã khối dạy một cặp phép toán và dãy số bạn đọc được ngay.
Tiến trình theo phụ thuộc số học (không theo cột vẽ của sơ đồ): 1A chuẩn bị nhúng và phủ đè ảnh; 1B cộng vào hc_pre của L1 một vector n-gram khi cặp token không chạm ảnh; 2A nâng trạng thái thành 4 làn rồi gộp lại. Ở đây lanes in shape (4, 4, 8) = 4 làn × 4 token × 8 chiều, còn ma trận comb sau Sinkhorn có tổng mỗi hàng và mỗi cột bằng 1.000000 — tính đơn vị song song của phép trộn.
Khối attention chia vai theo nguồn: L0 chỉ chạy SWA 2 slot; L1 giữ Compressor như bài CSA2 và phát latent khi cặp đủ (prefill phát tại end 1 và 3; decode lẻ chờ rồi phát tại end 5); L2 và L4 đọc lại mảng của nguồn nên không phải tính lại K/V cũ; L3 lưu Global KV dùng chung cho decoder theo bài CED. Indexer chọn tối đa một latent mỗi head bằng relu(q·k)/√d × w, trong khi slot ring 2 vị trí cung cấp cửa sổ gần chính xác.
MLA giảm chi phí KV bằng cách gom hai Q head về một bộ K/V một head, chỉ xoay RoPE trên hai chiều cuối và xoay ngược đầu ra trước W_O nhóm (mỗi group 4 → 3, ghép 6 → 8) như bài MLA. attention sink thêm một cột điểm cho mỗi hàng: ở mẫu pos 3 phần trọng số rơi vào sink bằng 0.076; bỏ nó đi thì các phân phối dễ bị lệch về token đầu tiên khi điểm Q·K lớn.
Kiểm soát chất lượng số trước khi nói về tốc độ: sai lệch Sinkhorn 2.22e-16 (ngưỡng 1e-6); đổi token cuối prompt khiến ba hàng logits đầu lệch đúng 0.00e+00 còn hàng bị đổi lệch 2.33e-02; decode trên cache khớp tính lại toàn chuỗi 6 token với 0.00e+00 (ngưỡng 1e-9). Ba kết quả này in trong phần [KIỂM TRA & THỬ NGHIỆM] và là bằng chứng CƠ CHẾ, không phải bằng chứng hiểu ngôn ngữ.
Giới hạn: lab chưa huấn luyện, trọng số chỉ là ngẫu nhiên có seed 41; argmax bốn hàng cùng chọn cột 6 (6, 6, 6, 6) là dấu hiệu rõ nhất để bạn tự kết luận điều đó. Ngân sách 890 B/token ở 6A là tổng lý thuyết của bảng đơn giá khai báo (FP4 E2M1 cho latent, FP8 E4M3 cho rope tail), còn tương quan 281× so GQA và 4492× so MHA chỉ đặt ra bậc độ lớn. Không dùng lab này để luận tốc độ GPU hay chất lượng văn bản thực.
4Profiling
- Kiểm tra cấu trúc và kích thước tensor trước khi đo
Bước đầu đọc shape in ra và đối chiếu với khai báo: X0 (4, 8) sau 1A; lanes (4, 4, 8) và hc_pre (4, 8) ở 2A; logits (4, 8) ở 6B; cache L1 sau decode gồm 3 latent hoặc cache L3 gồm 6 latent. Shape sai nghĩa là có phép ghép head hoặc phép chiếu nào sai — sửa cấu hình chứ không giải thích số liệu giữa chừng.
- Đúng trước, nhanh sau: Sinkhorn và tính nhân quả
Hai kiểm chứng (1) và (2) của lab là mốc đúng: comb 4×4 có sai lệch hàng/cột tối đa 2.22e-16, còn test [1, 2, 3, 5] giữ nguyên ba hàng logits đầu. Điều kiện: cùng seed 41, cùng cấu hình, thay đổi đúng một vị trí cuối; đo bằng sai số tuyệt đối trên từng hàng logits, không đo thời gian.
- Đối chiếu decode streaming với tính lại toàn chuỗi
Kiểm chứng (4) chạy cả chuỗi [1, 2, 3, 4, 5, 2] từ đầu trên trạng thái mới rồi so từng hàng logits với bước decode tương ứng: lệch tối đa 0.00e+00 (ngưỡng 1e-9). Nếu lệch vượt ngưỡng, thứ tự cập nhật cache đã sai: sửa quy ước stream trước khi bàn tới tốc độ.
- Giới hạn của mọi phép đo trong lab
Tất cả số đo là phép đối chiếu số học trên mảng NumPy rất nhỏ: không đo thời gian, không chạy checkpoint thật. Vector hoá prefill theo batch, đơn giá FP4 thật trên phần cứng và độ chính xác giữa PyTorch/Triton kernel với NumPy reference đều còn là bài học riêng; lab chỉ so khớp CƠ CHẾ đã khai báo ở các bài kiến trúc.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Đọc từng khối output 1A–6B với số thật
Chạy lab ở tab Lab (hoặc lệnh python3 public/labs/deepseek-v4-1-flash/deepseek-v41-flash.py). Trước khi chạy, dự đoán shape X0: output in (4, 8). Vị trí ảnh in vector gộp [0.131, 0.310, -0.647, -0.780, 0.631, -0.089, -0.859, -0.268] thay cho dòng E[1] = [-0.475, -0.457, ...] — aligner phủ đè chứ không cộng thêm. Sang 3B, đọc hai dòng liên tiếp: pos 0 lẻ (1) buffer kv_state, trả None; rồi pos 1 đủ 2 token (0, 1) phát latent end=1. Khối đo bằng số token chưa gộp, không phải số vị trí đã qua lớp. Câu hỏi tự kiểm tra: nếu prompt có 5 token thì prefill phát mấy latent? Chia đôi 5 lấy phần nguyên là 2 latent rồi bộ đệm còn 1.
Cùng một vị trí, hai kênh thông tin ở 3C
Tại prefill pos 3, attention head 0 nhìn các nguồn xếp thứ tự [latent end 1, ring pos 1, ring pos 2, token pos 3]: vị trí 1 xuất hiện hai lần, một lần qua latent nén, một lần qua ring thô. Trọng số tương ứng [0.206, 0.230, 0.235, 0.253], còn sink chiếm 0.076. Đây là đặc điểm của attention phân cấp: kênh nén và kênh cục bộ cùng mở, không phải kênh nào thay thế kênh nào. Nói thêm: ring giữ đúng 2 slot (pos 2, 3) vì WINDOW_SIZE = 2.
Vì sao argmax chọn bằng số chứ không phải hiểu ngôn ngữ
Lượt prefill in argmax 6, 6, 6, 6 cho cả bốn vị trí; DSpark vẽ token nháp 2 với confidence 0.167, token 1 với 0.234, token 6 với 0.173. Trọng số chưa học nên argmax chỉ đổ về cùng một cột, và confidence nháp chỉ là xác suất của phân phối draft trước bước verify bằng forward thật của mô hình lớn. Câu hỏi tự kiểm tra: muốn đọc argmax như một dự đoán có nghĩa thì còn thiếu điều kiện nào?
6Thuật ngữ
- Prefill và decode
- Prefill xử lý cả prompt [1, 2, 3, 4] một lượt; decode đưa từng token mới (5, rồi 2) vào mạng tại start_pos 4 và 5, dùng lại cache đã ghi.
- Latent nén
- Vector K/V nhỏ gộp trung bình r token liền nhau trong Compressor. Một latent (4,) đứng thay cho nhiều vector gốc (HEAD_DIM,) ở attention.
- Lớp nguồn KV
- Lớp duy nhất có quyền ghi cache (L1 và L3 trong lab). L2 dùng lại cache của L1, L4 dùng lại của L3, không tính lại K/V của token cũ.
- DEAD = -1
- Mã che trên bản đồ token nén: vị trí ảnh và cặp n-gram bắt qua ảnh bị vô hiệu hóa, nên băm Engram và khối nén không nhảy qua vùng đa phương thức.
- attn_sink
- Một cột điểm thêm vào mỗi hàng softmax; phần trọng số rơi vào sink (ví dụ 0.076 ở mẫu pos 3) không được gom về token nào, giúp phân phối không bị ép về token đầu tiên.
- Cổng sqrt(softplus)
- Điểm nhân của MoE: gate = căn bậc hai của softplus(scores). Chuyên gia được chọn theo scores + bias nhưng trọng số nhân lấy từ gate thô.
- bias_vl
- Bias cộng thêm về phía các chuyên gia xử lý phương thức ảnh, chỉ áp dụng tại vị trí ảnh (mã 5A). Nó đổi chuyên gia được CHỌN, không đổi giá trị cổng gate.
- Confidence nháp DSpark
- Xác suất của token nháp vừa vẽ từ phân phối draft; chưa qua bước verify bằng forward thật của mô hình lớn nên chỉ mang ý nghĩa minh họa.
Glossary (4)
- X0 (4, 8)
- Bốn vị trí × tám chiều vector sau bước nhúng; token ảnh đã bị phủ đè tại đây, mọi mã khối sau đọc đúng bản này.
- hc_pre (4, 8)
- Kết quả gộp 4 làn residual về (T, DIM) trước khi lớp bắt đầu tính; đóng vai trò hidden state của lớp.
- comb 4×4
- Ma trận trộn các làn mHC sau Sinkhorn; tổng mỗi hàng và mỗi cột bằng 1.
- kv_state
- Bộ đệm các token chưa đủ thành một khối nén; prefill kết thúc với 0, decode lẻ để 1.
7Bài liên quan
8Nguồn
9Bài lab
Chạy thử toàn bộ kiến trúc DeepSeek-V4.1-Flash (1A → 6B) bằng NumPy
Thực hành NumPy · giải phẫu toàn trình DeepSeek-V4.1-Flash (1A–6B)Đây là lab tổng hợp: một script duy nhất chạy toàn trình 1A → 6B của DeepSeek-V4.1-Flash ở kích thước thu nhỏ và in lời giải thích tiếng Việt trước mỗi bảng số. Bạn không cần nhớ công thức trước khi chạy; hãy đọc mục Quan sát, xem số liệu rồi thử nói lại Kết luận của từng khối.
Bạn sẽ học được gì?
Sau bài này, bạn cần tự giải thích được năm việc: token ảnh được biến thành vector thế nào và vị trí nào bị che; hc_pre của mHC được tạo ra và dùng bởi ai; tại sao KV chỉ nằm ở lớp nguồn (L1, L3) nhưng L2/L4 vẫn attention được; sqrt(softplus) và bias_vl đóng vai trò gì ở cổng MoE; và con số 890 B/token cộng từ những thành phần nào.
Bạn sẽ nối được mỗi khối output với mã tương ứng trên sơ đồ Tab 1: 1A, 1B, 2A, 3A, 3B, 3C, 4A, 5A, 6A, 6B. Các số in ra là giá trị thật của pass đang chạy; đừng nhìn PASS rồi bỏ qua bảng số — hãy trước tiên dự đoán theo bài kiến trúc rồi mới so.
Đầu vào và cấu hình thu nhỏ của bài lab
DEMO_PROMPT = [1, 2, 3, 4]: bốn mã token giả lập; vị trí 1 là token ảnh ghép 3×3 (IMAGE_POS = [1]), ba vị trí còn lại là token chữ, bảng từ vựng 8 mã (0..7). Hai bước decode thêm token 5 rồi token 2 tại start_pos 4 và 5. TRY_PROMPT = [1, 2, 3, 5] chỉ dùng cho phần kiểm tra nhân quả ở cuối.
Cấu hình thu nhỏ in ngay đầu output: vocab 8, dim 8, 5 lớp với COMPRESS_RATIOS = (0, 2, 2, 1, 1); lớp nguồn KV (1, 3); cửa sổ SWA 2 slot; Indexer top-1; 2 head × 4 chiều; MoE chọn 2 trong 4 chuyên gia; Engram chỉ ở L1; DSpark trên lớp (3, 4) với khối 3 token. Weights chưa học, sinh một lần bằng seed 41 nên chạy lại cho ra cùng số.
Bảng ánh xạ 1:1 giữa Sơ đồ Kiến trúc (Tab 1) và Code Lab (Tab 2)
1A → phần embedding + Aligner: dòng ảnh 3×3 và vector phủ đè tại vị trí 1, shape đầu vào (4, 8). 1B → hàm engram_bucket và engram_contribution: map nén [1, -1, 3, 4], bucket 9 cho cặp (3, 4), cổng sigmoid × căn bậc hai có dấu.
2A → mhc_expand / mhc_collapse / MIX_COMB: shape lanes (4, 4, 8), hc_pre (4, 8), ma trận Sinkhorn 4×4 có tổng hàng/cột 1.000000. 3A → bảng vai trò 5 lớp và chủ cache (KV_SOURCE_LAYERS = (1, 3)). 3B → hàm emit_latents với r = 2: sáu dòng sự kiện prefill/decode kể trên. 3C → ring window_kv_cache 2 slot và phần Indexer relu(q·k)/√d × w.
4A → khối MLA: Q (8 → 4 → 2×4), K/V một head (4,) với RoPE hai chiều cuối, SINK, inverse RoPE, W_O nhóm 4 → 3 rồi 6 → 8. 5A → moe_block với sqrt(softplus), bias_vl tại vị trí ảnh, clamp ±10 và shared expert. 6A → bảng kv_budget_rows + so GQA/MHA. 6B → logits (4, 8) và dspark_draft với MarkovHead hạng 4.
Cách thực hiện và đọc từng khối output 1A–6B
1. Bấm Chạy (hoặc chạy script bằng python3). Đọc lượt prefill trước: 1A cho thấy vector ảnh và vector chữ; 1B cho thấy cặp (3, 4) rơi vào bucket 9 còn cặp bắt qua ảnh đều bị DEAD chặn. Đầu ra của 1B chính là hc_pre của L1 — dùng để hiểu 2A.
2. Ở 2A, so tổng mỗi hàng và mỗi cột của comb: cả hai nhóm phải bằng 1.000000. Ở 3A, đối chiếu dòng vai trò với cấu hình: r = (0, 2, 2, 1, 1) và nguồn KV (1, 3). Ở 3B, đếm sáu sự kiện Compressor: prefill phát ở end 1 và end 3, decode lẻ (end 4) chờ, decode đủ cặp phát end 5.
3. Ở 3C, đọc lựa chọn Indexer tại pos 3: head 0 chỉ có một latent hợp lệ (end 1); decode mở rộng danh sách hợp lệ tới end 1 và 3. Ở 4A, so Q trước/sau RoPE: chỉ hai chiều cuối thay đổi; weights của head 0 gồm 4 nguồn cộng một phần rơi vào sink 0.076. Ở 5A, ghi nhận pos 1 chọn chuyên gia 3 và 0 nhờ bias_vl, còn trọng số nhân [0.558, 0.442] lấy từ gate thô.
4. Ở 6A, tự cộng lại sáu dòng đơn giá (256 + 64 + 480 + 32 + 10 + 48) để thấy tổng 890 B/token. Ở 6B, đọc logits (4, 8) và ba token nháp với confidence từng token. Cuối cùng đọc [KIỂM TRA & THỬ NGHIỆM]: năm phép kiểm chứng với ngưỡng in rõ (1e-6, 1e-9).
Kết quả này chứng tỏ điều gì và giới hạn ở đâu?
Kiểm chứng (1)-(4) chứng minh cơ chế: Sinkhorn kép chính xác 2.22e-16; tính nhân quả giữ nguyên ba hàng logits đầu khi đổi token cuối (0.00e+00) và thay đổi đúng hàng cuối (2.33e-02); L2/L4 dùng đúng mảng KV của nguồn; decode trên cache khớp tính lại toàn chuỗi 0.00e+00. Các mốc này khớp những gì các bài kiến trúc đã mô tả, giờ đo được bằng số.
Giới hạn: weights chưa học nên argmax và confidence chỉ minh hoạ; ngân sách 890 B/token là tổng đơn giá khai báo, chưa gồm chi phí truy cập và độ chính xác FP4 thật trên phần cứng. Lab không thay cho benchmark production và không chứng minh mô hình hiểu ngôn ngữ.
Kết quả mong đợiOutput dài ~180 dòng chia các khối [1A]..[6B] và [KIỂM TRA & THỬ NGHIỆM]. Mốc đọc nhanh: shape đầu vào (4, 8); comb tổng hàng/cột 1.000000; prefill phát latent end 1 và 3, decode lẻ chờ (None) rồi phát end 5; logits (4, 8); tổng ngân sách KV 890 B; năm kết luận PASS.
Bài tập 1 · Đổi token cuối trong TRY_PROMPT để kiểm tra tính nhân quả và băm Engram
Trước khi chạy, dự đoán: đổi token cuối của prompt (4 thành 5, rồi bằng cách sửa TRY_PROMPT thành [1, 2, 3, 6]) ảnh hưởng tới những hàng logits nào, và phần Engram của vị trí nào đổi? Chạy lại lab và đọc mục [KIỂM TRA & THỬ NGHIỆM], kiểm chứng (2).
Đối chiếu sau khi tự trả lời
Ba hàng logits đầu lệch 0.00e+00 (dưới ngưỡng 1e-9), hàng cuối được phép thay đổi (đo được 2.33e-02). Vị trí 0–2 không đọc được token tại pos 3: mask nhân quả chặn, các latent hợp lệ có end 1 và 3 chỉ tạo từ token cũ, ring là K/V của token trước đó. Engram chỉ thêm vector vào hc_pre của pos 3 (cặp (3, 6) rơi vào bucket 11, đổi theo token vì phép XOR nasho chi tiết này), nên các vị trí trước vẫn đứng yên. Đổi token đầu (pos 0) thì toàn bộ các hàng đều có thể đổi vì mọi vị trí được phép đọc nó.
Bài tập 2 · Kiểm tra ma trận trộn Sinkhorn 4×4 ở bước 2A
Dự đoán điều gì xảy ra với tổng hàng/cột của comb nếu HC_SINKHORN_ITERS giảm từ 20 xuống 1? Sửa hằng số đó trong file lab rồi chạy lại; đọc khối 2A và kiểm chứng (1).
Đối chiếu sau khi tự trả lời
Sau một vòng đi theo hàng rồi theo cột, comb chưa khép kín: lab đo được sai lệch hàng/cột tối đa 4.70e-02 — vẫn vượt ngưỡng 1e-6 nên kiểm chứng (1) chỉ PASS với đủ số vòng (20 vòng cho 2.22e-16). Điều này giải thích vì sao phép trộn mHC cần vòng lặp kép: một lần đi theo hàng đưa tổng hàng về 1 nhưng làm lệch tổng cột, và ngược lại.
Bài tập 3 · Vì sao bước Decode lẻ chưa sinh thêm vector nén ở 3B?
Chạy lab và ở 3B so sánh hai dòng decode: pos 4 in lẻ (1) buffer kv_state, trả None, còn pos 5 in đủ cặp (4, 5) phát latent end=5. Trước khi đọc giải thích, hãy tự trả lời: token nào được nén trong latent mới, và vì sao pos 4 phải chờ?
Đối chiếu sau khi tự trả lời
Compressor gộp 2 token làm 1 latent (r = 2). Sau prefill, 4 token đã về đúng 2 latent nên bộ đệm về 0; token tại pos 4 chưa có bạn để thành cặp nên bộ đệm chỉ còn 1 token — lẻ, trả None. Bước pos 5 hoàn thành cặp (4, 5) và phát latent thứ ba có end = 5, tức nén đúng pos 4 và 5. Đọc thêm ba dòng sự kiện trong output là đủ thấy bộ đệm kv_state giữ token lẻ cho tới khi đủ cặp.
Bài tập 4 · Tách bias chọn chuyên gia khỏi trọng số nhân ở cổng MoE 5A
Dự đoán: nếu BIAS_VL đặt về 0, chuyên gia nào được chọn tại pos 1 (token ảnh) khác gì so với lab chạy mặc định (chuyên gia 3 và 0, trọng số [0.558, 0.442])? Ghi lại dự đoán, sửa dòng BIAS_VL thành zeros rồi chạy lại và so khối 5A.
Đối chiếu sau khi tự trả lời
Chuyên gia được chọn đổi thành 3 và 1 với trọng số [0.639, 0.361] (đã xác minh bằng chạy lại: scores pos 1 lớp 1 đổi thành [-1.942, -0.033, -1.289, 1.987] vì bias_vl tác động đã đổi luồng từ lớp 0 của chính vị trí đó). Bài học: bias_vl đảo kết quả CHỌN chuyên gia, còn cổng sqrt(softplus) chỉ tham gia TRỌNG SỐ nhân; tách hai vai trò này giúp đọc code MoE production không nhầm giữa router dùng để chọn và gate dùng để nhân.