3B · Compressed Sparse Attention 2
3B · Compressed Sparse Attention 2 · Nén gộp token và 3 chế độ Full, Reindex, Reuse
CSA2 nén lịch sử theo trục token: Compressor gộp r=2 token bằng softmax(score) FP32, token chưa đủ cặp đợi trong kv_state/score_state, SharedAttentionRuntime chia sẻ state giữa Full, Reindex, Reuse.
1Định nghĩa
Compressed Sparse Attention 2 (CSA2) là cơ chế nén lịch sử theo trục token của lớp 3B: thay vì lưu một entry KV cho từng token quá khứ, các cụm token liền kề được gộp thành ít entry hơn. Compressor tại các lớp 2, 8, 14 gom KV latent và score của hai token thành một entry (r=2); lớp 20 giữ r=1 vì nó tạo global KV cho decoder. Bài toán CSA2 giải quyết là cân đối ngân sách KV cache với khả năng đọc lại ngữ cảnh dài; đây là phiên bản nén theo trục token, khác nén theo trục feature như MLA.
Về cơ chế, mỗi token có KV latent 512 chiều và một score; softmax(score) tính trong FP32 tạo trọng số gộp, entry có thể lưu FP4 như trong bài ngân sách KV 890 bytes/token. Khi decode, token chưa đủ cặp được giữ trong kv_state và score_state, đợi token sau rồi mới gộp; các buffer này chỉ sống trong lượt decode, không thành cache lâu dài. Ba chế độ Full (lớp [2, 8, 14, 20]), Reindex ([24, 28, 32, 36]) và Reuse chia sẻ phần tính qua SharedAttentionRuntime: các lớp Full tính và lưu compress_kv, index_k, topk_idxs; các lớp khác đọc lại. Bộ indexer và cửa sổ SWA là bước tiếp theo đọc các entry này; để thấy từng bước, theo 3B của Bài Lab tổng hợp DeepSeek-V4.1-Flash.
Ví dụ đời thường: CSA2 giống quầy gói thư theo cặp: mỗi hai lá thư gần nhau được gói chung thành một phong bì, và cách gói theo con dấu độ quan trọng (score) để xem lá thư nào cần nhiều dung lượng hơn. Khi chỉ có một lá thư cuối chiều (chưa đủ cặp), quầy giữ tạm trong khay riêng và gói chính thức buổi sáng khi lá thứ hai đến. Giới hạn của phép so: trọng số gộp không cố định 50/50 mà học theo softmax(score); score là con số học được, không phải cảm nhận quan trọng của người.
2Luồng
Cách đọc hình (Cột 2, khối 3B ở giữa): gộp mỗi cặp 2 token liên tiếp qua cổng softmax g = softmax(W·x) thành 1 latent nén (bước decode lẻ giữ tạm trong kv_state) và phân phối theo 3 chế độ Full [L2,8,14,20], Reindex [L24..36], Reuse; xem bước [3B] trong Bài Lab tổng hợp ở Tab 02.
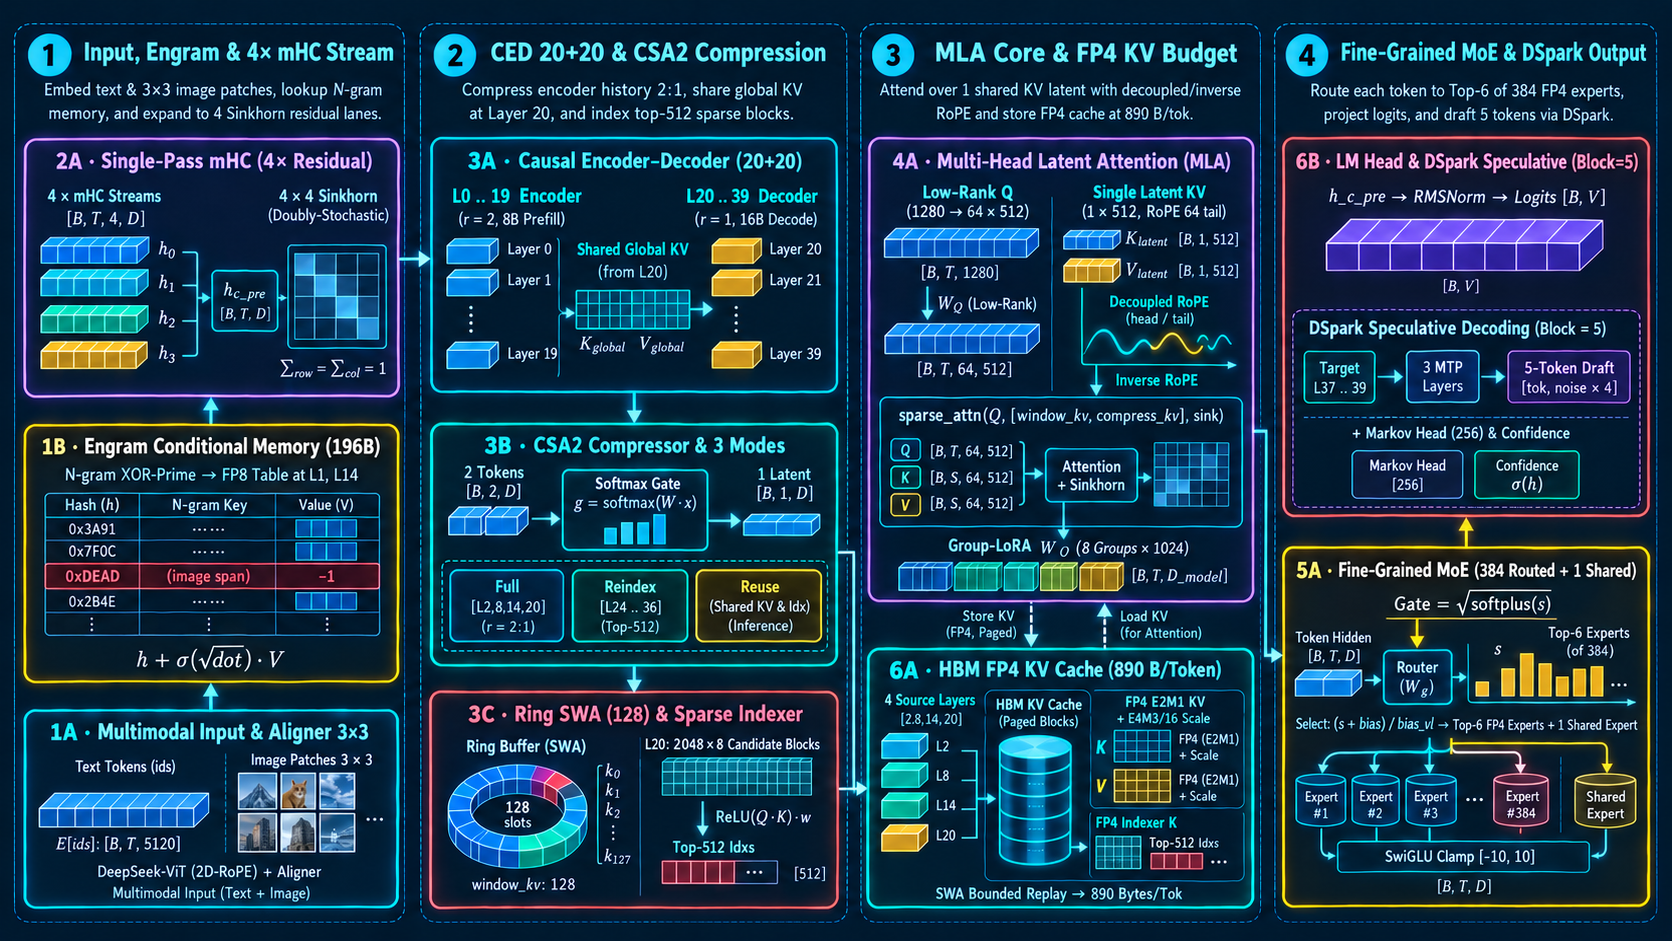
2 Tokens [B, 2, D] → Softmax Gate g = softmax(W·x) → 1 Latent [B, 1, D] · Full [L2,8,14,20] / Reindex [L24..36] / Reuse3B · CSA2 Compressor & 3 Modes
Giữa Cột 2: gộp mỗi cặp 2 token thành 1 vector latent bằng cổng softmax và phân phối qua 3 chế độ tĩnh Full, Reindex, Reuse.
Ở giữa Cột 2, khối Compressor gom mỗi cặp 2 token liên tiếp [B, 2, D] qua cổng trọng số g = softmax(W·x) thành 1 vector nén [B, 1, D] (nếu đang decode ở bước lẻ chưa đủ cặp thì giữ tạm trong kv_state và trả về None). Chỉ 4 lớp nguồn [2, 8, 14, 20] chạy chế độ Full (tạo KV + tạo chỉ mục); các lớp [24, 28, 32, 36] chạy Reindex (dùng lại KV, tính lại Top-512), còn 32 lớp còn lại chạy Reuse (dùng lại cả KV lẫn chỉ mục).
- 3B · Nén gộp theo cặp
KV latent 512 chiều của mỗi token được gộp theo cặp bằng softmax(score) với FP32.
- 3B · Ba chế độ attention
Full tại lớp [2, 8, 14, 20] tính và lưu; Reindex và Reuse đọc lại tensor dùng chung.
- 3B · Bàn giao cho indexer và attention
Entry nén trở thành đầu vào của indexer và lớp MLA; các bước decode đọc cache.
Mã Mermaid
flowchart TD
  step1["3B · Nén gộp theo cặp"]
  step2["3B · Ba chế độ attention"]
  step3["3B · Bàn giao cho indexer và attention"]
  step1 --> step2
step2 --> step33Giải pháp
Bài toán cần giải: lưu KV từng token khiến cache tăng nhanh theo ngữ cảnh; nén gộp token thành ít entry nhưng vẫn đọc được khi cần. CSA2 chọn gộp theo cặp (r=2) với trọng số theo score. Sau bài này, bạn cần tự kể: cách gộp hai token bằng softmax(score) FP32, cách hoạt động khi số token lẻ, và ba chế độ Full / Reindex / Reuse chia sẻ phần tính.
Compressor gộp theo cặp: mỗi token có KV latent 512 chiều và một score. Trọng số gộp là softmax([s0, s1]) hai chiều, dùng FP32 vì phép softmax ở dtype nhỏ dễ mất độ chính xác. KV gộp = w0 × KV0 + w1 × KV1; score gộp = w0 × s0 + w1 × s1. Kể cho hai trường hợp: s0 = s1 cho trọng số 0.5/0.5, còn khi một score nổi bật mạnh thì gộp nghiêng về token đó.
Buffer khi decode r=2: trong prefill, chuỗi chẵn dễ gộp mọi cặp; chuỗi lẻ còn một token chưa đủ. kv_state giữ KV của token lẻ, score_state giữ score; đến khi token kế đến, buffer được gộp thành entry và rỗng. Điều này quan trọng vì: người học dễ nhầm tính số entry nếu đổi parity chuỗi; buffers không nằm trong cache lâu dài.
Ba chế độ Full, Reindex, Reuse: các lớp 2, 8, 14, 20 là Full, nghĩa là tự tính và lưu toàn bộ compress_kv, index_k, topk_idxs; các lớp 24, 28, 32, 36 là Reindex: không tính lại KV nén, chỉ tính lại score vì index trên các candidate block ở phạm vi nhỏ; lớp Reuse đọc lại topk_idxs mà không tính lại index K. Các chế độ này cố định theo kiến trúc, không có tùy chọn runtime.
SharedAttentionRuntime: các lớp Full tính sẵn các tensor dùng chung; các lớp Reindex và Reuse đọc lại và chỉ tính phần riêng. Điều này tiết kiệm đáng kể phần tính, đặc biệt khi lớp Reuse chỉ đọc topk_idxs rồi lọc KV. Chú ý không dùng với checkpoint khác: các tensor chia sẻ chỉ đúng cho cấu hình lớp được đào tạo cùng.
Giới hạn và nơi quan sát: CSA2 đáng chú ý tại các lớp nén (2, 8, 14) và lớp 20 tạo global KV; cảm nhận tốt khi đọc bài ngân sách KV 890 bytes/token. Muốn thấy mọi bước gọi runtime, mở bước 3B của Bài Lab tổng hợp DeepSeek-V4.1-Flash, rồi tiếp bài indexer đọc các entry này.
4Profiling
- Parity pooled KV trong ví dụ nhỏ
Kiểm tra tính đúng trước: với KV0 = [1, 0], KV1 = [0, 2], scores [0, 2], tính tay pooled = [0.119203, 1.761594] (xem Bước 2); so với runtime; sai khác trong ngưỡng đã chọn (ví dụ 1e-6 cho FP32). Chú ý: nếu runtime softmax ở FP32 nhưng lưu FP4 thì sai khác lớn hơn; kiểm tra quanh ngưỡng với ngưỡng riêng cho mỗi dtype.
- Trạng thái buffer với chuỗi lẻ
Đo với chuỗi 3 token: sau token 3, kv_state/score_state giữ token 3; thêm token 4 thì gộp và buffer rỗng. Chạy từng chuỗi riêng để kiểm buffer không lẫn chuỗi.
- Byte đọc trong decode theo chế độ
Đo byte đọc của compress_kv khi decode từng lớp: Full đọc toàn bộ entry, Reindex chỉ đọc các entry trong candidate block (max 2048 × 8 = 16.384 vị trí), Reuse chỉ đọc topk_idxs. So với lớp Full để biết tiết kiệm thực tế; chưa đo thì không kết luận.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Bước 1 · Dự đoán trọng số gộp
Input: hai token với KV0 = [1, 0], KV1 = [0, 2], scores s0 = 0, s1 = 2. Trước khi tính, hãy dự đoán: trọng số gộp phần nào lớn hơn phần nào? Cách quan sát: softmax([0, 2]) như được mô tả; đáp án ở Bước 2; có thể kiểm cả trọng số và pooled trong bước 3B của [bài lab tổng hợp](/courses/deepseek-v4-1-flash/dsv41-lab/dsv41-end-to-end-lab/).
Bước 2 · Tính softmax(score) FP32 và pooled KV
Tính: e^0 = 1, e^2 = 7.389056, tổng = 8.389056; trọng số = [0.119203, 0.880797]. Pooled KV = 0.119203 × [1, 0] + 0.880797 × [0, 2] = [0.119203, 1.761594]. Tự kiểm tra: nếu cả hai score = 0, softmax cho [0.5, 0.5], pooled = [0.5, 1.0]; nếu s0 = 2, s1 = 0 thì trọng số là [0.880797, 0.119203], pooled = [0.880797, 0.238406]. Các con số ở đây là tính tay; để chạy runtime thật, dùng bước 3B của [bài lab tổng hợp](/courses/deepseek-v4-1-flash/dsv41-lab/dsv41-end-to-end-lab/).
Tự kiểm tra · Buffer chưa đủ cặp khi chuỗi lẻ
Giả sử chuỗi 3 token vào Compressor lớp 2 (r=2): token 1 và token 2 tạo 1 entry nén; token 3 chưa đủ cặp nằm trong kv_state và score_state; khi token 4 đến, nó gộp với token 3 thành entry thứ 2. Tự kiểm tra: trước token 4, lớp 2 có 1 entry nén và buffer có 1 token; đối chiếu số thực trong bước 3B. Giới hạn: buffer chỉ chứa token chưa đủ cặp, không giữ nhiều hơn r - 1 phần tử; nếu buffer có nhiều hơn, kiểm tra reset giữa các chuỗi.
6Thuật ngữ
- Compress ratio r
- Số token gộp vào một entry nén; với r=2, một entry đại diện cho hai token.
- Compressor
- Module gộp: đọc KV latent và score từng token, dùng softmax(score) FP32 tạo trọng số, xuất entry nén và score gộp.
- kv_state / score_state
- Hai buffer tạm giữ KV và score của token chưa đủ cặp trong decode, đợi token sau để gộp.
- SharedAttentionRuntime
- Runtime dùng chung: các lớp Full tính và lưu compress_kv, index_k, topk_idxs; các lớp Reindex/Reuse đọc lại các tensor này.
Glossary (4)
- Entry nén
- Một dòng dữ liệu KV đại diện cho r token, lưu trong compress_kv.
- Score
- Điểm số học được gắn mỗi token trước khi gộp; softmax(score) tạo trọng số gộp.
- Trục token & trục feature
- Nén theo trục token là gộp nhiều token thành ít entry; nén theo trục feature là giảm số chiều vector như MLA.
- FP32
- Kiểu số 32 bit dùng cho phép softmax gộp, giữ ổn định số học.