4A · MLA & Grouped Output
4A · Multi-head Latent Attention · latent K/V dùng chung, RoPE nửa sau và W_O nhóm
MLA nén K/V theo trục feature: mỗi entry nén chỉ giữ latent 512 chiều và phần xoay RoPE nửa sau, mọi head Q đọc chung latent rồi chiếu đầu ra bằng W_O nhóm, nên cache không tăng theo số head.
1Định nghĩa
Multi-head Latent Attention (MLA) là attention của khối 4A: thay vì giữ K và V riêng cho từng head, mô hình nén K/V thành một latent 512 chiều duy nhất cho mỗi entry, kèm phần xoay vị trí RoPE trên nửa cuối chiều; không head nào giữ bản K/V riêng, mọi head đều đọc chung latent. Kiến trúc là nén trục feature đi kèm nén trục token của bài CSA2: một chiều giảm số entry trong cache, một chiều giảm số byte mỗi entry.
Về cơ chế, đầu vào của 4A là compress_kv (latent 512 chiều) do các lớp Full của CSA2 ghi; Q tạo từ chiếu hạng thấp riêng, còn RoPE chỉ xoay nửa cuối chiều latent, và sau attention đầu ra được xoay ngược (inverse RoPE) rồi đi qua W_O nhóm: mỗi nhóm head có phép chiếu riêng nhỏ, ghép lại thành chiều ẩn. Một entry nén chiếm 288 B cho K/V như cộng trong bài ngân sách KV FP4; số head Q tăng không làm cache tăng vì latent dùng chung. Để thấy shape từng bước và trọng số head, theo bước 4A của Bài Lab tổng hợp DeepSeek-V4.1-Flash.
Ví dụ đời thường: MLA giống phòng họp dùng một bản biên bản chung thay cho mỗi người tự ghi một bản: số người dự họp tăng thì số bản chép riêng không tăng, ai cần lại tra bản chung; bản biên bản viết tắt (nén feature) nên nhỏ hơn bản ghi riêng của từng người. Giới hạn của phép so: biên bản chung phải đủ tốt cho mọi người dùng, và phần viết tắt làm mất thông tin, được đo bằng sai số tái dựng thay vì cảm nhận trực tiếp.
2Luồng
Cách đọc hình (Cột 3, khối 4A nửa trên): chiếu Low-Rank Q (1280 → 64×512) đối chiếu với 1 Single Latent KV (1×512, xoay Decoupled RoPE 64 chiều đuôi), chạy sparse_attn kèm sink, xoay ngược Inverse RoPE và chiếu Group-LoRA W_O (8 nhóm × 1024); xem bước [4A] trong Bài Lab tổng hợp ở Tab 02.
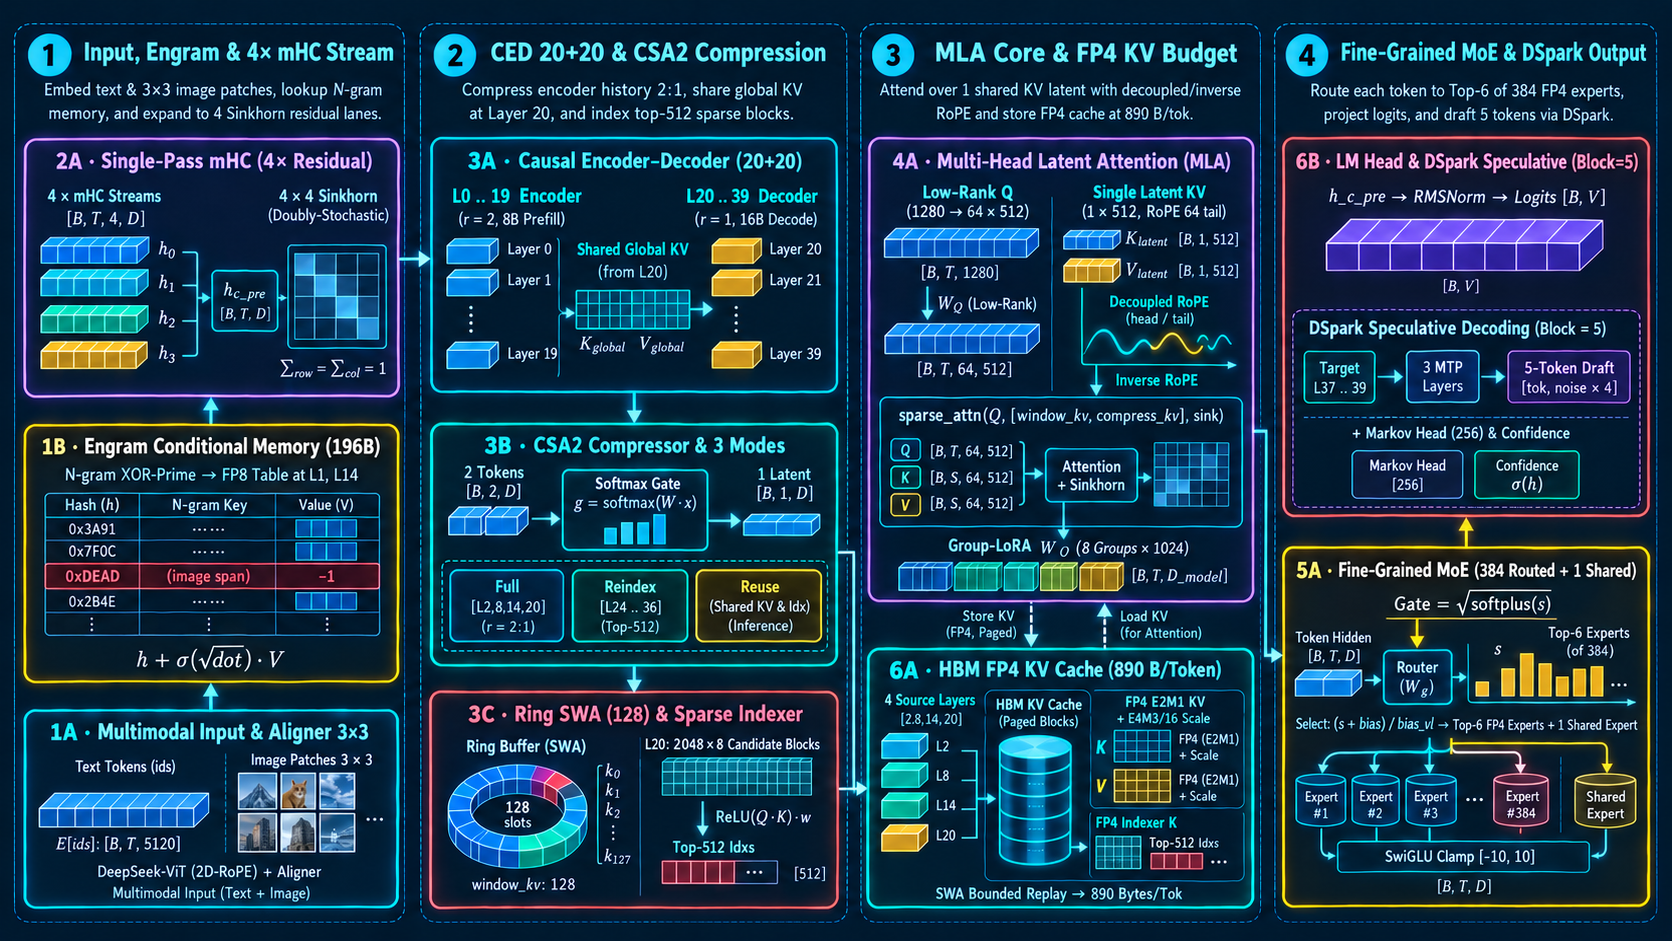
Low-Rank Q (1280 → 64×512) · Single Latent KV (1×512, RoPE 64 tail) → sparse_attn + sink → Inverse RoPE → Group-LoRA W_O (8×1024)4A · Multi-Head Latent Attention (MLA)
Nửa trên Cột 3: 64 Q head đối chiếu với 1 Latent KV 512 chiều (chỉ xoay RoPE ở 64 chiều đuôi), có attn_sink, xoay ngược RoPE và chiếu W_O theo 8 nhóm.
Ở nửa trên Cột 3, vector ẩn đi qua phép chiếu hạ chiều W_Q (Low-Rank 1280 → 64 head × 512 chiều), trong khi cả Key và Value được gom vào duy nhất 1 Latent KV [B, 1, 512] với góc quay Decoupled RoPE chỉ gắn vào 64 chiều cuối. Sau khi sparse_attn gom thông tin từ [window_kv, compress_kv] kèm cột điểm attn_sink, đầu ra được xoay ngược (Inverse RoPE) rồi chiếu qua ma trận đầu ra phân rã Group-LoRA W_O (8 nhóm × 1024) về lại [B, T, D_model].
- 4A · Nén trục feature trước, chia sẻ latent sau
Mỗi entry vào attention là latent 512 chiều đã nén; số head Q không đổi được kích thước cache.
- 4A · Nhận entry nén từ CSA2
compress_kv và index_k do các lớp Full của CSA2 ghi; lớp 4A chỉ đọc, không tính lại K/V token cũ.
- 4A · Tổng hợp vào ngân sách cache
Mỗi entry latent tiết kiệm bao nhiêu byte vào ngân sách cache tổng, được cộng cụ thể trong 6A.
Mã Mermaid
flowchart TD
  step1["4A · Nén trục feature trước, chia sẻ latent sau"]
  step2["4A · Nhận entry nén từ CSA2"]
  step3["4A · Tổng hợp vào ngân sách cache"]
  step1 --> step2
step2 --> step33Giải pháp
Bài toán cần giải: attention nhiều head thường lưu K, V cho từng head nên cache tăng theo số head; với ngữ cảnh dài, phần này chiếm phần lớn bộ nhớ. MLA giải bằng nén trục feature: một latent 512 chiều thay cho nhiều bảng K/V, nhờ đó số head không quyết định kích thước cache. Sau bài này, bạn cần tự kể được: latent 512 thay thế gì, RoPE nằm ở nửa cuối trong và inverse RoPE chi ra nơi nào, và vì sao W_O nhóm không phá luồng dữ liệu.
Nén trục feature trước, đọc sau: entry vào attention là latent 512 chiều đã nén FP4; Q tạo từ chiếu hạng thấp riêng và nhiều truy vấn Q khác nhau đọc cùng một latent; RoPE chỉ xoay nửa cuối chiều latent, nhờ phần vị trí và phần nội dung được tách. Điều này nghĩa là: đổi số head Q không đổi kích thước cache, còn đổi chiều latent mới linh hoạt đổi cache.
Inverse RoPE và W_O nhóm: sau attention, phần xoay vị trí cần được xoay ngược (inverse RoPE) trước khi vào phép chiếu đầu ra, để phần xoay vị trí không bị rót vào chiều ẩn. Đầu các head qua W_O làm theo nhóm; mỗi nhóm có ma trận chiếu riêng nhỏ, ghép lại thành chiều ẩn. Đây là lựa chọn để phép chiếu đầu ra chia cụm nhỏ, không dồn thành một ma trận một khối to.
Cách ly phép nén và phép chia sẻ: dùng chung latent cho nhiều head là phép chia sẻ; còn nén FP4 với scale phải được kiểm riêng trong bài ngân sách KV FP4, sai khác gọi là phần dequant và mỗi dtype có ngưỡng hợp lệ riêng. Ghi nhớ: chi phí nén feature nằm trong byte mỗi entry, tách bạch với chi phí nén token của CSA2 nằm trong số entry.
Giới hạn và nơi quan sát: latent 512 + RoPE nửa sau không phải là con số tùy chọn; nó ảnh hưởng trực tiếp vào tổng 890 B/token được cộng ở bài ngân sách KV FP4. Muốn thấy shape X0, latent, trọng số head và phép chiếu nhóm, mở bước 4A của Bài Lab tổng hợp DeepSeek-V4.1-Flash, rồi tiếp bài MoE fine-grained xem phần feed-forward theo sau attention.
4Profiling
- Độ chính xác latent FP4 khi đọc nhiều head
Kiểm độ chính xác trước: tính dequant từ latent FP4 với scale E4M3 theo 16 kênh, so với latent FP32 của cùng entry đo trước; sai khác dùng ngưỡng được phép của FP4, không dùng ngưỡng của FP32. Nếu vượt ngưỡng, kiểm thứ tự kênh trong scale, không vội đổi kiểu nén.
- Parity RoPE nửa sau và inverse RoPE
So vector sau áp RoPE trên nửa cuối chiều với tính tay trên vài phần tử (cos theo vị trí, sin theo phần còn lại), rồi kiểm inverse RoPE đưa về gần đúng vector trước xoay trong ngưỡng đã chọn; phần nửa đầu không được xoay, nếu thay đổi nghĩa là chỉ mục chiều áp lệch.
- Kích thước cache theo số head
Đo byte cache khi tăng hoặc giảm số head Q giữ nguyên latent 512: cache của index_k cố định, không đổi theo head. Số 288 B mỗi entry K/V dùng để xác minh dòng này; nếu khác, có phép chia sẻ bị bỏ hoặc tính lại.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Bước 1 · Dự đoán byte mỗi entry latent
Input: một entry latent 512 chiều nén FP4 (0.5 B mỗi số) và phần RoPE tail 64 chiều cũng 0.5 B mỗi số. Trước khi tính, hãy dự đoán: một entry K/V chiếm bao nhiêu byte, và có phụ thuộc số head Q không? Đáp án ở Bước 2; có thể đối chiếu bảng đơn giá trong 6A của [bài lab tổng hợp](/courses/deepseek-v4-1-flash/dsv41-lab/dsv41-end-to-end-lab/).
Bước 2 · Tính 288 byte cho K và V
Tính: 512 × 0.5 = 256 B cho latent chính; 64 × 0.5 = 32 B cho phần RoPE tail; tổng 288 B cho cả K và V của một entry, không phụ thuộc số head Q. Tự kiểm tra: nếu lưu K, V riêng cho hai head 512 chiều mỗi head, cần 2 × 2 × 512 × 0.5 = 1024 B, tức gấp hơn 3 lần; số head càng tăng, khoảng cách càng rộng còn latent vẫn 288 B.
Tự kiểm tra · Cache lớp khi tăng head
Giả sử một lớp có 1.000 entry nén và vẫn latent 512 + RoPE tail 64. Tự kiểm tra: cache K/V của lớp = 1.000 × 288 = 288.000 B ≈ 282 KB; nếu cộng thêm cache index_k 68 B mỗi entry như trong [bài indexer](/courses/deepseek-v4-1-flash/dsv41-architecture/dsv41-sparse-indexer/), tổng = 356 B mỗi entry → 356.000 B. Kiểm trường hợp: tăng số head Q gấp đôi không đổi 288.000 B; nếu cache đổi, đang nhầm K/V riêng cho head — đó là lỗi thuật toán, không phải thuộc tính MLA.
6Thuật ngữ
- compress_kv (latent 512)
- Vector K/V nén 512 chiều đại diện cho một entry; mọi head attention đọc chung, không lưu K, V riêng cho từng head.
- RoPE nửa sau và inverse RoPE
- Phần xoay vị trí chỉ áp trên nửa cuối chiều latent; đầu ra được xoay ngược (inverse RoPE) trước khi vào phép chiếu đầu ra nhóm.
- W_O nhóm
- Phép chiếu đầu ra làm việc theo nhóm head: mỗi nhóm gộp đầu các head của mình rồi ghép lại thành chiều ẩn, thay vì một ma trận lớn duy nhất.
- Trục token vs trục feature
- CSA2 nén theo trục token (gộp nhiều token thành ít entry); MLA nén theo trục feature (giảm số chiều của từng entry).
Glossary (4)
- Latent
- Vector nén đại diện cho nhiều thành phần gốc; ở đây là K/V sau khi đã giảm số chiều.
- RoPE tail
- Phần latent mang thông tin vị trí, được xoay theo RoPE; chỉ nằm ở nửa cuối các chiều.
- Inverse RoPE
- Bước xoay ngược RoPE trên đầu ra attention, để phần xoay vị trí khỏi rò vào phép chiếu cuối.
- Nhóm head
- Tập head chia cụm để chiếu đầu ra; mỗi cụm có ma trận W_O riêng nhỏ hơn, ghép lại thành chiều ẩn.