6A · KV Budget FP4
6A · Ngân sách KV FP4 · 890 bytes mỗi token
Ngân sách KV cache của DeepSeek-V4.1-Flash cộng ra 890 B/token: 720 B compress_kv từ bốn lớp nguồn với FP4 E2M1 và scale E4M3, 170 B index_k với scale E8M0, không gồm cửa sổ SWA.
1Định nghĩa
Ngân sách KV là cách cộng tổng chi phí lưu một token vào cache lâu dài của DeepSeek-V4.1-Flash: 890 B/token, cộng từ hai phần. Phần compress_kv 720 B/token đến từ bốn lớp KV nguồn (2, 8, 14, 20) theo nén trục token của bài CSA2; phần index 170 B/token đến từ index_k 128 chiều FP4 của bộ chọn indexer. Latent và index lưu theo định dạng số 4 bit E2M1 0.5 B/số kèm scale; cửa sổ SWA không đóng góp gì vào con số này vì không persist.
Về cơ chế, một entry nén chiếm 288 B cho K/V: latent 512 × 0.5 = 256 B và RoPE tail 64 × 0.5 = 32 B như cộng trong bài MLA; lớp gộp n = 2 thì mỗi token chỉ trả 144 B, lớp không gộp n = 1 trả nguyên 288 B. Ba lớp gộp n = 2 cho 3 × 144 = 432 B và lớp 20 (n = 1) đóng góp 288 B, tổng 720 B. Phần index: mỗi entry index_k 128 × 0.5 = 64 B cộng 4 B scale E8M0 theo 32 kênh, tương đương 68 B mỗi entry hay 34 B/token cho lớp gộp; ba lớp gộp cho 3 × 34 = 102 B và lớp 20 cho 68 B, tổng 170 B. Tổng của hai phần là 720 + 170 = 890 B/token; theo bước 6A của Bài Lab tổng hợp DeepSeek-V4.1-Flash để tự cộng và đối chiếu.
Ví dụ đời thường: ngân sách KV giống bảng giá niêm yết theo trọng lượng: mỗi loại hàng có một giá cố định, hàng đóng cặp được chia cho hai người dùng (n = 2) nên mỗi người trả giá một nửa, hàng gói riêng (n = 1) trả nguyên giá. Tổng hoá đơn là cộng từng mục, không dựa theo cảm nhận nên tính được trước. Giới hạn của phép so: đây là giá niêm yết khai báo theo đơn giá, chưa gồm chi phí truy cập và độ chính xác FP4 thực trên phần cứng.
2Luồng
Cách đọc hình (Cột 3, khối 6A nửa dưới): đây là trụ bộ nhớ HBM nối hai chiều Store KV / Load KV với 4A và Cột 2 (không phải bước chỉ chạy sau 5A), lưu 4 lớp nguồn [2, 8, 14, 20] ở FP4 E2M1 + FP4 Indexer K + SWA Bounded Replay = 890 B/tok; xem bước [6A] trong Bài Lab tổng hợp ở Tab 02.
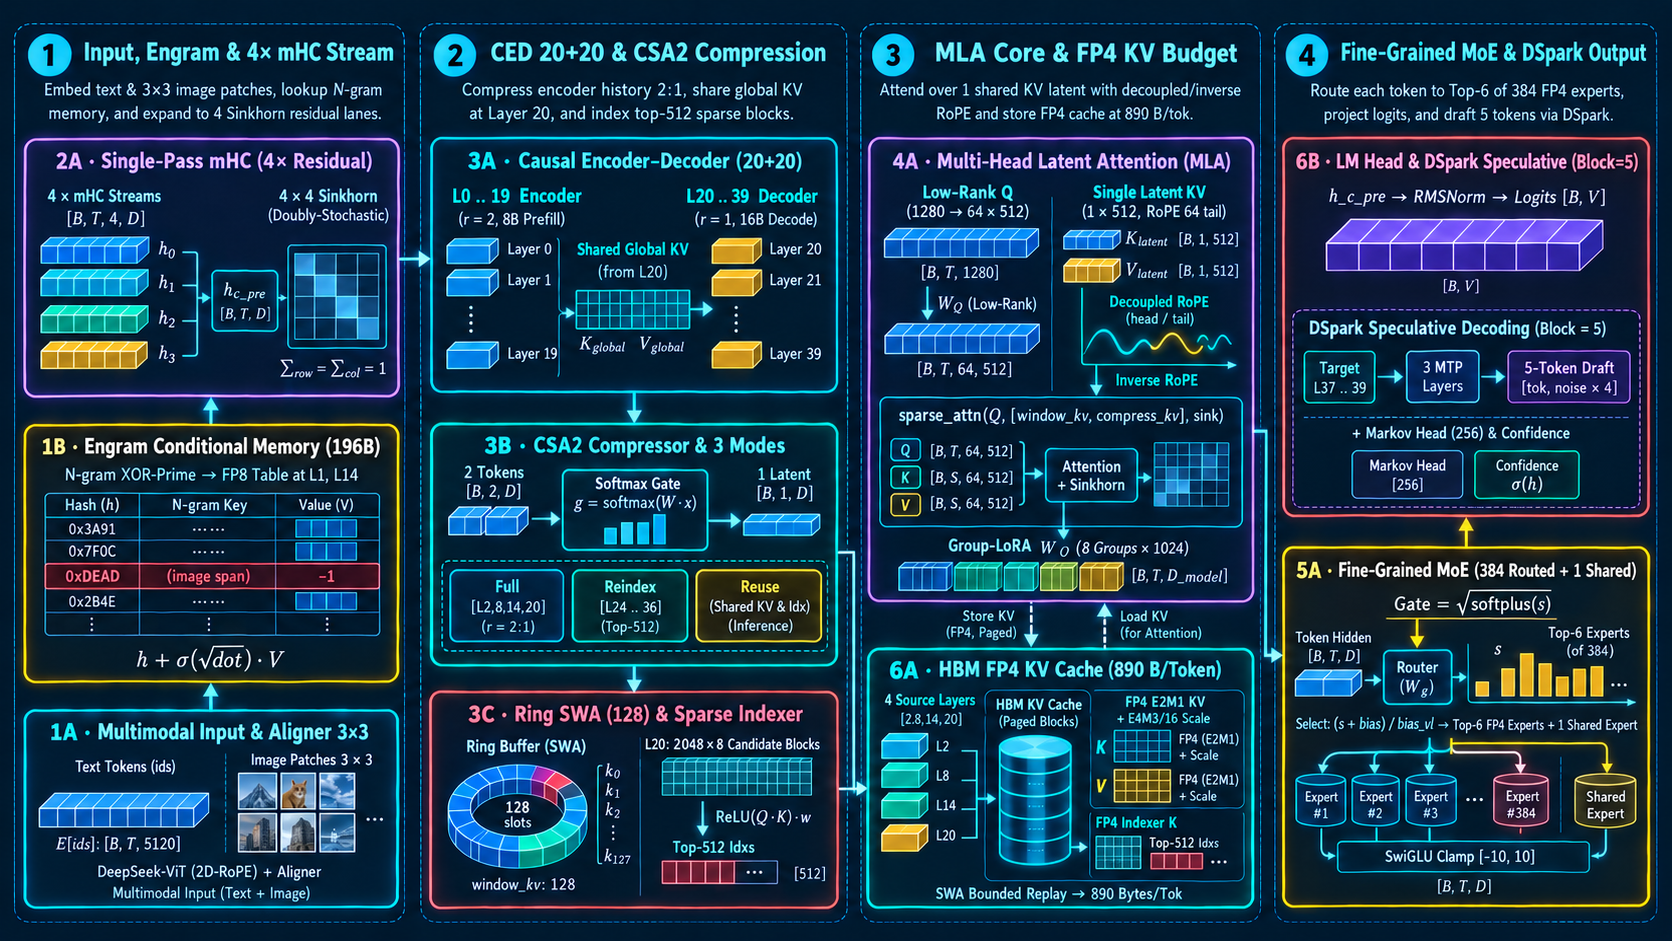
4 Source Layers [2,8,14,20] · FP4 E2M1 KV + E4M3/16 Scale · FP4 Indexer K · SWA Bounded Replay → 890 Bytes/Tok6A · HBM FP4 KV Cache (890 B/Token)
Nửa dưới Cột 3: trụ bộ nhớ HBM chỉ lưu Global KV tại 4 lớp nguồn [2, 8, 14, 20] ở định dạng FP4 (E2M1), ép tổng dung lượng xuống 890 bytes/token.
Nằm ngay dưới 4A ở Cột 3 là nhánh bộ nhớ HBM cấp phát và nạp lại KV (Store KV / Load KV): thay vì giữ KV của cả 40 lớp, hệ thống chỉ lưu lâu dài tại 4 lớp nguồn L2, L8, L14 (r=2) và L20 (r=1). Mỗi vector KV 512 chiều được lượng tử hóa sang FP4 E2M1 (0.5 byte/phần tử) kèm scale E4M3 mỗi 16 kênh; cộng thêm khóa FP4 Indexer K và cơ chế SWA Bounded Replay giúp toàn bộ bộ nhớ đệm KV toàn cục chỉ tốn đúng 890 bytes/token.
- 6A · Nhận đơn giá từ các khối trước
Entry latent 288 B đến từ MLA và entry index 68 B đến từ cấu trúc indexer là số dùng cho bảng đơn giá.
- 6A · Cộng theo lớp nguồn
Bốn lớp KV nguồn (2, 8, 14, 20) được cộng riêng theo n của từng lớp, rồi cộng thêm phần index.
- 6A · Dùng ngân sách để tính dung lượng dài
890 B/token nhân số token cho ra dung lượng cache; dùng trước khi chuẩn bị phần cứng hoặc tính số phiên trên bộ nhớ có sẵn.
Mã Mermaid
flowchart TD
  step1["6A · Nhận đơn giá từ các khối trước"]
  step2["6A · Cộng theo lớp nguồn"]
  step3["6A · Dùng ngân sách để tính dung lượng dài"]
  step1 --> step2
step2 --> step33Giải pháp
Bài toán cần giải: cần biết trước mỗi token chiếm bao nhiêu byte cache để lên kế hoạch phần cứng cho phiên hội thoại dài; chỉ nắm một con số tổng dễ sai khi các thành phần xếp lệch. Sau bài này, bạn cần tự kể được: 890 B/token cộng từ những mục nào, tại sao lớp n = 2 chỉ tính giá một nửa, và cửa sổ SWA không góp bao nhiêu.
Đơn giá của một entry: latent 512 và RoPE tail 64 với FP4 E2M1 cho 288 B mỗi entry KV; index_k 128 với FP4 cộng scale E8M0 theo 32 kênh cho 68 B mỗi entry index. Bốn lớp nguồn (2, 8, 14, 20) đều có cả hai phần; các lớp khác không có. Ngân sách không gồm cửa sổ SWA vì phần đó không persist.
Cộng từng mục theo n: lớp 2, 8, 14 có n = 2 nên mỗi token chỉ gánh một nửa entry: 288 / 2 = 144 B và 68 / 2 = 34 B; lớp 20 n = 1 nên trả nguyên giá 288 + 68. Cột rõ: 3 × 144 + 288 = 720 B cho compress_kv; 3 × 34 + 68 = 170 B cho index. Hãy tự cộng lại một lần để kiểm.
Độ chính xác và scale: FP4 E2M1 so với FP8 cần scale để tái dựng; mỗi 16 kênh latent có một scale E4M3, mỗi 32 kênh index có một scale E8M0. Chi phí scale đã gồm trong 288 B và 68 B; không tính hai lần khi cộng 890.
Dùng ngân sách để ra quyết định: phiên 1M token cần 890 B/token × 1.000.000 ≈ 890 MB cache; hai phiên song song cần gần gấp đôi; đây chỉ là cache, chưa gồm trọng số mô hình. Muốn thấy bảng đơn giá, tự cộng 256 + 32 cho 288, hoặc 64 + 4 cho 68, và mở bước 6A của Bài Lab tổng hợp DeepSeek-V4.1-Flash khi cần.
4Profiling
- Độ chính xác dequant với scale đã nói
Kiểm độ chính xác trước: dequant từng nhóm 16 kênh với scale E4M3 so với giá trị FP32 của cùng một entry trên vài entry mẫu; sai khác trong ngưỡng đã chọn trước theo dtype FP4. Nếu vượt, kiểm tra áp dụng scale và thứ tự kênh trước khi quy lỗi cho số 4 bit.
- Đối chiếu cache theo lớp
Đo cache mỗi lớp từ runtime rồi cộng: lớp 2, 8, 14 gần 3 × 144 = 432 B; lớp 20 gần 288 B; cộng index tương ứng 3 × 34 + 68 = 170 B. Tổng bằng gần 890 B/token; nếu thiếu, kiểm tra lớp nào bị bỏ đếm và đảm bảo index_k không bị tính chung cho hai lớp nguồn.
- Byte đọc theo lớp trong decode
Đo byte đọc compress_kv và index_k cho từng token trong pha decode của lớp 20 và lớp n = 2; lớp 20 đọc nguyên entry, lớp n = 2 đọc nửa entry mỗi token; tổng các lớp nên khớp với ngân sách đã tính, nếu dưới mức đó là có lớp nguồn bị đếm sai.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Bước 1 · Dự đoán tổng 890
Input: bốn lớp KV nguồn (2, 8, 14, 20) với n = [2, 2, 2, 1]; entry latent 288 B và entry index 68 B. Trước khi tính, hãy dự đoán: mỗi token phải trả bao nhiêu byte lưu trữ trên cache lâu dài, và cửa sổ SWA có góp phần nào không? Đáp án ở Bước 2; có thể đối chiếu bảng đơn giá in rõ ở 6A của [bài lab tổng hợp](/courses/deepseek-v4-1-flash/dsv41-lab/dsv41-end-to-end-lab/).
Bước 2 · Cộng từng mục thành 890 B/token
Tính: 3 × 144 + 288 = 432 + 288 = 720 B cho compress_kv (lớp n = 2 mỗi token trả 144 B vì entry chia cho hai token; lớp 20 trả nguyên 288 B). 3 × 34 + 68 = 102 + 68 = 170 B cho index_k. Tổng: 720 + 170 = 890 B/token; cửa sổ SWA là 0 B vì không persist. Tự kiểm tra: nếu mọi lớp đều n = 1 thì ngân sách = 4 × 288 + 4 × 68 = 1152 + 272 = 1424 B/token, nhiều hơn 890, cho thấy mức gộp n = 2 tiết kiệm bao nhiêu; nếu bỏ FP4 mà giữ FP8 (1 B/số), latent chiếm gấp đôi nên không thể giữ nguyên 890 B/token.
Tự kiểm tra · Dựng cache theo số token
Giả sử phiên hội thoại 1M token và không chia sẻ cache giữa các phiên. Tự kiểm tra: cache = 1.000.000 × 890 B = 890.000.000 B ≈ 890 MB; với 2M token thì ≈ 1.78 GB, gần gấp đôi. Kiểm riêng phần index: 1.000.000 × 170 B = 170 MB của tổng trên là phần index, phần nén vẫn chiếm 720 MB; nếu đo trên thiết bị cho ra khác rõ, kiểm tra xem runtime có đếm trùng entry index cho các lớp nguồn nào hay chưa.
6Thuật ngữ
- FP4 E2M1
- Dạng số 4 bit dùng cho latent: 0.5 byte mỗi số; cần scale bên ngoài để tái dựng đúng độ lớn của vector.
- Scale E4M3 theo 16 kênh
- Mỗi nhóm 16 kênh của latent FP4 có một scale FP8 E4M3 làm bình nhân khi dequant.
- Scale E8M0 theo 32 kênh
- Mỗi nhóm 32 kênh của index_k FP4 có một scale dạng luỹ thừa E8M0, 1 byte mỗi nhóm.
- n (compress ratio từng lớp)
- Số token gộp vào một entry nén của lớp đó; lớp 2, 8, 14 có n = 2 và lớp 20 có n = 1.
Glossary (4)
- Đơn giá (per-entry byte)
- Số byte một entry chiếm trong cache; latent 288 B và index 68 B cho mỗi entry KV nguồn.
- Dequant
- Bước nhân scale để tái dựng số thật từ dạng FP4; sai khác được đo theo từng nhóm scale.
- 1M token
- Một triệu token; với 890 B/token, cache cần khoảng 890 MB, chưa gồm trọng số mô hình.
- GQA
- Kiến trúc chia K/V theo nhóm head; dùng làm mối so sánh vì không có latent dùng chung và nén token như bài này.