5A · MoE fine-grained
5A · MoE fine-grained · tách vai trò chọn và nhân ở cổng chuyên gia
MoE fine-grained tách hai vai trò ở cổng: chọn chuyên gia theo scores + bias, trọng số nhân từ gate sqrt(softplus) thô; bias_vl chỉ nghiêng lựa chọn tại vị trí ảnh, không đổi giá trị cổng.
1Định nghĩa
MoE fine-grained là khối feed-forward của khối 5A: thay một khối MLP dùng chung, mỗi token đi qua một số chuyên gia nhỏ được chọn riêng, còn một shared expert luôn chạy cho mọi token. Hai vai trò ở cổng được tách rõ: phần CHỌN chuyên gia dùng scores + bias, trong đó bias_vl chỉ áp dụng tại vị trí ảnh; phần TRỌNG SỐ nhân dùng gate = sqrt(softplus(scores)) lấy ở dạng thô. Kiến trúc thuộc họ mạng chuyên gia thiết kế và cùng hướng chia sẻ với bài MoE latent đã trình bày.
Về cơ chế, scores của mỗi chuyên gia vừa dùng để chọn vừa dùng để tính gate; chọn là phép so sánh theo scores + bias rồi lấy top-k, còn gate là sqrt(softplus(scores)) không chuẩn hóa. Ví dụ: với scores [1, 2] thì softplus cho [1.313262, 2.126928] và gate thô [1.145976, 1.458399], hai giá trị này nhân vào đầu ra chuyên gia sau khi khối SwiGLU với clamp ±10 chạy. Trong khối thu nhỏ của lab, bước 5A chọn 2 trong 4 chuyên gia; để thấy bảng scores và kết quả chọn in rõ, theo bước 5A của Bài Lab tổng hợp DeepSeek-V4.1-Flash.
Ví dụ đời thường: MoE giống phòng y tế tuyến đầu: bệnh nhân không được chữa bởi mọi bác sĩ, mà do điều phối chọn hai bác sĩ phù hợp, còn y tá trực chung (shared expert) vẫn ghi hồ sơ cho mọi bệnh nhân. Điều phối chọn theo điểm số cộng một ưu tiên đặc biệt cho ca ảnh; phần việc chung không phụ thuộc ca được chọn. Giới hạn của phép so: điều phối có thể chọn sai và mỗi token chỉ thấy vài chuyên gia, phần còn lại của mô hình không chạy cho token đó.
2Luồng
Cách đọc hình (Cột 4, khối 5A nửa dưới): nhận đầu ra từ 4A (Cột 3) sang Cột 4 dưới, tính cổng Gate = √softplus(s), dùng (s + bias) / bias_vl chọn Top-6/384 chuyên gia FP4 + 1 Shared Expert, kẹp SwiGLU [-10, 10] rồi đẩy lên 6B; xem bước [5A] trong Bài Lab tổng hợp ở Tab 02.
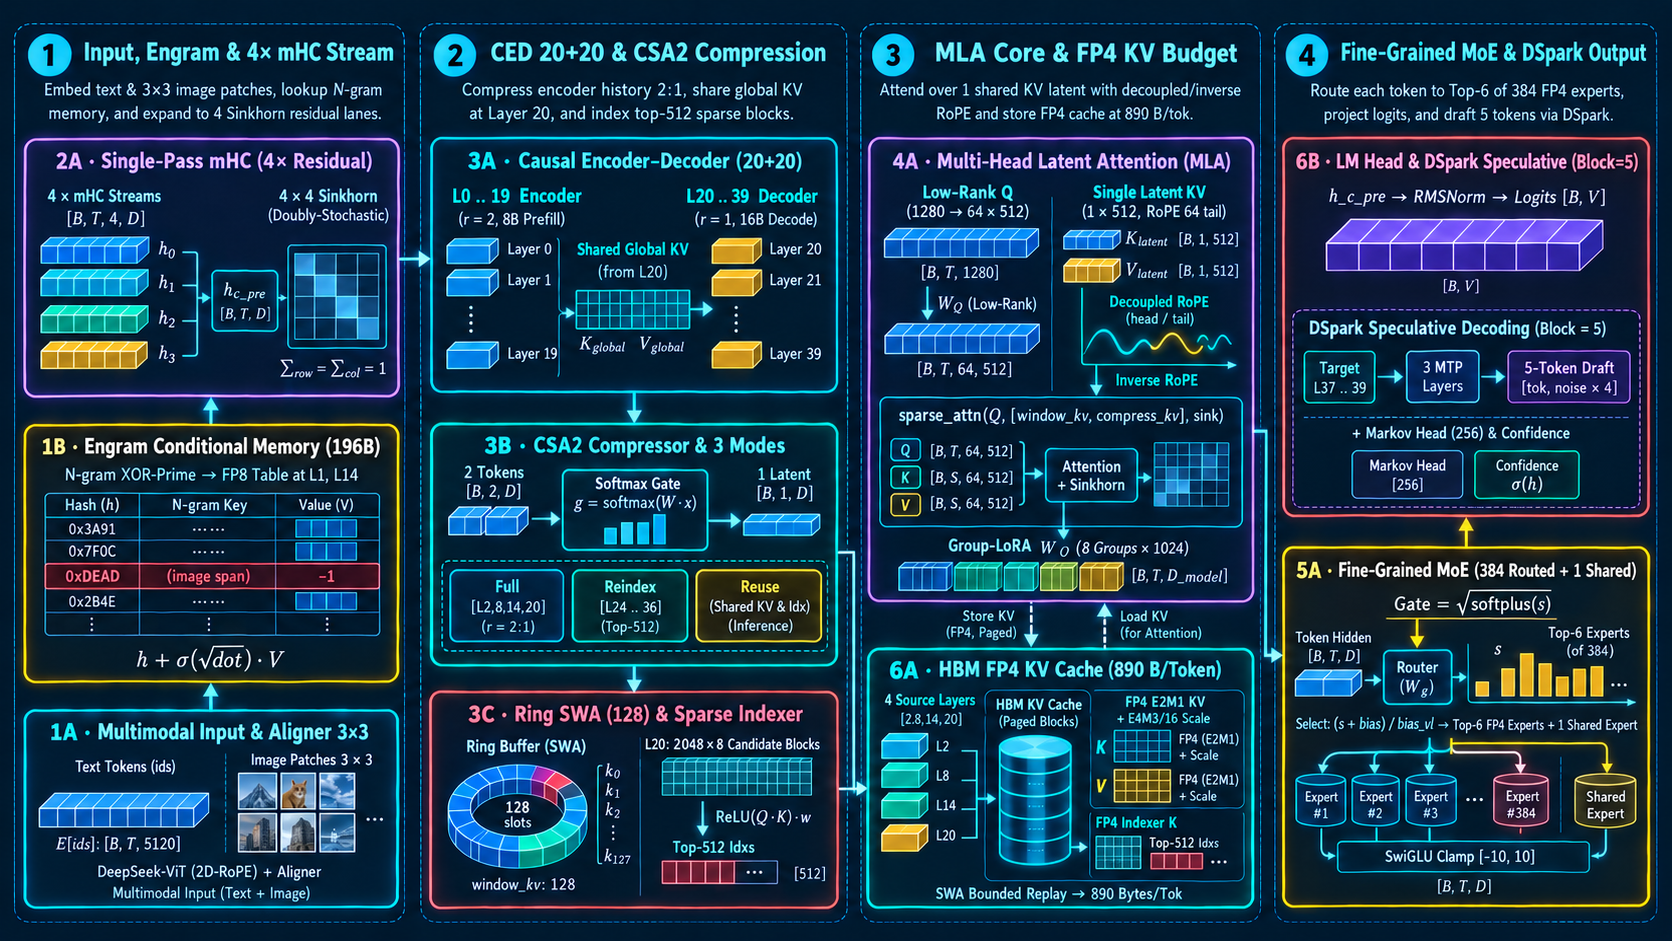
Gate = √softplus(s) · Select: (s + bias) / bias_vl → Top-6 FP4 Experts (of 384) + 1 Shared Expert · SwiGLU Clamp [-10, 10]5A · Fine-Grained MoE (384 Routed + 1 Shared)
Nửa dưới Cột 4: Router chấm điểm bằng √softplus(s), dùng bias/bias_vl để chọn Top-6/384 chuyên gia FP4 + 1 chuyên gia chung và kẹp SwiGLU [-10, 10].
Đầu ra từ 4A (Cột 3) đi sang 5A ở nửa dưới Cột 4: mỗi token được Router (W_g) chấm điểm qua hàm Gate = √softplus(s). Bộ chọn cộng thêm bias cân bằng tải (hoặc bias_vl riêng cho vị trí ảnh) để nhặt ra Top-6 trong 384 chuyên gia định tuyến (lưu ở FP4), nhưng trọng số nhân kết hợp lấy từ điểm Gate thô chưa cộng bias, rồi cộng với 1 Shared Expert luôn bật. Mọi chuyên gia đều kẹp biên SwiGLU trong [-10, 10] trước khi trả về [B, T, D].
- 5A · Tách chọn khỏi nhân
Chọn chuyên gia theo scores + bias; trọng số nhân lấy từ sqrt(softplus) ở dạng thô.
- 5A · Fine-grained và shared
Nhiều chuyên gia nhỏ cùng một shared expert luôn tính: token chọn vài chuyên gia, phần chung vẫn chạy.
- 5A · Bàn giao sang khối cuối
Đầu ra khối MoE đi sang khối cuối: cộng logits và DSpark vẽ token nháp ở 6B.
Mã Mermaid
flowchart TD
  step1["5A · Tách chọn khỏi nhân"]
  step2["5A · Fine-grained và shared"]
  step3["5A · Bàn giao sang khối cuối"]
  step1 --> step2
step2 --> step33Giải pháp
Bài toán cần giải: khối MLP to làm tăng chi phí tính cho mọi token; cần chuyên gia nhỏ nhiều hơn nhưng chỉ kích hoạt một phần nhỏ cho mỗi token. MoE fine-grained đáp ứng bằng nhiều chuyên gia nhỏ và chọn top-k; sau bài này, bạn cần tự kể được: tại sao tách chọn khỏi nhân, bias_vl được áp dụng đâu và đổi điều gì, và shared expert đứng ở phần nào của phép cộng.
Tách CHỌN khỏi TRỌNG SỐ: chọn chuyên gia theo scores + bias, lấy top-k; trọng số nhân không phải softmax của những lựa chọn đó, mà là gate = sqrt(softplus(scores)) ở dạng thô. Điều quan trọng: bias_vl chỉ nghiêng phần CHỌN (chuyên gia xử lý phương thức ảnh được cộng ưu tiên) tại vị trí ảnh, không đổi giá trị cổng; nếu bias_vl về 0, chuyên gia được chọn có thể đổi, trong khi trọng số vẫn lấy từ gate thô.
Shared expert: một chuyên gia chung chạy cho mọi token giúp phần công việc lặp lại không chiếm quota chọn; chuyên gia riêng chỉ thêm phần đặc thù. Giống bài Engram bộ nhớ có điều kiện đã trình bày: phần luôn chạy trong đường, phần chỉ chạy khi điều kiện khớp tách riêng.
SwiGLU với clamp ±10: khối bên trong chuyên gia là SwiGLU nhưng cắt giá trị vào phạm vi cho phép, giữ số lớn không tràn độ lớn. Điều này quan trọng vì: weights chưa học có thể cho số kích hoạt lớn, và clamp giữ kết quả đo được; khi so sánh lần chạy, bỏ quên clamp sẽ cho kết quả lệch so với runtime.
Chảy tiếp sang khối cuối: đầu ra các chuyên gia được cộng theo trọng số gate rồi qua phép cộng residual; sau đó logits tổng hợp và dự đoán nháp nằm ở bài LM head và DSpark. Muốn tự tay tính phần chọn, theo bước 5A của Bài Lab tổng hợp DeepSeek-V4.1-Flash với bảng scores và bias_vl in rõ.
4Profiling
- Parity chọn chuyên gia với bias_vl bằng 0
Kiểm chọn trước: đặt bias_vl = zeros rồi chạy cùng một prompt; so chuyên gia được chọn và trọng số theo từng vị trí. Lưu ý: luồng từ làn trước của chính vị trí đó thay đổi làm scores có thể đổi, nên so cặp vị trí riêng, không so khác lớp. Gate thô không gồm bias_vl nên chỉ phần chọn đổi.
- Độ chính xác gate với softplus
Đo gate = sqrt(softplus(scores)) bằng FP32 và dtype chạy thật cho cùng một scores; sai khác phải nhỏ hơn ngưỡng định trước của dtype; với x lớn, softplus(x) ≈ x, kiểm nhánh x > ngưỡng dùng công thức ổn định này và lấy đúng ngưỡng trước.
- Thời gian đọc chuyên gia khi thay đổi top-k
Đo thời gian từng token khi top-k là 1, 2, 4 giữ cùng độ dài; tăng top-k tăng số expert đọc và phép cộng, không đổi kích thước latent; số lần trượt top cũng ghi lại để kiểm phần shared không được cộng trùng.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Bước 1 · Dự đoán gate khi scores [1, 2]
Input: scores của hai chuyên gia s0 = 1, s1 = 2. Trước khi tính, hãy dự đoán: gate của chuyên gia nào lớn hơn, và phần chọn theo scores + bias có phụ thuộc giá trị gate không? Đáp án ở Bước 2; có thể tính tay theo bảng scores in rõ trong 5A của [bài lab tổng hợp](/courses/deepseek-v4-1-flash/dsv41-lab/dsv41-end-to-end-lab/).
Bước 2 · Tính sqrt(softplus)
Tính: softplus(1) = 1.313262, căn bậc hai = 1.145976; softplus(2) = 2.126928, căn bậc hai = 1.458399. Gate thô là [1.145976, 1.458399], không chuẩn hóa thành phân phối. Tự kiểm tra: nếu s0 = 0 và s1 = 0 thì softplus(0) = 0.693147 và gate cả hai = 0.832555; gate dương mà không chuẩn hóa, nên tổng trọng số hai chuyên gia không cố định bằng 1.
Tự kiểm tra · bias_vl và đổi chọn chuyên gia
Input: lab mặc định chọn chuyên gia 3 và 0 tại pos 1 (token ảnh) nhờ bias_vl, trọng số nhân [0.558, 0.442]. Trước khi đọc đáp án, hãy dự đoán: nếu BIAS_VL = 0 thì chọn đổi thành cặp nào? Đáp án theo bài tập của [bài lab tổng hợp](/courses/deepseek-v4-1-flash/dsv41-lab/dsv41-end-to-end-lab/): đổi thành 3 và 1 với [0.639, 0.361] (scores pos 1 lớp 1 đổi thành [-1.942, -0.033, -1.289, 1.987] vì luồng từ lớp trước cũng đổi). Tự kiểm tra: bias_vl chỉ đổi phần CHỌN; trọng số nhân luôn lấy từ gate sqrt(softplus) thô, không đi qua bias.
6Thuật ngữ
- Fine-grained expert
- Chuyên gia nhỏ, số lượng nhiều: thay vì ít chuyên gia to, mô hình có nhiều chuyên gia nhỏ hơn và mỗi token chọn vài chuyên gia.
- scores + bias
- Hai phần dùng để CHỌN chuyên gia: điểm số của mỗi chuyên gia cộng một bias; bias_vl chỉ áp dụng tại vị trí ảnh.
- Gate sqrt(softplus)
- Cổng TRỌNG SỐ nhân: gate = căn bậc hai của softplus(scores), lấy ở dạng thô, không chuẩn hóa; phần chọn chuyên gia và giá trị cổng là hai việc riêng.
- Shared expert
- Chuyên gia chung luôn được tính cho mọi token, mang một phần công việc lặp lại, giúp chuyên gia riêng chỉ sửa phần đặc thù.
- SwiGLU với clamp
- Khối MLP bên trong chuyên gia là SwiGLU nhưng cắt giá trị vào phạm vi cho phép, ví dụ ±10, để tránh một góc số đẩy độ lớn.
Glossary (4)
- Top-2 chuyên gia
- Số chuyên gia được chọn cho một token; trong lab thu nhỏ là chọn 2 trong 4 chuyên gia.
- bias_vl
- Bias cộng thêm về phía các chuyên gia xử lý phương thức ảnh, chỉ áp dụng tại vị trí ảnh; đổi chuyên gia được CHỌN, không đổi giá trị gate.
- Điểm thô và điểm chuẩn hóa
- Gate lấy từ giá trị thô của sqrt(softplus); softmax cho phân phối chỉ dùng ở phần chọn, không dùng làm trọng số nhân.
- scores
- Điểm số học được của mỗi chuyên gia cho token hiện tại; là cơ sở của cả phần chọn lẫn phần gate.