3A · Causal Encoder-Decoder
3A · Kiến trúc CED 20+20 · Khối mã hóa nhân quả và KV toàn cục dùng chung
CED chia 40 lớp thành 20 lớp mã hóa nhân quả nén r=2 và 20 lớp decoder đọc chung một global KV chiếu từ lớp 20, cho phép 8B tham số active khi prefill và 16B khi decode.
1Định nghĩa
Causal Encoder-Decoder (CED) là kiến trúc lõi của lớp 3A: 40 lớp của DeepSeek-V4.1-Flash chia thành 20 lớp mã hóa nhân quả (lớp 0–19) và 20 lớp decoder (lớp 20–39). Khác encoder–decoder T5 đọc toàn bộ văn bản nguồn hai chiều, encoder ở đây vẫn dùng mặt nạ nhân quả, nên toàn mạng vẫn là mô hình sinh trái qua phải. Hidden ra từ lớp 19 được lớp 20 chiếu thành một bộ global KV 512 chiều duy nhất. Bài toán CED giải quyết là chi phí bộ nhớ và băng thông của decoder: thay vì 20 lớp decoder mỗi lớp giữ một bộ KV riêng, cả 20 lớp cùng đọc một bộ KV toàn cục.
Về cơ chế, các lớp 0–1 không nén (compress ratio 0); các lớp 2–19 nén gộp hai token một entry (ratio 2) theo cách CSA2 gộp token; lớp 20 không nén (ratio 1) và chiếu hidden thành global KV; các lớp decoder 20–39 đọc cùng bộ này. Khi prefill, toàn chuỗi prompt chạy qua encoder một lượt rồi tạo KV; khi decode, token mới chỉ cần đọc global KV đã ghi thay vì chạy lại 20 lớp encoder. Model card công bố 8B tham số active cho prefill và 16B cho decode: hai pha không cùng mức kích hoạt, và đừng nhầm 8B/16B với dung lượng checkpoint. Muốn xem dữ liệu đi qua cả ba phần, mở bước 3A của Bài Lab tổng hợp DeepSeek-V4.1-Flash.
Ví dụ đời thường: CED giống nhà hàng có bếp chuẩn bị (encoder) và bếp nấu (decoder): đầu bếp chuẩn bị đọc toàn bộ đơn món theo thứ tự đến, dựng một bảng tóm tắt nguyên liệu chung duy nhất treo giữa bếp, và cả 20 tay nấu phía sau cùng nhìn một bảng đó thay vì mỗi tay tự lập bảng riêng. So sánh này giúp nhớ hai ý: bảng chung được dựng một lần từ encoder, và phần phía sau rất nhiều tay nhưng cùng một nguồn dữ liệu. Giới hạn của phép so: đây là thiết kế trang bị cố ý, không phải bảng vô nghĩa; nếu bảng sai thì phần phía sau vẫn sai, và mô hình học chính bảng này khi huấn luyện chứ không phải một bảng trống.
2Luồng
Cách đọc hình (Cột 2, khối 3A trên đỉnh): nhận luồng từ 2A sang đầu Cột 2, chia 40 lớp thành 20 lớp Encoder (r=2, 8B prefill) và 20 lớp Decoder (r=1, 16B decode) đọc chung bộ Shared Global KV phát từ lớp 20; xem bước [3A] trong Bài Lab tổng hợp ở Tab 02.
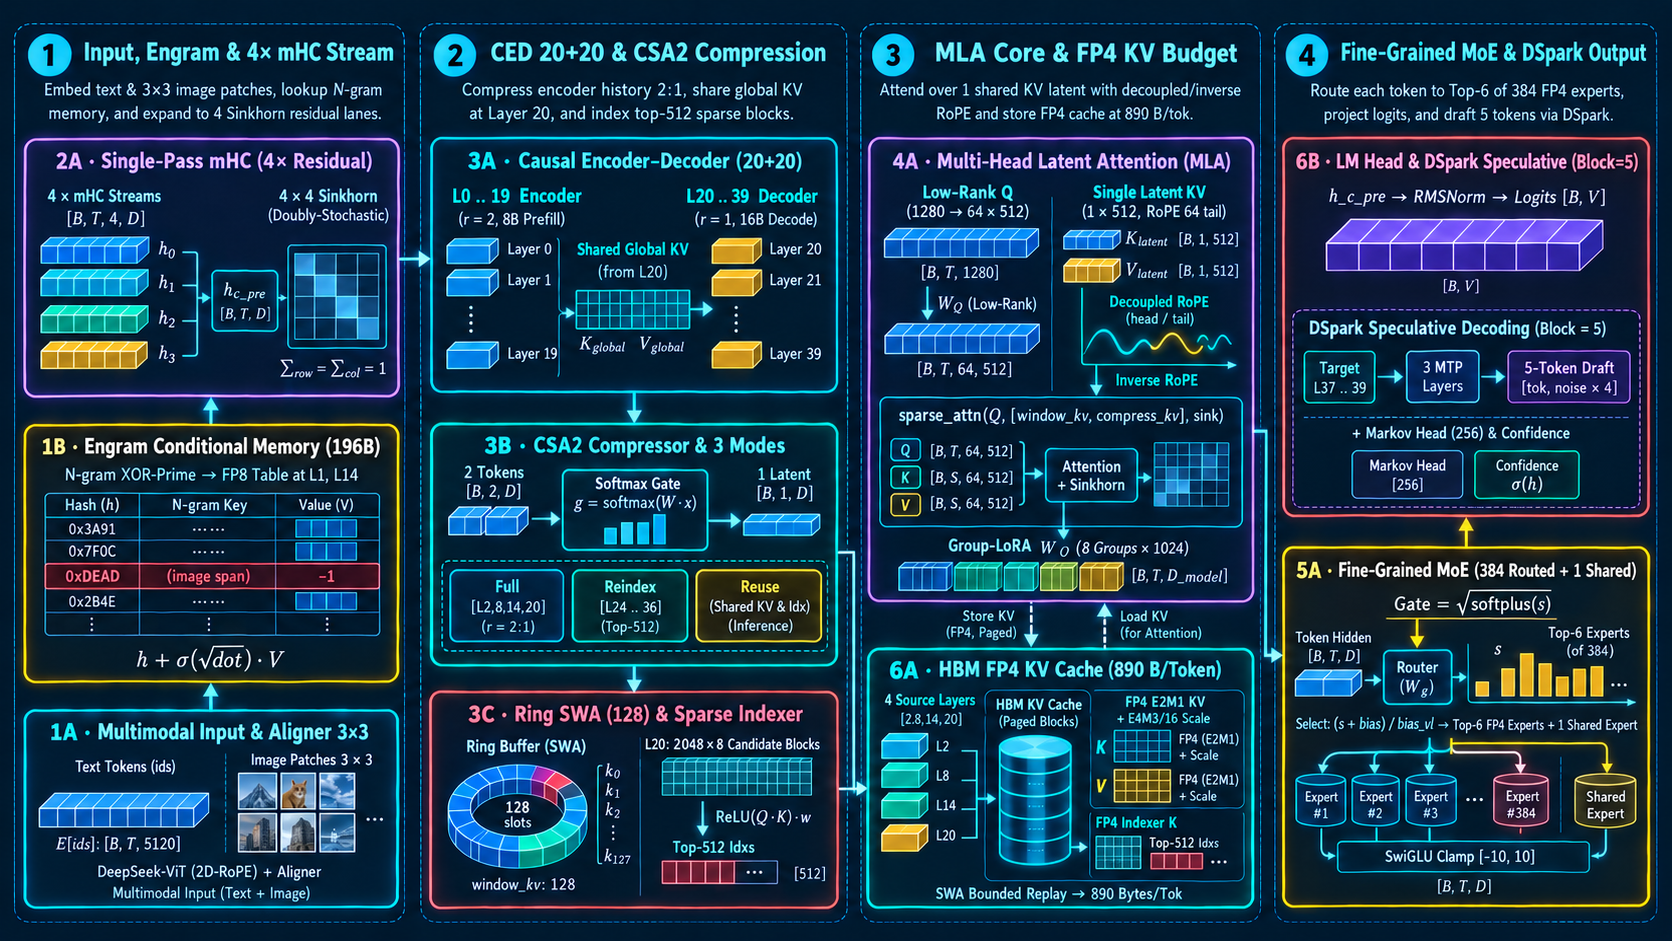
L0..19 Encoder (r=2, 8B Prefill) → Shared Global KV (from L20: K_global, V_global) → L20..39 Decoder (r=1, 16B Decode)3A · Causal Encoder–Decoder (20+20)
Đầu Cột 2: chia 40 lớp thành 20 lớp Encoder (nén r=2, 8B prefill) và 20 lớp Decoder đọc chung bộ Shared Global KV phát từ lớp 20.
Mũi tên từ 2A đi sang 3A ở đầu Cột 2: thay vì 40 lớp giống hệt nhau, 20 lớp đầu (Layer 0..19) làm Causal Encoder nén lịch sử với r=2, sau đó tại ranh giới Layer 20 chiếu ra một bộ Shared Global KV (K_global, V_global) duy nhất để toàn bộ 20 lớp Decoder (Layer 20..39) dùng chung. Nhờ vậy pha Prefill chỉ kích hoạt 8B tham số/token còn pha Decode kích hoạt 16B tham số/token.
- 3A · 20 lớp encoder nhân quả nén r=2
Các lớp 2–19 gộp từng cặp token thành một entry nén; lớp 0–1 không nén và chạy như attention thường.
- 3A · Lớp 20 chiếu global KV
Lớp 20 nén r=1 và chiếu hidden thành bộ KV toàn cục 512 chiều duy nhất cho decoder.
- 3A · 20 lớp decoder đọc KV dùng chung
Decoder 20–39 tự tính Q nhưng đọc cùng một compress_kv, tiết kiệm đáng kể bộ nhớ và băng thông.
Mã Mermaid
flowchart TD
  step1["3A · 20 lớp encoder nhân quả nén r=2"]
  step2["3A · Lớp 20 chiếu global KV"]
  step3["3A · 20 lớp decoder đọc KV dùng chung"]
  step1 --> step2
step2 --> step33Giải pháp
Bài toán cần giải: goodbye-donly truyền thống mỗi lớp giữ một KV cache riêng, nên với 20 lớp decoder, chi phí bộ nhớ và băng thông rất nặng. CED chọn phân công: 20 lớp đầu là khối mã hóa nhân quả, lớp 20 chiếu KV toàn cục, 20 lớp sau đọc chung. Sau bài này, bạn cần tự kể được: vì sao 40 lớp chia 20+20, vì sao lớp 20 là nơi chiếu KV, và hai số 8B prefill và 16B decode trong model card nghĩa là gì.
Trạng thái đầu vào: hidden ra từ lớp 1A là [B, S, 5120]. Các lớp 0–1 không nén (ratio 0) và chạy như attention thông thường; các lớp 2–19 có ratio 2, nghĩa là compressor gộp hai token liền kề thành một entry nén (chi tiết tại bài CSA2), một entry đại diện cho hai token; thu được dạng [B, S/2, 512] tại mỗi lớp này (nếu S chẵn). Ở lớp nén, entry sống lâu trong cache so với window ngắn.
Lớp 20 chiếu global KV: lớp 20 có ratio 1, nghĩa là nó không gộp token; mỗi token giữ một entry. Điểm đặc biệt: đầu ra KV tại lớp 20 được chiếu lên 512 chiều và được dùng như global KV cho cả 20 lớp decoder phía sau. Kiến trúc này giúp: không cần giữ KV riêng từng lớp decoder; KV global chỉ cần một bảng dùng chung cho 20 lớp. Đây là lý do chữ global trong tên kiến trúc.
Decoder 20–39 đọc KV dùng chung: các lớp decoder không tự tạo KV mỗi lớp như decoder-only truyền thống; chúng tự tính Q và đọc cùng một compress_kv global và window_kv của cửa sổ SWA. Đây cũng là ví dụ việc kết nối giữa ba chế độ Full, Reindex, Reuse được định sẵn khi huấn luyện, không có tùy chọn runtime.
Hai số 8B prefill và 16B decode: model card công bố DeepSeek-V4.1-Flash kích hoạt 8B tham số per token khi prefill, 16B tham số per token khi decode. Đây là số tham số active (không phải tổng trọng số 552B backbone, không phải bộ nhớ checkpoint). Hai pha khác nhau vì: khi prefill, mỗi token đi qua encoder với nén r=2 nên sẽ đọc ít dữ liệu hơn; khi decode, mỗi token chạy qua decoder và cần đọc đủ window KV và KV toàn cục. Chỉ khi đo riêng từng pha mới cho ra được con số chính xác; model card chỉ là công bố, chưa là đo của bạn. Không dùng số này để suy ra các tính chất khác.
Giới hạn và nơi quan sát: số 8B/16B là từ model card, chưa đảm bảo tương ứng thời gian thực, dtype, và thiết bị; bạn cần phân Exactly từ số đo thực. Lόγo further枯燥,', dùngする bài bài 6A — ngân sách KV 890 bytes/token để Tổng hợp các entry và byte theo ratios (2, 2, 2, 1). Chơi show driver in soft, mở bước 3A của Bài Lab tổng hợp DeepSeek-V4.1-Flash rồi tiếp bài indexer.
4Profiling
- Parity global KV
Kiểm tra tính đúng trước: với một chuỗi S tự chọn, so shape global KV tại lớp 20 là [B, S, 512] và cách decoder lớp 20–39 đọc cùng một tensor. Kiểm tra chéo: hai lớp decoder liên tiếp phải đọc cùng một tensor global KV; nếu runtime cho hai tensor khác nhau, kiểm tra cấu hình nguồn.
- Tham số active prefill vs decode
Đo thời gian prefill và decode cùng thiết bị và dtype; đối chiếu với hai số model card công bố (8B và 16B). Chưa đo thì không kết luận; báo cáo với số thực đo được và ghi điều kiện đo.
- Byte KV theo token
Bài [6A — ngân sách KV 890 bytes/token](/courses/deepseek-v4-1-flash/dsv41-architecture/dsv41-kv-fp4-budget/) trình bày cách tính: tổng các entry từ các lớp 2, 8, 14, 20 với ratios (2, 2, 2, 1); độ chênh có thể đến từ buffers tạm (kv_state, score_state) và FP4 scale theo từng nhóm kênh, ghi riêng để tách mà đừng trộn.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Bước 1 · Dự đoán số entry KV cho chuỗi 10 token
Input: chuỗi S_text = 10 token. Trước khi tính, hãy dự đoán: các lớp nén (2, 8, 14) tạo mỗi lớp bao nhiêu entry, lớp 20 bao nhiêu? Đáp án: mỗi lớp 2, 8, 14 có ratio 2 → mỗi lớp tạo 5 entry; lớp 20 có ratio 1 → 10 entry; tổng entry của 4 lớp = 3 × 5 + 10 = 25. Tự kiểm tra trong bước 3A của [bài lab tổng hợp](/courses/deepseek-v4-1-flash/dsv41-lab/dsv41-end-to-end-lab/) khi in số entry từng lớp.
Bước 2 · Tính byte mỗi token cho chuỗi 10 token
Mỗi entry KV nén có 512 chiều và lưu FP4 với scale E4M3 theo 16 kênh, nên một entry = 256 + 32 = 288 B (xem chi tiết trong [bài 6A — ngân sách 890 bytes/token](/courses/deepseek-v4-1-flash/dsv41-architecture/dsv41-kv-fp4-budget/)). Tính: tổng byte KV của 4 lớp = 25 × 288 = 7200 B cho cả chuỗi; chia cho 10 token được 720 B/token. Tự kiểm tra: nếu cộng thêm index_k (170 B/token như bài 6A trình bày), tổng là 890 B/token; đây là giới hạn mô tả vì chưa tính phần cửa sổ SWA, index cho những lớp khác, và buffers tạm.
Tự kiểm tra · Dự đoán với chuỗi lẻ 41 token
Input: chuỗi 41 token. Trước khi tính, hãy dự đoán: các lớp nén (2, 8, 14) mỗi lớp bao nhiêu entry toàn bộ, lớp 20 bao nhiêu? Đáp án: 2, 8, 14 là floor(41/2) = 20 entry mỗi lớp (một token cuối không đủ cặp nên nằm trong buffer như được trình bày trong [bài CSA2](/courses/deepseek-v4-1-flash/dsv41-architecture/dsv41-csa2-compression/)); lớp 20 có 41 entry. Tổng entry = 60 + 41 = 101; tổng byte = 101 × 288 = 29088 B; mỗi token = 29088/41 gần 709.5 B/token thay vì 720 B/token. Tự kiểm tra: phần lẻ khiến byte/token giảm nhẹ; xem bước 3A của lab để in số lượng entry từng lớp.
6Thuật ngữ
- Causal Encoder (lớp 0–19)
- 20 lớp đầu vẫn dùng mặt nạ nhân quả, chỉ đọc quá khứ; khác encoder hai chiều của T5, nó vẫn thuộc mô hình sinh trái qua phải.
- compress_ratios [0,0, 2×18, 1×20]
- Lớp 0–1 ratio 0 (không nén); lớp 2–19 ratio 2 (một entry nén cho hai token); lớp 20–39 ratio 1 (mỗi token một entry).
- Global KV tại lớp 20
- Lớp 20 chiếu hidden thành một bộ KV 512 chiều duy nhất; mọi lớp decoder 20–39 đọc cùng bộ này thay vì giữ KV riêng từng lớp.
- 8B prefill / 16B decode
- Hai số tham số active model card công bố cho hai pha; không phải dung lượng checkpoint hay bộ nhớ cần để chạy.
Glossary (3)
- Mặt nạ nhân quả
- Quy tắc vị trí i chỉ đọc các vị trí từ 0 đến i; áp cho cả encoder ở kiến trúc này, không chỉ decoder.
- Prefill và decode
- Prefill xử lý chuỗi prompt từ đầu; decode sinh token tiếp theo mỗi bước; hai pha dùng cùng kiến trúc nhưng mức tham số active khác nhau.
- Entry nén
- Một dòng dữ liệu KV đã gộp từ nhiều token, lưu trong compress_kv; Entry sống lâu trong cache theo ratio của lớp.