1B · Conditional Memory
1B · Bộ nhớ có điều kiện Engram · Tra cứu bảng băm N-gram 196B
Engram mở rộng tri thức bằng 196B tham số bảng tra cứu n-gram: khóa từ cụm 2–4 token qua hàm băm XOR cuộn, trả về vector FP8 trộn vào 4 làn residual qua cổng signed-sqrt rồi sigmoid.
1Định nghĩa
Engram là bộ nhớ có điều kiện của DeepSeek-V4.1-Flash chạy song song với backbone 552B: thay vì mọi tri thức đều nằm trong trọng số phải tính mỗi token như [mạng chuyên gia MoE], phần tri thức tĩnh được đưa ra thành các bảng tra cứu n-gram tổng cộng 196B tham số, được đọc theo địa chỉ chứ không theo phép nhân. Bài toán nó giải quyết là cân đối dung lượng tri thức với chi phí tính mỗi token: bảng rất lớn nhưng mỗi lần tra chỉ đọc vài dòng, nên chi phí tính gần như không tăng theo kích thước bảng. Đây là bước 1B, hoạt động ngay trên chuỗi ẩn 5120 chiều của lớp đầu vào 1A.
Về cơ chế, mã token trước hết được chuẩn hóa qua build_compressed_token_map để các dạng của cùng một từ như ' The', 'the', 'THE' tạo một khóa thống nhất; các cụm 2 đến 4 token sau chuẩn hóa là các n-gram khóa. Khóa qua hàm băm cuộn XOR với cấp số nhân số nguyên tố và chia dư cho số bucket nguyên tố trong EngramLayout, trả về địa chỉ dòng bảng; các vị trí thuộc span ảnh bị gắn DEAD (giá trị -1) và không tra. Bảng lưu vector FP8, và chỉ hai lớp được tra là lớp 1 và lớp 14 nên chi phí đọc rất nhỏ; vector nhớ sau đó qua cổng signed-sqrt rồi sigmoid tạo trọng số trong khoảng (0, 1) trước khi trộn vào 4 làn residual của mạng mHC. Vì tra bảng là bước chọn địa chỉ chứ không phải chọn mạng tính, nó khác bản chất với router chọn chuyên gia MoE; muốn thấy địa chỉ bucket in từng bước, hãy theo bước 1B của Bài Lab tổng hợp DeepSeek-V4.1-Flash.
Ví dụ đời thường: Engram giống quầy phiếu tra cứu ở thư viện: mỗi cụm từ 2–4 chữ trên chương trình được ghi lên thẻ, người thủ thư gộp mã trên thẻ thành số để tra đúng thùng phiếu, và bạn chỉ lấy phiếu ghi chú tương ứng ghép vào tài liệu đang viết chứ không đọc cả tủ. So sánh này giúp ba ý: khóa chỉ quyết định địa chỉ tra, bảng lớn nhưng mỗi lần chỉ đọc vài dòng, và phiếu phải chuẩn hóa để cùng cụm từ cùng tra đúng. Giới hạn của phép so: hai cụm từ khác nhau có thể băm về cùng một bucket nên cùng nhận một phiếu (collision), và phiếu là vector có biệt học được chứ không phải nghĩa chữ, nên không coi đây là bộ từ điển chuẩn xác.
2Luồng
Cách đọc hình (Cột 1, khối 1B ở giữa): nhận vector từ 1A đi lên, chuẩn hóa token, chặn vị trí ảnh bằng 0xDEAD = -1, băm N-gram XOR-prime tra bảng FP8 tại lớp 1 & 14 rồi nhân cổng σ(√dot) cộng vào luồng ẩn trước khi lên 2A; xem bước [1B] trong Bài Lab tổng hợp ở Tab 02.
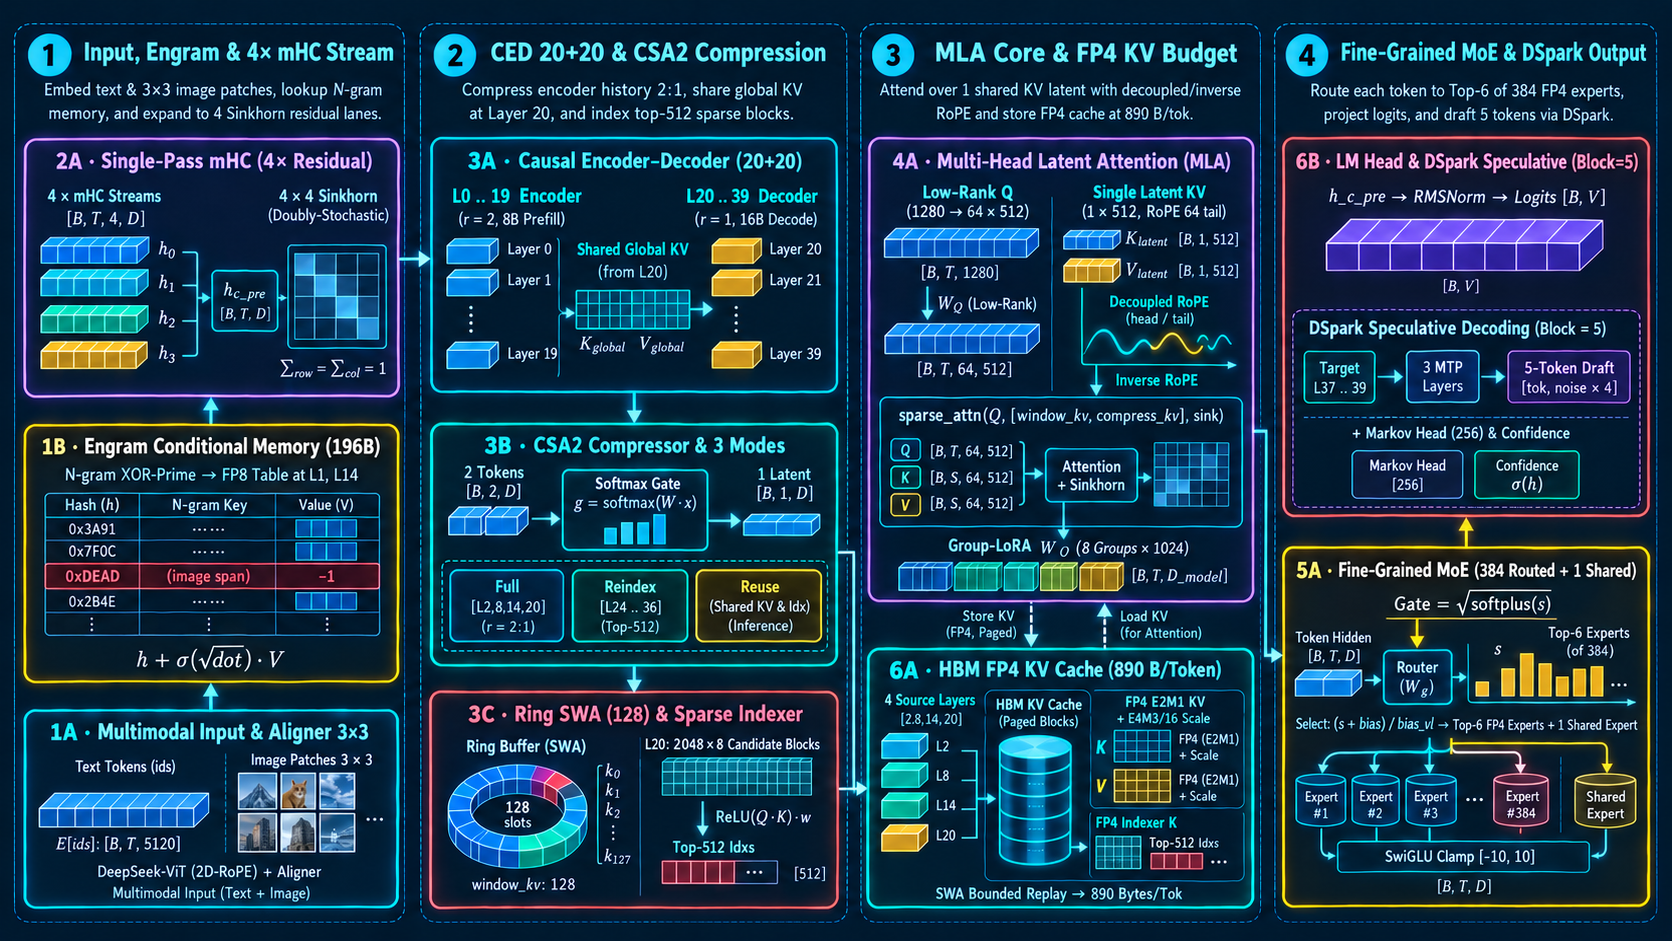
N-gram XOR-Prime → FP8 Table (L1, L14) · 0xDEAD = -1 (Image Span) · h + σ(√dot) · V1B · Engram Conditional Memory (196B)
Ở giữa Cột 1: băm các cụm N-gram qua số nguyên tố để tra bảng nhớ FP8 196B tại lớp 1 & 14; chặn vị trí ảnh bằng DEAD = -1.
Đi từ 1A lên 1B: mã token được chuẩn hóa chữ hoa/thường và khoảng trắng trước khi băm; riêng vị trí ảnh nhận mã 0xDEAD = -1 (ô màu đỏ trên hình) để không cụm n-gram nào bắc cầu qua ảnh. Tại lớp 1 và lớp 14, khóa băm XOR-prime tra trực tiếp bảng nhớ 196B tham số (lưu ở FP8), tính cổng điều tiết σ(signed_sqrt(dot)) theo từng làn rồi cộng phần tri thức tĩnh V vào luồng ẩn.
- 1B · Chuẩn hóa và tạo khóa
Mã token ra của lớp 1A được chuẩn hóa qua build_compressed_token_map, rồi lập các khóa n-gram dài 2 đến 4.
- 1B · Băm và tra bảng FP8
Băm cuộn XOR với modul nguyên tố chọn bucket trong EngramLayout; tra bảng tổng 196B tham số lưu FP8; span ảnh gắn DEAD.
- 1B · Cổng trộn vào residual
Vector nhớ qua cổng signed-sqrt rồi sigmoid, sau đó trộn vào 4 làn residual của mạng mHC.
Mã Mermaid
flowchart TD
  step1["1B · Chuẩn hóa và tạo khóa"]
  step2["1B · Băm và tra bảng FP8"]
  step3["1B · Cổng trộn vào residual"]
  step1 --> step2
step2 --> step33Giải pháp
Bài toán cần giải: ở mô hình dense, muốn nhiều tri thức phải nhiều trọng số và nhiều phép nhân mỗi token. Engram tách nhánh tri thức tĩnh ra thành bảng tra 196B tham số; vì tra theo địa chỉ từ chuỗi token nên chi phí tính mỗi token gần như phẳng theo kích thước bảng, khác cách mở dung lượng bằng MoE vẫn phải chạy mạng chuyên gia. Sau bài này, bạn cần tự kể được: khóa tạo ra sao, vì sao băm dùng số nguyên tố, vì sao span ảnh bị chặn, và vì sao cổng phải qua signed-sqrt trước khi sigmoid.
Chuẩn hóa khóa: build_compressed_token_map nhận danh sách mã token của chuỗi và ánh xạ về một bộ mã chuẩn, ví dụ ' The', 'the', 'THE' đều về chung một mã. Cơ chế này giúp cùng cụm từ tạo cùng một khóa khi xuất hiện trong các tài liệu hoặc các lượt phục vụ khác nhau, nhờ đó cùng một dòng bảng được tái sử dụng và học dồn thông tin của cụm từ. Chưa học được nghĩa của từ: bản đồ chỉ gom dạng viết của chuỗi token, không biết hai con đường cách viết khác nhau dùng một nghĩa khác nhau.
Hàm băm (hash): EngramLayout dùng băm cuộn XOR: khởi tạo h = 0; với mỗi token id tiếp theo, h = (h XOR (id × P)) mod số bucket, trong đó P là số nguyên tố và số bucket là số nguyên tố. Số nguyên tố giúp phân tán địa chỉ đều vì cấp số nhân không chia hết cho modul và không có mẫu số chung; như vậy các cụm liên tiếp không dồn về một vùng bảng. Mỗi độ dài n-gram (2, 3, 4) được băm riêng, nên cùng vị trí có thể tra nhiều độ dài một lúc; Engram chỉ tra tại lớp 1 và lớp 14 nên cống việc băm chỉ chạy tại hai lớp tra nên chi phí của nó nhỏ hơn nhiều phần tính chính của mạng.
Chặn span ảnh và kiểu số FP8: các token đặc biệt IMAGE_START, IMAGE_NEW_LINE, IMAGE_END và các vị trí ảnh bên trong span được gắn DEAD (giá trị -1), nghĩa là không tạo khóa và không tra; như vậy ảnh không được trộn phiếu tri thức văn bản, modality pha trộn trước lớp. Bảng lưu vector FP8, mỗi phần tử 8 bit; cùng số nhớ tiết kiệm 2 lần so với FP16 và 4 lần so FP32, nhưng có sai số và giới hạn khoảng giá trị, do đó giá trị tra về phải qua kiểm tra cổng trước khi dùng. Chú ý truyện kiểu số bảng thuộc hệ tra cứu, chưa đồng nghĩa rằng checkpoint chủ lưu FP8 toàn khối.
Cổng trộn signed-sqrt rồi sigmoid: vector nhớ từ bảng có biên độ học được không giới hạn; áp signed-sqrt (căn bậc hai giữ dấu) đưa biên độ về vùng trộn an toàn, sau đó sigmoid đổi thành trọng số trong khoảng (0, 1). Nếu sigmoid thẳng không qua signed-sqrt, giá trị lớn sẽ chạm gần 1 và giá trị âm sập về gần 0, nén mọi chi tiết biên độ; signed-sqrt giữ dấu và làm vùng trộn đều hơn. Trọng số này nhân với vector nhớ rồi trộn vào từng làn trong 4 làn residual của mHC, không trộng vào sublayer vì Engram hoạt động ngoài đường tính chính của sublayer.
Giới hạn và nơi quan sát: việc có bảng khổng lồ nhưng chi phí nhìn vẫn rẻ có ba hạn chế phải ghi nhận: collision khi hai cụm khác nhau cùng bucket; n-gram chỉ nhớ ngữ cảnh cục bộ gần, không thay đổi của sự tinh tế xa; và prefix cache muốn dùng lại cần đúng phiên bản bản đồ chuẩn hóa và bảng. Muốn thấy từng địa chỉ bucket và giá trị cổng in trong log, mở bước 1B của Bài Lab tổng hợp DeepSeek-V4.1-Flash; sau đó so số bucket và trọng số cổng với tính tay của bạn, rồi tiếp tục đến làn residual mHC mà Engram đã trộn vào.
4Profiling
- Parity tra cứu
Trước tiên kiểm tra tính đúng: dùng câu văn tự chọn, tính địa chỉ bucket bằng tay theo cùng cấu trúc build_compressed_token_map; so danh sách khóa, bucket và vector nhớ với log của runtime. Vector FP8 nên đối chiếu theo giá trị sau giải nén cùng cách làm tròn đã ghi. Nên kiểm tra thêm vòng collision: hai khóa khác nhau một chữ cho cùng bucket tráo cùng một dòng bảng; nếu runtime cho kết quả khác, kiểm tra bản đồ chuẩn hóa trước khi kết luận lỗi hàm băm.
- Hit rate và phân Phối trọng số cổng
Đo tỷ lệ vị trí có bản ghi tra được (hit rate) và đồ thị histogram trọng số cổng sigmoid trên một tập chữ đa dạng; cổng gần 0 hơi gần 1 nhiều khả năng khi gặp sẵn mẫu không học đầy đủ hoặc cụm từ đặc biệt. Đọc kết quả theo từng loại prompt thay vì mô tả tổng của lops ví; chưa đoxe trên tập khác thì không khẳng định phân phối này chuẩn cho việc dùng.
- Độ trễ lookup p95 và lượng đọc
Với một prompt dài cố định (ví dụ dữ liệu trên 2048 token), đo độ trễ p95 của lookup Engram và lượng dữ liệu đọc các bảng; so trực tiếp với cấu hình không Engram trên cùng một thiết bị. Số đo này phản ánh tải của tra bảng cho các thiết lập giống nhau; chưa đo từng trường hợp bật prefetch bất đồng bộ khác nhau thì chỉ nên nói như vậy, không kết luận về quá tải băng thông PCIe ngoài số đã đo.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Bước 1 · Chuẩn hóa khóa n-gram
Input: danh sách mã token tự chọn cho câu ngắn [12, 33, 12, 58], trong đó mã 33 và 58 là hai dạng của cùng một từ ('the' viết thường và viết hoa). Trước khi tính, hãy dự đoán: nếu build_compressed_token_map gom 33 và 58 về cùng một mã, còn bao nhiêu khóa n-gram riêng biệt với độ dài tối đa 4, và những khóa đó là gì? Đáp án: sau chuẩn hóa chuỗi là [12, 33, 12, 33]. Các khóa là: 2-gram (12,33), (33,12), (33,33); 3-gram (12,33,12), (33,12,33); 4-gram (12,33,12,33), tổng cộng 6 khóa riêng biệt, ít hơn trường hợp không chuẩn hóa vì khi đó (12,33,12,33) và (12,33,12,58) là hai khóa riêng, còn sau chuẩn hóa cả hai gom về một khóa. So lại với danh sách khóa trong bước 1B của [bài lab tổng hợp](/courses/deepseek-v4-1-flash/dsv41-lab/dsv41-end-to-end-lab/).
Bước 2 · Tính tay băm cuộn XOR
Ví dụ tự chọn: token id [3, 5, 8], P = 7, để dễ tính thử, ta chia dư cho modul mẫu 65. Công thức: h = (h XOR (id × P)) mod 65, khởi h = 0. Tính: id 3: id × P = 21, h1 = 0 XOR 21 = 21; id 5: id × P = 35, h2 = 21 XOR 35: 21 là 010101, 35 là 100011, XOR = 110110 = 54; id 8: id × P = 56, h3 = 54 XOR 56: 54 là 110110, 56 là 111000, XOR = 001110 = 14. Tự kiểm tra: chọn số bucket = 4 cho phép liệt kê; bucket = h mod 4: 21 → 1, 54 → 2, 14 → 2; hai khóa cuối cùng hình về cùng một bucket (collision minh họa). So trong bước 1B của [lab tổng hợp](/courses/deepseek-v4-1-flash/dsv41-lab/dsv41-end-to-end-lab/).
Tự kiểm tra · Cổng signed-sqrt rồi sigmoid
Giả sử vector nhớ được thu về giá trị biên độ 4.0 (ví dụ 1 chiều). Tính: signed-sqrt giữ dấu của 4.0 thành 2.0; sigmoid(2.0) = e^2 / (1 + e^2) = 7.389056 / 8.389056 = 0.880797. Vì vậy vector nhớ trộn vào làn residual với trọng số 0.880797. Tính lại nếu giá trị là 1.0: signed-sqrt cho 1.0, sigmoid(1.0) = 2.718282 / 3.718282 = 0.731059; so hai trường hợp để thấy signed-sqrt thu hẹp khoảng cách trọng số giữa giá trị 4.0 và 1.0 (0.880797 hợp 0.731059) so với sigmoid thẳng lại cho 0.982014 và 0.731059. Giới hạn: trọng số cổng luôn trong (0, 1) nhưng không đến tận 0 hoặc 1, do sigmoid ở số hữu hạn không đạt bằng 0 hay 1; có thể tự kiểm tra khi dự đoán số trước khi tính.
6Thuật ngữ
- N-gram key
- Khóa tra của Engram: chuỗi 2–4 token liền kề sau chuẩn hóa; mỗi vị trí trong văn bản được tra theo nhiều n-gram kết thúc tại nó.
- build_compressed_token_map
- Bảng chuẩn hóa mã token: các dạng của cùng một từ như ' The', 'the', 'THE' được gom về một mã khóa thống nhất.
- EngramLayout và băm XOR cuộn
- Cách tính địa chỉ bảng: hàm băm cuộn bằng XOR với cấp số nhân số nguyên tố, chia dư cho số bucket nguyên tố để phân tán đều.
- DEAD (-1)
- Giá trị đánh dấu vị trí không tra: các token ảnh trong span được gắn DEAD để Engram bỏ qua chúng.
- Gating signed-sqrt rồi sigmoid
- Cổng trộn vector nhớ vào residual: căn bậc hai giữ dấu nén biên độ, rồi sigmoid cho trọng số trong khoảng (0, 1).
Glossary (4)
- Lookup table
- Bảng tham số chỉ dùng để tra dòng theo khóa, không nhân ma trận như mạng thường; 196B tham số của Engram thuộc loại này.
- FP8
- Kiểu số 8 bit mỗi phần tử, tiết kiệm bộ nhớ hơn 16 bit nhưng khoảng giá trị và độ chính xác thấp hơn; Engram lưu vector nhớ theo kiểu này.
- Hash collision
- Hai khóa khác nhau băm về cùng một bucket; tra trả về cùng một dòng bảng cho cả hai, mô hình phải tự chịu trong huấn luyện.
- Prefix cache
- Cache theo phần đầu chuỗi; với Engram cần kèm phiên bản bản đồ chuẩn hóa và bảng để dùng lại đúng.