1A · Multimodal Input & Embedding
1A · Đầu vào đa phương thức · Embedding, DeepSeek-ViT và Aligner 3×3
Lớp 1A biến văn bản và ảnh thành một luồng ẩn 5120 chiều duy nhất: mã token tra bảng ParallelEmbedding, ảnh qua DeepSeek-ViT 32 lớp với 2D-RoPE rồi Aligner gộp 3×3.
1Định nghĩa
Layer 1A là cổng vào duy nhất của DeepSeek-V4.1-Flash: nhiệm vụ của nó là biến văn bản và ảnh thành cùng một loại dữ liệu, tức chuỗi vector ẩn 5120 chiều mà cả 40 lớp phía sau xử lý như một, không cần biết vị trí hiện tại đến từ ảnh hay chữ. Văn bản đi đường ngắn: mã token chỉ là số nguyên, tra trực tiếp dòng tương ứng trong bảng ParallelEmbedding. Ảnh đi đường dài: DeepSeek-ViT, bộ mã hóa ảnh 32 lớp huấn luyện từ đầu với RoPE hai chiều, gán cho mỗi patch một vector, rồi Aligner gộp chín patch bằng pixel-unshuffle 3×3 và chiếu lên cùng chiều 5120. Bài toán mà 1A giải quyết không phải nhận diện ảnh, mà là đồng nhất hai phương thức ngay lớp đầu tiên để mọi lớp sau chỉ làm việc với một dạng dữ liệu.
Về cơ chế, mã token là số nguyên, tra bảng trả về dòng 5120 số tương ứng; lưu ý mã token chỉ định danh một mục trong bảng học được, không tự mang ý nghĩa số học, như trình bày trong bài tokenizer. Với ảnh, mỗi patch được gắn vị trí hàng và cột bằng 2D-RoPE, nghĩa là một nửa thành phần vector xoay theo hàng và nửa còn lại xoay theo cột; Aligner sau đó gộp chín patch liền kề thành một token bằng pixel-unshuffle 3×3 rồi hai lớp MLP GELU chiếu lên 5120 số, nhờ đó số token ảnh giảm 9 lần. Trong chuỗi token, vị trí ảnh được đặt placeholder, và pipeline 1A ghi đè vùng này bằng IMAGE_START, IMAGE_NEW_LINE, IMAGE_END để giữ đúng dòng và cạnh ảnh, giống cách các kiến trúc đa phương thức khác ghép embedding ảnh vào dòng chữ. Luồng ẩn đồng nhất sau đó đi vào 20 lớp máy mã hóa nhân quả như mô tả trong bài kiến trúc CED; muốn tự tay chạy từng phép tính của lớp 1A, hãy theo bước 1A trong Bài Lab tổng hợp DeepSeek-V4.1-Flash.
Ví dụ đời thường: lớp 1A giống quầy phiên dịch tài liệu tại hội nghị: một trang chữ và một tấm sơ đồ đều được người phiên dịch chuyển thành cùng một loại phiếu ghi số trước khi vào phòng họp, nên trong phòng không phân biệt tài liệu nào đến từ nguồn nào. So sánh này giúp nhớ mục tiêu đồng nhất ngay từ cổng vào; giới hạn của phép so là mô hình học vector ngữ nghĩa từ dữ liệu, không dịch theo nghĩa chắc chắn như người, và mã token hay patch không tự mang giá trị số mà chỉ định danh một dòng trong bảng học được.
2Luồng
Cách đọc hình (Cột 1, khối 1A dưới cùng): bắt đầu ở 1A dưới đáy Cột 1 để nhúng token chữ E[ids] và gộp 3×3 patch ảnh từ DeepSeek-ViT (2D-RoPE) phủ đè lên vị trí ảnh, trước khi đẩy luồng vector đi lên 1B → 2A; mở bước [1A] trong Bài Lab tổng hợp DeepSeek-V4.1-Flash ở Tab 02 để tự tay kiểm tra.
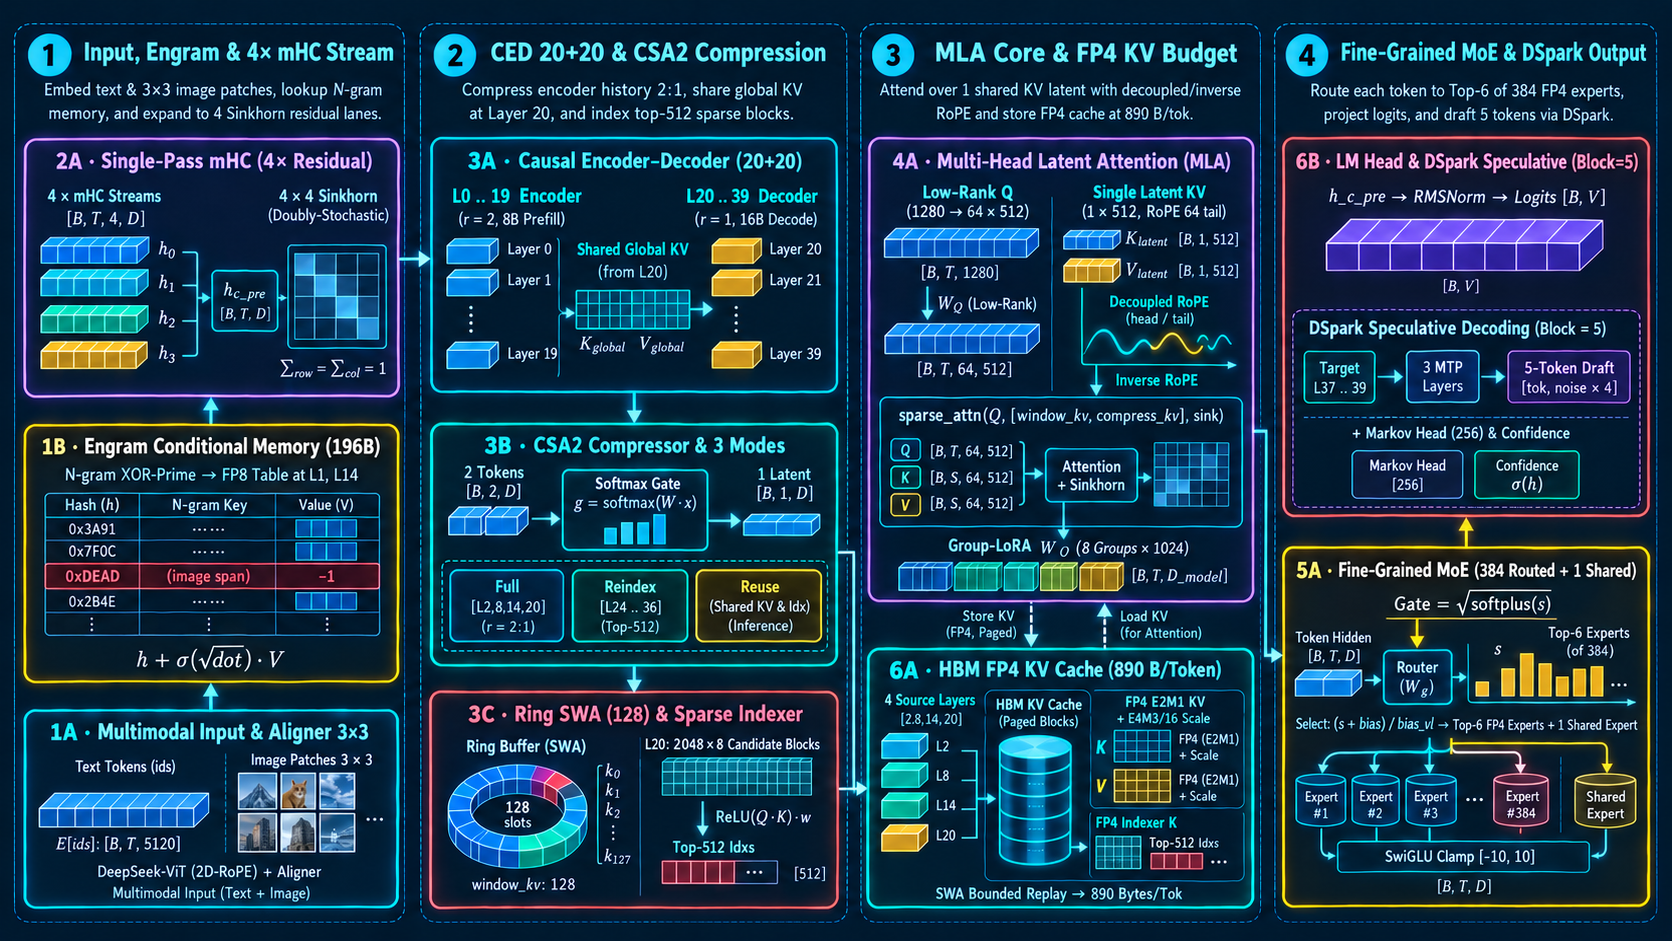
E[ids]: [B, T, 5120] · Image Patches 3×3 → DeepSeek-ViT (2D-RoPE) + Aligner → [B, N_img, 5120]1A · Multimodal Input & Aligner 3×3
Điểm xuất phát ở đáy Cột 1: nhúng token chữ E[ids] và gộp mỗi ô 3×3 patch ảnh từ DeepSeek-ViT (2D-RoPE) phủ đè vào vị trí ảnh.
Bắt đầu đọc sơ đồ từ góc dưới bên trái (1A): các token văn bản được tra bảng E[ids] thành khối vector [B, T, 5120] (ở lab là [4, 8]). Nếu đầu vào có ảnh, DeepSeek-ViT (32 lớp, xoay vị trí 2D-RoPE) mã hóa các patch rồi Aligner gộp mỗi cụm 3×3 patch thành 1 vector (giảm 9 lần số token ảnh) và ghi đè trực tiếp lên span <|deepseek_image|> trước khi đẩy luồng ẩn đi lên 1B.
- 1A · Chuẩn hóa đầu vào
Tokenizer chuyển câu chữ thành mã token; mã đó chỉ dùng để tra dòng bảng, không phải giá trị ngữ nghĩa.
- 1A · Mã hóa ảnh song song
DeepSeek-ViT tách ảnh thành lưới patch và gán vector theo vị trí 2D; Aligner gộp chín patch thành một token.
- 1A · Ghi đè spans và bàn giao
Vùng placeholder được thay bằng IMAGE_START, IMAGE_NEW_LINE, IMAGE_END; luồng ẩn đồng nhất đi vào 20 lớp máy mã hóa nhân quả.
Mã Mermaid
flowchart TD
  step1["1A · Chuẩn hóa đầu vào"]
  step2["1A · Mã hóa ảnh song song"]
  step3["1A · Ghi đè spans và bàn giao"]
  step1 --> step2
step2 --> step33Giải pháp
Bài toán cần giải: chuỗi đầu vào của mô hình đa phương thức có thể xen ảnh giữa các đoạn chữ, nhưng 552B tham số phía sau chỉ viết cho một dạng dữ liệu là vector ẩn 5120 chiều. Nếu mỗi lớp phải giữ riêng nhánh ảnh và nhánh chữ, kiến trúc phía sau phải nhân đôi và huấn luyện thêm phụ thuộc hai hệ. Lớp 1A vì vậy đóng vai khớp nối: mọi đầu vào đều ra chuỗi [B, S, 5120], với B là số mẫu trong một lô (batch), và S là tổng số vị trí sau khi mã hóa từng phương thức. Sau bài này, bạn cần tự kể được: văn bản vào đường nào, ảnh vào đường nào, vì sao phải ghi đè spans ảnh, và luồng ẩn cuối cùng có hình dạng gì.
Đường văn bản: tokenizer (xem bài tokenizer) chuyển câu chữ thành danh sách mã token, mỗi mã là một số nguyên. Mỗi số tra một dòng của bảng ParallelEmbedding có số dòng bằng lượng mã trong từ vựng và mỗi dòng 5120 số; kết quả là bảng [S_text, 5120] ghép theo đúng thứ tự câu chữ. Việc tra bảng là sao chép bit từng dòng, không nhân ma trận, nên bước kiểm tra đầu tiên là so từng dòng với tra thủ công, chưa dùng đến ngưỡng sai số của phép nhân.
Đường ảnh — DeepSeek-ViT 32 lớp: ảnh được tách thành lưới patch; mỗi patch được nối một vector và gắn vị trí bằng 2D-RoPE. Nếu bạn đã đọc RoPE một chiều xoay vector theo số thứ tự trên chuỗi, thì 2D-RoPE là bản mở rộng: một nửa chiều xoay theo hàng, nửa còn lại xoay theo cột, để phép đối chiếu giữa hai patch phản ánh cả khoảng cách hàng và cột. 32 lớp này được huấn luyện từ đầu cùng phần ngôn ngữ thay vì mượn bộ mã hóa ngoài, mục đích là vector patch sớm mang thói quen tương tác của toàn mô hình.
Đường ảnh — Aligner 3×3: pixel-unshuffle là lấy khối 3×3 patch liền kề (9 vector patch) và tái sắp thẳng thành một đoạn dài, tức 9 vị trí con của các patch gom thành 9 đơn vị nhỏ của một token mới. Bước gộp này giảm 9 lần số token ảnh đi vào chuỗi chính; sau đó hai lớp MLP với GELU chiếu đoạn dài thành một token 5120 số. Thứ tự vì vậy là: gộp 9 patch trước (giảm số token), rồi chiếu (đảm bảo chiều dữ liệu khớp với phần chữ); ảnh chỉ trở thành một hàng của S tổng.
Ghi đè spans ảnh: trong chuỗi token, vị trí ảnh được đánh dấu bằng placeholder (mã giữ chỗ); pipeline 1A ghi đè vùng này để mở màn bằng IMAGE_START, thêm IMAGE_NEW_LINE theo từng dòng patch và IMAGE_END ở cuối. Chuỗi đúng khi: không còn placeholder, số token IMAGE khớp số khối gộp và mỗi dòng ảnh có một IMAGE_NEW_LINE. Khi đọc log hay JSON của lab, ghi riêng shape [S_text, 5120] và [S_img, 5120] trước khi ghép để kiểm tra lẫn lộn hình dạng.
Giới hạn và nơi quan sát: lớp 1A khẳng định được cấu trúc đúng và giá trị tra bảng khớp, chưa chứng minh chất lượng nhận diện ảnh vì đó là việc đánh giá đa phương thức. Muốn thấy cả ba đường trên chạy chung trong một lượt, mở bước 1A của Bài Lab tổng hợp DeepSeek-V4.1-Flash: thay số patch ảnh trong ví dụ nhỏ, đối sánh luồng ẩn hai đường và so chuỗi token trước và sau ghi đè. Bài tiếp theo Engram, bộ nhớ tra cứu theo cụm từ hoạt động ngay trên chuỗi 1A này, nên cấu trúc chuỗi đúng là tiền đề của nó.
4Profiling
- Parity tra bảng ParallelEmbedding
Trước khi chú trọng phần ảnh, hãy kiểm tra tính đúng: với một danh sách mã token tự chọn, so từng dòng 5120 số của ParallelEmbedding với tra bảng thủ công; vì tra bảng là sao chép bit, sai khác tuyệt đối phải bằng 0. Đường ViT và Aligner là phép nhân với sai số dấu phẩy động, nên so hai lần chạy cùng cài đặt và ghi rõ ngưỡng sai khác đã chọn, không dùng ngưỡng của phần tra bảng cho phần nhân.
- Số token ảnh nén bởi Aligner
Đếm số token ảnh ra của pipeline so với số patch vào: với mỗi khối 3×3, tỷ lệ giữ lại là 1/9, nhưng mép ảnh có thể có padding; ghi số patch thực, số khối gộp và số IMAGE_NEW_LINE. Sai khác với tỷ lệ 1/9 thuần túy thường đến từ padding mép hoặc số khối gộp thực khác với tỷ lệ lý thuyết, hoặc ảnh nhỏ chưa đủ một khối; khi đó quay lại kiểm tra cấu trúc spans trước, không kết luận lỗi cơ chế.
- Chi phí prefill khi có ảnh
Giữ cùng prompt chữ, thêm ảnh và đo thời gian đến token đầu (TTFT) lặp nhiều lần lấy trung bình cùng cấu hình; số đo phản ánh phần chạy thêm của ViT 32 lớp và Aligner cùng lượng token ảnh tăng S. Chỉ so sánh khi thiết bị, dtype và batch cùng nhau, và chưa tuyên bố mức tăng tốc nào ngoài số đã đo được.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Bước 1 · Dự đoán cấu trúc chuỗi token spans
Input: một ảnh 48 patch (6 cột × 4 hàng) đặt giữa hai câu chữ. Trước khi tính, hãy dự đoán: số token ảnh ra của Aligner, số IMAGE_NEW_LINE, và vị trí IMAGE_START so với token chữ cuối trước ảnh. Cách quan sát: bước 1A của [bài lab tổng hợp](/courses/deepseek-v4-1-flash/dsv41-lab/dsv41-end-to-end-lab/) in danh sách token trước và sau ghi đè; so với dự đoán của bạn. Lưu ý ảnh 6×4 chỉ là kích thước ví dụ để dễ tính, không phải cấu hình ảnh thật của checkpoint.
Bước 2 · Tính tay một Aligner thu nhỏ
Dùng 9 vector patch 2 số tự chọn: [1,0], [0,1], [1,1], [2,1], [1,2], [0,0], [3,1], [1,3], [2,2]. Thiết lập thu nhỏ: một lớp MLP 18→4 với trọng số 0.1 cho mọi cặp đầu vào–đầu ra, sau lớp GELU, rồi lớp 4→2 với trọng số 0.25 cho mọi cặp. Dự đoán trước: vì trọng số đối xứng, bốn neuron ẩn có bằng nhau không? Tính: pixel-unshuffle chỉ tái sắp chuỗi, tổng 18 số = 11 + 11 = 22; mỗi neuron ẩn = 0.1 × 22 = 2.2; GELU(2.2) ≈ 2.2 × Φ(2.2) ≈ 2.16940 (ghi cách làm tròn). Lớp 2: mỗi đầu ra = 4 × 0.25 × 2.16940 = 2.16940, token ra là [2.16940, 2.16940]. Tự kiểm tra: đổi một patch thành [9,9] thì tổng tăng 16, neuron ẩn thành 3.8, đầu ra tăng theo tương tự; vì GELU gần tuyến tính ở giá trị lớn, ví dụ này nằm ở vùng gần tuyến tính, không thể khép từ đó về MLP thật của Aligner.
Tự kiểm tra · Token ảnh trong luồng và shape cuối
Với ảnh 6×4 patch ở Bước 1: các khối 3×3 còn 2 khối × 2 hàng = 4 token ảnh; mỗi hàng patch kết thúc bằng một IMAGE_NEW_LINE, nên có 4 dấu dòng, một IMAGE_START và một IMAGE_END. S = S_text + 4 token ảnh + 6 token IMAGE. So với chuỗi chỉ chữ: S tăng đúng số token ảnh gộp và token IMAGE, không tăng theo số patch 48. Bạn có thể đối chiếu trong bước 1A của lab và xem shape cuối [B, S, 5120]. Giới hạn: nếu danh sách IMAGE_NEW_LINE lệch với số hàng ảnh, kiểm tra thứ tự gộp theo hàng và cột trước khi gọi là lỗi cơ chế hoặc lỗi tính toán.
6Thuật ngữ
- ParallelEmbedding
- Bảng tra mã token dùng chung cho văn bản và ảnh: mã token là số nguyên, tra trả về dòng 5120 số tương ứng.
- DeepSeek-ViT
- Bộ mã hóa ảnh 32 lớp huấn luyện từ đầu cùng phần ngôn ngữ, gắn vị trí patch bằng RoPE hai chiều (hàng, cột).
- Aligner
- Module gộp 9 patch ảnh liền kề thành 1 token bằng pixel-unshuffle 3×3, rồi hai lớp MLP GELU chiếu lên chiều ẩn 5120.
- Spans ảnh và token IMAGE
- Vùng placeholder trong chuỗi token được ghi đè bằng IMAGE_START, IMAGE_NEW_LINE, IMAGE_END để giữ cấu trúc dòng ảnh.
Glossary (4)
- Vector ẩn 5120 chiều
- Danh sách 5120 số mô tả một vị trí trong chuỗi; các lớp phía sau chủ yếu đổi hình dạng danh sách này chứ không đổi số chiều.
- Patch ảnh
- Mảnh chữ nhật nhỏ của ảnh; bộ mã hóa ảnh xử lý patch tương tự cách tokenizer xử lý từng phần từ.
- GELU
- Hàm kích hoạt mềm, gần trục x cho giá trị âm nhỏ và gần đồng nhất cho giá trị lớn; dùng trong MLP của Aligner.
- Placeholder
- Mã token đặc biệt chỉ dùng để giữ chỗ trong chuỗi; pipeline 1A ghi đè vùng này, không có lớp nào tra nghĩa của nó.