Giới thiệu khóa học
DeepSeek-V4.1-Flash: đi theo một token qua toàn bộ đường suy luận của mô hình
DeepSeek-V4.1-Flash là một mô hình ngôn ngữ lớn nhận cả chữ lẫn ảnh và sinh ra văn bản, từng token một (token là một mẩu chữ hoặc một mảnh ảnh đã được đổi thành số để mạng xử lý). Khóa học tách mô hình thành 10 khối đánh mã từ 1A đến 6B để bạn thấy mỗi khối nhận dữ liệu gì, biến đổi nó ra sao và vì sao cần biến đổi như vậy.
Bài toán chung của mô hình cỡ này là chi phí. Phần lõi có 552 tỷ tham số (552B; tham số là các con số cấu thành mô hình), và khi đọc ngữ cảnh dài tới 1 triệu token, mô hình phải nhớ thông tin của mọi token đã đọc trong bộ nhớ đệm KV (Key–Value cache: các vector ghi chú giúp attention, bước mà mỗi token nhìn lại các token đứng trước, khỏi phải tính lại). DeepSeek-V4.1-Flash dùng nhiều thủ thuật kiến trúc để giữ bộ nhớ đệm này ở mức 890 byte cho mỗi token; đọc từng thủ thuật là cách học một mô hình hiện đại tiết kiệm bộ nhớ và tính toán như thế nào.
Khóa học gồm
- Đầu vào và bộ nhớ (1A, 1B): chữ và ảnh cùng được đổi thành một chuỗi vector (dãy số mô tả một token); Engram là bảng tra cứu tri thức dựng sẵn, bổ sung thông tin cho lớp 1 và lớp 14.
- Luồng thông tin (2A, 3A): mHC (Multi-stream Hyper-Connections) chạy 4 làn residual song song rồi trộn lại; 40 lớp được chia thành 20 lớp Encoder và 20 lớp Decoder dùng chung một bộ KV.
- Tiết kiệm bộ nhớ KV (3B, 3C, 6A): nén mỗi cặp 2 token thành 1 vector, chọn lại đúng 512 vị trí cần nhìn, và lưu KV ở định dạng FP4 (số thực 4 bit) để tổng chỉ còn 890 byte mỗi token.
- Attention và chuyên gia (4A, 5A): MLA (Multi-head Latent Attention) dùng chung một vector K/V cho nhiều Q head; MoE (Mixture of Experts) chỉ đánh thức 6 trong 384 chuyên gia định tuyến (mỗi chuyên gia là một mạng con) cùng 1 chuyên gia chung luôn bật cho mỗi token.
- Đầu ra (6B): LM Head đổi vector cuối thành điểm cho từng token trong từ vựng, và DSpark vẽ nháp 5 token cùng lúc để sinh nhanh hơn.
- Một bài lab NumPy tổng hợp (Tab 02) chạy cả 10 khối ở kích thước thu nhỏ và in từng bảng số.
Học xong, bạn có thể
- Chỉ vào một khối bất kỳ trên sơ đồ và nói nó nhận tensor nào, biến đổi gì, trả ra gì.
- Giải thích vì sao mô hình phân biệt prefill (đọc cả prompt một lượt, khoảng 8B tham số hoạt động cho mỗi token) với decode (sinh từng token mới, khoảng 16B).
- Giải thích vì sao bộ nhớ đệm KV chỉ cần 890 byte mỗi token: chỉ 4 lớp nguồn (2, 8, 14, 20) lưu KV, các lớp khác đọc lại.
- Giải thích cổng MoE: chọn chuyên gia theo điểm cộng bias nhưng nhân kết quả theo điểm thô chưa cộng bias.
- Đọc được ký hiệu hình dạng tensor như [B, T, 5120] trên sơ đồ.
Phạm vi: khóa học chỉ dạy kiến trúc và đường suy luận (forward: đưa đầu vào qua mạng để ra token) của DeepSeek-V4.1-Flash, không dạy cách huấn luyện; trọng số chỉ được nhắc đến như những con số mô hình học được khi huấn luyện, và bài lab dùng trọng số ngẫu nhiên chưa huấn luyện. Muốn học huấn luyện, hãy xem khóa LLM Training (Text), nhưng khóa đó chỉ dạy mô hình văn bản; huấn luyện mô hình đa phương thức như mô hình này chưa được dạy ở bất kỳ khóa nào trên site.
Cách đọc sơ đồ kiến trúc
- Bắt đầu ở 1A, góc dưới của Cột 1, rồi đi lên theo mũi tên: 1A (đầu vào chữ và ảnh) → 1B (Engram) → 2A (4 làn mHC). Cột 1 đọc từ dưới lên, ngược với thói quen đọc từ trên xuống.
- Sang Cột 2 và đọc từ trên xuống: 3A (chia lớp Encoder và Decoder) → 3B (nén KV) → 3C (chọn vị trí cần nhìn). Cột này chuẩn bị KV và chỉ mục cho khối 4A ở Cột 3.
- Ở Cột 3, 4A (attention) nằm trên và 6A (bộ nhớ KV 890 byte mỗi token) nằm dưới; mũi tên hai chiều giữa chúng là lưu KV vào bộ nhớ và nạp KV ra để attention dùng.
- Cột 4 đọc từ dưới lên: 5A (MoE) → 6B (LM Head và DSpark). Thứ tự cột là thứ tự đọc; trong thực tế các khối từ 2A đến 5A lặp lại ở nhiều lớp, và một số khối chỉ chạy ở lớp được chỉ định (ví dụ Engram ở lớp 1 và 14).
- Rê chuột vào một khung để mở pop-over giải thích khối đó; bấm để mở bài học, hoặc bấm liên kết trong pop-over để chạy khối đó trong lab. Các nút Trọng tâm (Prefill, Decode, KV và Memory, mHC và MoE Routing) làm nổi các khối liên quan; nút −, + và Vừa khung điều chỉnh cỡ ảnh.
- Nút Tắt overlay cạnh Vừa khung ẩn các khung vuông và pop-over để bạn đọc ảnh kiến trúc gốc; bấm lại để bật overlay.
Ký hiệu như [B, T, 5120] liệt kê các trục của tensor: B là số chuỗi chạy cùng lúc, T là số token và 5120 là số chiều của vector mô tả mỗi token.
Cột 1 & Cột 2 (1A → 3C) · Đầu vào, 4× mHC, CED 20+20 & Nén CSA2
Cột 3 & Cột 4 (4A → 6B) · MLA Core, Trụ FP4 KV 890B, MoE & DSpark
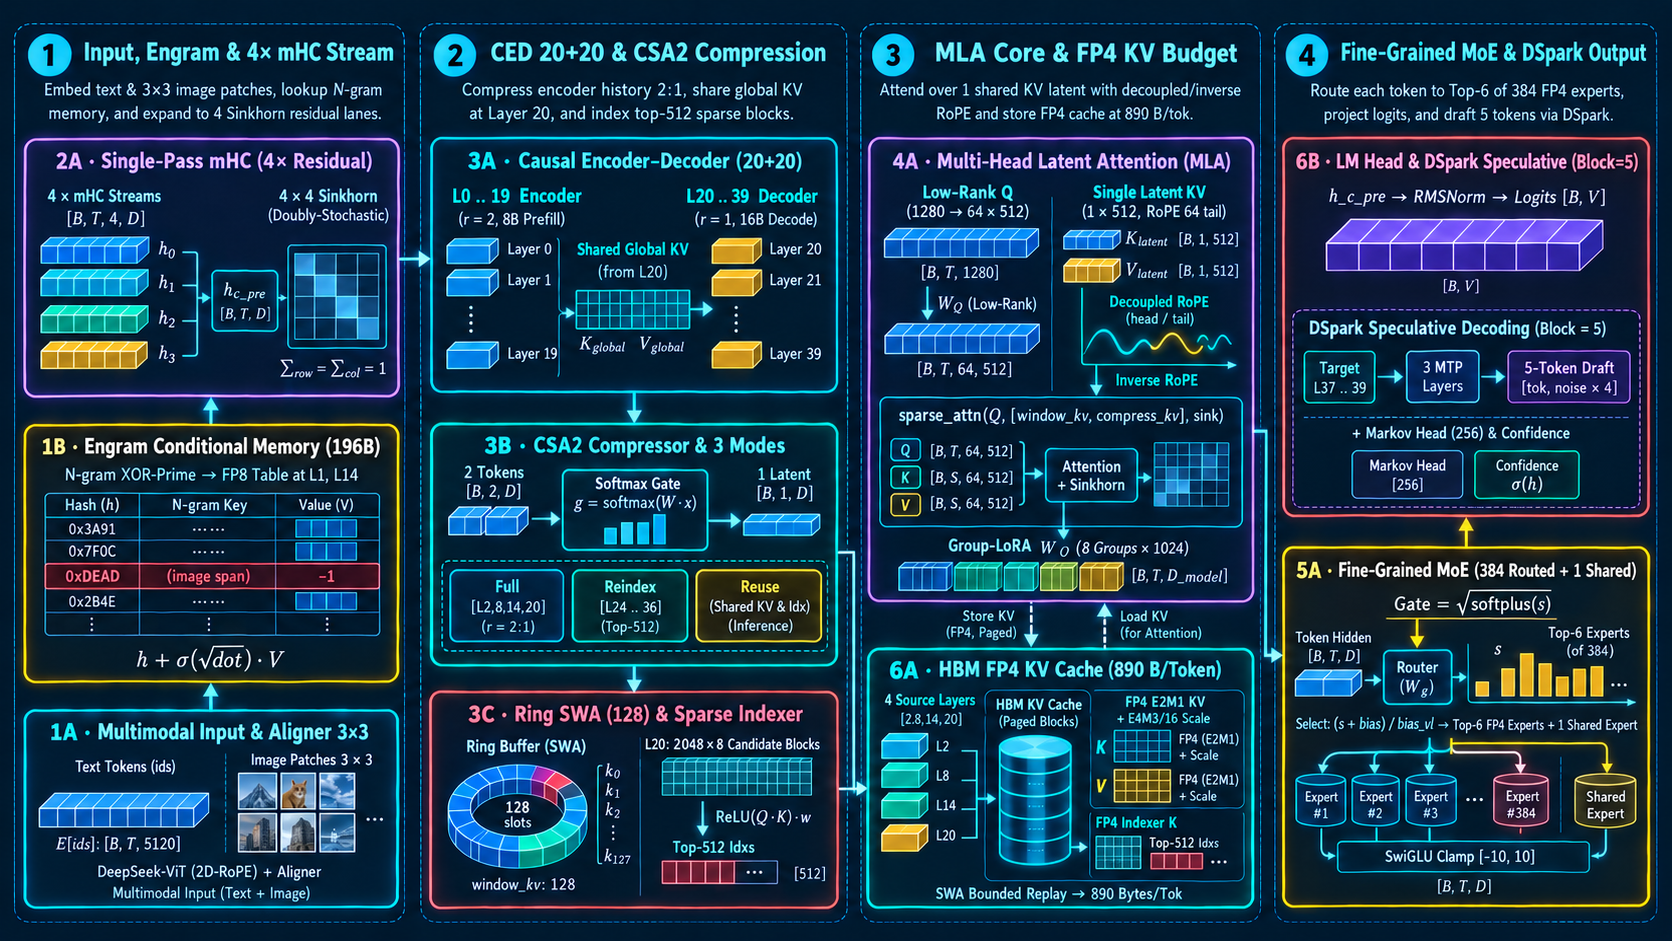
Cách đọc sơ đồ 4 cột dọc (Dataflow Graph)
Khác với sơ đồ phân tầng phần cứng, sơ đồ model đi theo 4 cột biến đổi tensor: ở Cột 1 đi từ đáy lên (1A → 1B → 2A); sang Cột 2 đi từ đỉnh xuống (3A → 3B → 3C) để cấp KV và chỉ mục cho 4A ở Cột 3 (nối hai chiều Store/Load với trụ bộ nhớ HBM 6A bên dưới); cuối cùng sang Cột 4 đi từ mạng chuyên gia 5A ở dưới lên đầu ra 6B (LM Head + DSpark).
Thực hành toàn trình trong một bài Lab duy nhất (Tab 02)
Toàn bộ 10 bài học ở Tab 01 không tách lab rời mà hội tụ về đúng 1 bài Lab NumPy chạy trực tiếp trong trình duyệt ở Tab 02, in ra từng bảng số từ [1A] đến [6B]. Mở Tab 02 · Bài Lab tổng hợp ↗
Nguồn công bố & mã nguồn tham chiếu
Danh sách bài học (10)
- 1A · Đầu vào đa phương thức · Embedding, DeepSeek-ViT và Aligner 3×3
- 1B · Bộ nhớ có điều kiện Engram · Tra cứu bảng băm N-gram 196B
- 2A · Single-Pass mHC · 4 làn Residual song song và chuẩn hóa Sinkhorn
- 3A · Kiến trúc CED 20+20 · Khối mã hóa nhân quả và KV toàn cục dùng chung
- 3B · Compressed Sparse Attention 2 · Nén gộp token và 3 chế độ Full, Reindex, Reuse
- 3C · Cửa sổ trượt vòng (Ring SWA) và Bộ chọn chỉ mục phân cấp (Hierarchical Indexer)
- 4A · Multi-head Latent Attention · latent K/V dùng chung, RoPE nửa sau và W_O nhóm
- 5A · MoE fine-grained · tách vai trò chọn và nhân ở cổng chuyên gia
- 6A · Ngân sách KV FP4 · 890 bytes mỗi token
- 6B · LM head và DSpark · vẽ token nháp trước khi verify