2A · Multi-stream Residual
2A · Single-Pass mHC · 4 làn Residual song song và chuẩn hóa Sinkhorn
Single-Pass mHC mở rộng residual thành 4 làn mỗi làn 5120 chiều: hc_pre gộp 4 làn cho sublayer, hc_mixes dự đoán pha trộn cho lớp kế, Sinkhorn 20 vòng giữ comb 4×4 cân bằng dòng và cột.
1Định nghĩa
Single-Pass mHC (Multi-stream Hyper-Connections) là cách DeepSeek-V4.1-Flash tổ chức đường residual, là bước 2A: thay vì một làn residual duy nhất cộng y = x + F(x) như trong bài residual, mạng mở rộng thành hc_mult = 4 làn song song có hình [B, S, 4, 5120], với B là số mẫu lô, S là chiều dài chuỗi, 5120 là chiều ẩn. Bài toán nó giải quyết là hạn chế của một làn duy nhất khi mạng sâu: nhiều làn cho các lớp sau nhiều kênh thông tin rõ ràng hơn, còn chuẩn hóa Sinkhorn trên ma trận trộn giữ khối lượng tín hiệu trên từng làn không phóng đại cũng không cạn dần.
Về cơ chế, trước mỗi sublayer, hc_pre gộp 4 làn thành một vector 5120 để sublayer Attention hoặc MoE làm việc như một đầu vào thông thường; sau sublayer, hc_post trộn đầu ra trở lại 4 làn bằng ma trận comb 4×4. Cả hc_pre, hc_post và pha trộn cho lớp kế đều do hc_mixes dự đoán trong cùng một lượt forward, đó là ý của chữ Single-Pass: không cần chạy thêm một sublayer riêng cho việc trộn. Comb qua Sinkhorn-Knopp lặp 20 vòng: chia từng dòng cho tổng dòng, rồi chia từng cột cho tổng cột, lặp lại; kết quả là ma trận không âm có tổng mỗi dòng và tổng mỗi cột bằng 1, tức doubly stochastic. Cơ chế này là phần mở rộng đường residual mà bài residual mHC nhắc ở mức tổng quan; bạn có thể xem comb sau từng vòng trong bước 2A của Bài Lab tổng hợp DeepSeek-V4.1-Flash.
Ví dụ đời thường: mHC giống bàn trộn âm thanh bốn kênh. Trước đoạn trình diễn, bộ gộp (hc_pre) tạo một tín hiệu mở từ bốn kênh cho nghệ sĩ chính; sau đó, bộ chia lại (hc_post) nhận kết quả và phân về bốn kênh tiếp tục lưu; bảng ghi chú (hc_mixes) dự đoán cách trộn cho đoạn kế để bàn điều khiển kịp chuẩn bị. Điều đặc biệt: các con số trộn được ràng buộc có tổng theo dòng và theo cột bằng 1, nên âm lượng không nổ khi kênh nhận quá nhiều và không cạn khi kênh bị hụt. Giới hạn của phép so: mô hình không có người nghe điều khiển; ma trận trộn là tham số học được, và Sinkhorn chỉ là vòng lặp phép chia, đảm bảo tổng các dòng và các cột đều bằng 1.
2Luồng
Cách đọc hình (Cột 1, khối 2A trên đỉnh): tách luồng ẩn thành 4 làn song song h_0..h_3 [B, T, 4, D], gộp hc_pre làm đầu vào lớp con và trộn lại qua ma trận vuông Sinkhorn 4×4 (∑row = ∑col = 1) trước khi chuyển sang Cột 2; xem bước [2A] trong Bài Lab tổng hợp ở Tab 02.
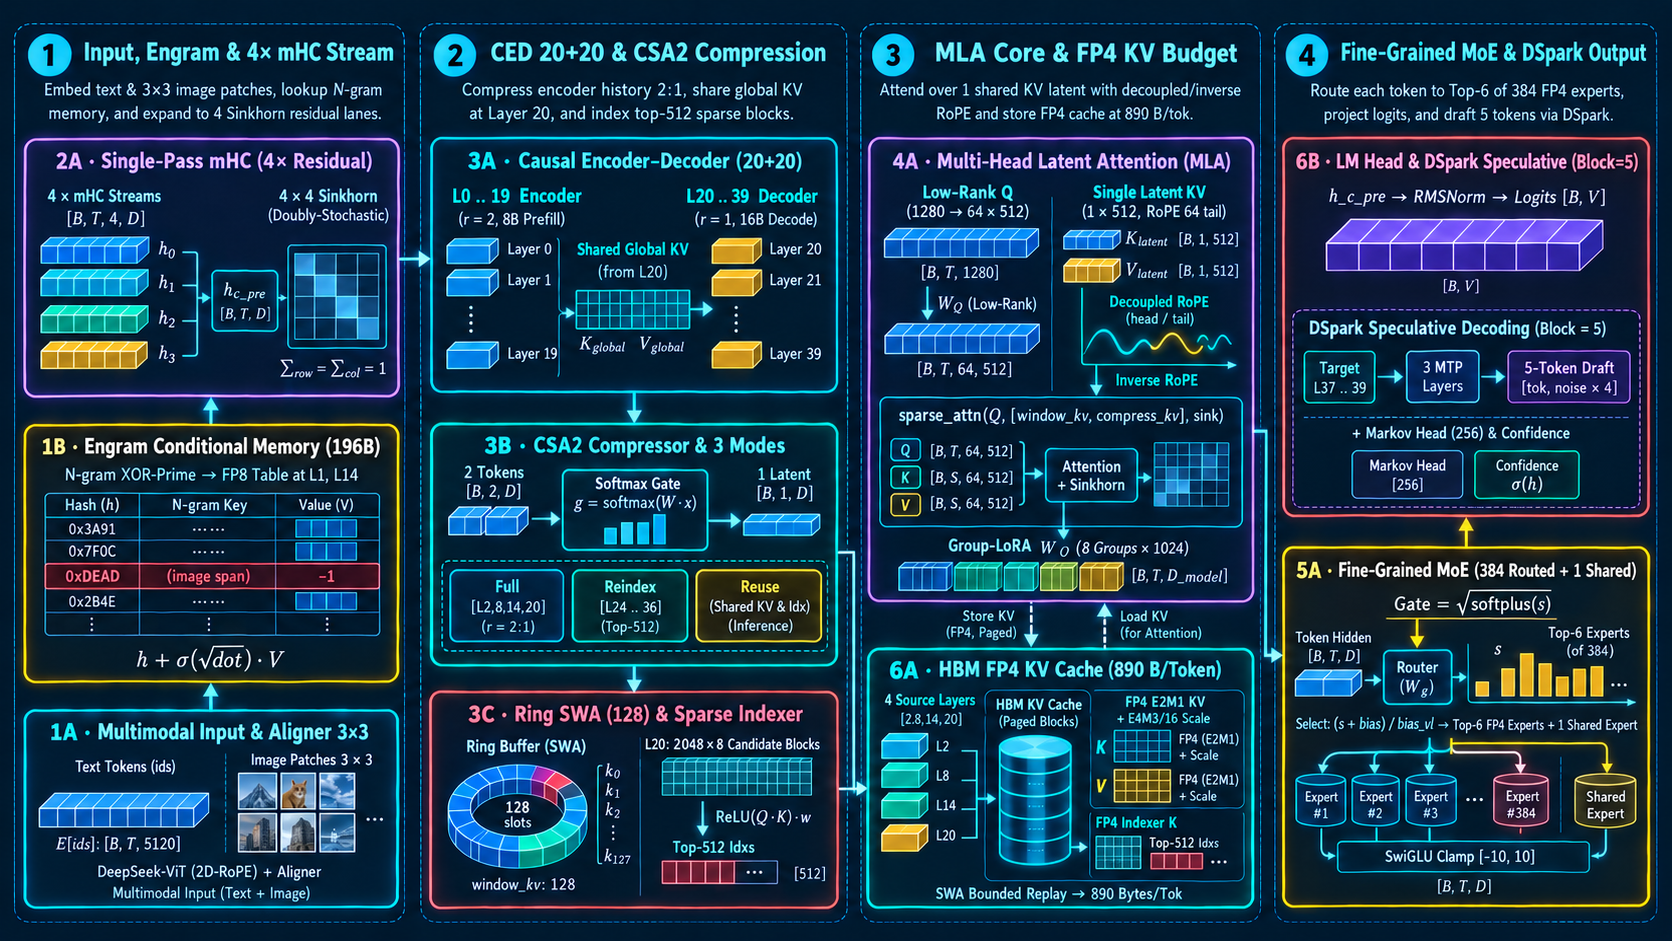
4× mHC Streams h_0..h_3 [B, T, 4, D] → hc_pre [B, T, D] → 4×4 Sinkhorn (∑row = ∑col = 1)2A · Single-Pass mHC (4× Residual)
Ở đỉnh Cột 1: tách luồng residual thành 4 làn song song h_0..h_3, gộp hc_pre trước lớp con và trộn qua ma trận Sinkhorn 4×4.
Trên đỉnh Cột 1, trạng thái ẩn được nhân thành 4 làn residual song song h_0..h_3 có shape [B, T, 4, D]. Trước khi đi vào nhánh Attention (hoặc MoE), phép hc_pre gộp 4 làn về 1 vector [B, T, D] bằng trọng số do nhánh trước tính sẵn. Sau khi lớp con xử lý xong, hc_post trộn lại 4 làn qua ma trận vuông 4×4 đã chạy 20 vòng lặp Sinkhorn để tổng mỗi hàng và mỗi cột đều bằng 1.
- 2A · Mở rộng làn và gộp hc_pre
Trạng thái ẩn mở rộng từ [B, S, 5120] thành [B, S, 4, 5120]; hc_pre gộp 4 làn thành một vector cho sublayer.
- 2A · Sublayer Attention hoặc MoE
Vector gộp 5120 được đưa qua sublayer Attention hoặc MoE như một đầu vào thông thường.
- 2A · hc_post trộn lại và hc_mixes cho lớp kế
Đầu ra sublayer trộn trở lại 4 làn qua comb 4×4 đã chuẩn Sinkhorn; hc_mixes dự đoán ba bản pha trộn cho lớp kế.
Mã Mermaid
flowchart TD
  step1["2A · Mở rộng làn và gộp hc_pre"]
  step2["2A · Sublayer Attention hoặc MoE"]
  step3["2A · hc_post trộn lại và hc_mixes cho lớp kế"]
  step1 --> step2
step2 --> step33Giải pháp
Bài toán cần giải: với một làn residual duy nhất, mọi lớp cùng đọc và ghi đúng một tập 5120 số, nên lớp sâu có thể chèn thông tin mới đè lên thông tin cũ, và lớp sau khó chọn kênh phù hợp. mHC nhân rộng đường cộng thành 4 làn; mỗi sublayer vẫn chỉ nhận một bản gộp, nhưng việc ghi kết quả phân phối về 4 làn theo ma trận học được. Sau bài này, bạn cần tự kể được: hình dạng trạng thái ẩn sau mở rộng, hc_pre đóng vai gì, comb 4×4 đóng vai gì, và vì sao Sinkhorn phải chuẩn hóa cả dòng và cột.
Mở rộng trạng thái và hc_pre: trạng thái ẩn [B, S, 5120] được mở rộng thành [B, S, 4, 5120]. Chú ý: đây không phải sao chép 4 bản giống nhau, mà là phép chiếu học được, nên bốn làn mang thông tin hơi khác nhau. hc_pre đọc 4 làn và gộp thành một vector 5120 cho sublayer; sublayer không cần biết phía trên có 4 làn hay một làn, chỉ có một vector đầu vào chuẩn. Vì ba bản pha trộn đều được tính trong cùng pass này, chi phí tổng của mHC không tăng đáng kể so với cách chạy nhiều sublayer thêm.
hc_post và comb 4×4: sau sublayer, kết quả không được ghi về một làn duy nhất. hc_post trộn kết quả vào 4 làn bằng ma trận comb 4×4: phần tử (i, j) cho biết bao nhiêu tín hiệu từ làn j được đưa vào làn i sau sublayer. Comb là tham số học được, và mỗi vị trí trong chuỗi có một comb riêng; hình dạng lưu là [B, S, 4, 4]. Comb chỉ có 16 phần tử, nên nhỏ và cập nhật nhanh.
hc_mixes dự đoán ba bản pha trộn: single-pass có nghĩa hc_mixes là một mạng phụ nhỏ học từ dữ liệu, dự đoán ngay trong cùng lượt forward: bản hc_pre và hc_post cho sublayer kế, và ma trận comb cho sublayer kế. Ba đầu ra có hình dạng [B, S, 4, 5120], [B, S, 4, 5120], và [B, S, 4, 4]. Nghĩa là ba bản pha trộn không cần một lượt tính thứ hai, giúp giảm cả thời gian của mHC.
Sinkhorn-Knopp 20 vòng trên comb: comb khởi tạo bằng tham số học chưa đảm bảo các dòng và các cột đều bằng 1. Vì vậy Sinkhorn chạy 20 vòng, mỗi vòng chia từng dòng cho tổng dòng, rồi chia từng cột cho tổng cột. Mục đích là bảo toàn khối lượng: nếu tổng dòng lớn hơn 1, làn nhận tổng nhiều hơn khối lượng nguồn; nếu nhỏ hơn 1, làn bị hụt thông tin. Với cả hai chiều đều bằng 1, các làn giữ năng lượng ổn định qua 40 lớp; đây là ràng buộc bù cho phép học của các ma trận trộn.
Giới hạn và nơi quan sát: mHC có chi phí tính: bộ nhớ activation tăng do 4 làn và hc_mixes, cộng thêm vòng lặp Sinkhorn 20 lần trên ma trận nhỏ 4×4. Lợi ích chất lượng phải đo bằng đánh giá chất lượng, chưa phải nội dung của bài này. Muốn thấy comb sau từng vòng in ra, mở bước 2A của Bài Lab tổng hợp DeepSeek-V4.1-Flash; kiểm tra tổng dòng và tổng cột của comb sau vòng 20 gần 1, sau đó đến mạng chuyên gia MoE vì sublayer MoE cũng chỉ nhận một tín hiệu hc_pre gộp.
4Profiling
- Parity Sinkhorn sau 20 vòng
Kiểm tra tính đúng trước: cho comb một ma trận ví dụ [[3, 1], [1, 1]], tính thủ công hai vòng: một vòng chuẩn hóa dòng, rồi một vòng chuẩn hóa cột; so với kết quả runtime sau mỗi vòng. Sau 20 vòng, tổng dòng và tổng cột phải gần 1 trong ngưỡng đã chọn (ví dụ 1e-6 với float64); không bù dư bằng phép cộng hiệu chỉnh hậu kỳ.
- Chi phí bộ nhớ activation của 4 làn
Đo riêng phần bộ nhớ activation do mHC tạo ra: 4 làn [B, S, 4, 5120] chiếm 4 lần dữ liệu so với một làn [B, S, 5120], cộng thêm các đầu ra của hc_pre, hc_post, hc_mixes. Ghi theo số token và lô; so với checkpoint không mHC để tách phần tăng, chưa khẳng định về tổng bộ nhớ của checkpoint weights.
- Thời gian chạy kernel Mega-mHC
Mega-mHC là hàm tính thực hiện hc_pre, hc_post và Sinkhorn; đo thời gian tách riêng với attention và MoE trên cùng thiết bị, cùng dtype, cùng lô. Chưa đo công bố về tốc độ; nếu muốn hiệu suất, chỉ so khi các điều kiện này giống nhau.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Bước 1 · Dự đoán kết quả Sinkhorn trong ma trận 2×2
Ví dụ nhỏ: comb 2×2 được khởi tạo [[3, 1], [1, 1]]. Trước khi tính, hãy dự đoán: sau vài vòng chuẩn hóa dòng rồi cột, ma trận này sẽ tiệm cận giá trị nào? Có thể in ma trận sau mỗi vòng trong bước 2A của [bài lab tổng hợp](/courses/deepseek-v4-1-flash/dsv41-lab/dsv41-end-to-end-lab/); đáp án cụ thể ở Bước 2 và mục Tự kiểm tra.
Bước 2 · Tính hai vòng Sinkhorn trên [[3, 1], [1, 1]]
Vòng 1 dòng: dòng 0 chia tổng 4 thành [0.75, 0.25]; dòng 1 chia tổng 2 thành [0.5, 0.5]. Vòng 1 cột: cột 0 = 0.75 + 0.5 = 1.25, chia từng phần → [0.6, 0.4]; cột 1 = 0.25 + 0.5 = 0.75, chia → [0.333333, 0.666667]. Ma trận sau vòng 1: [[0.6, 0.333333], [0.4, 0.666667]]. Vòng 2 dòng: dòng 0 = 0.6 + 0.333333 = 0.933333, chia thành [0.642857, 0.357143]; dòng 1 = 0.4 + 0.666667 = 1.066667, chia thành [0.375, 0.625]. Vòng 2 cột: cột 0 = 0.642857 + 0.375 = 1.017857, chia → [0.631702, 0.368298]; cột 1 = 0.357143 + 0.625 = 0.982143, chia → [0.363636, 0.636364]. Sau vòng 2: [[0.631702, 0.363636], [0.368298, 0.636364]]. Tiếp 18 vòng thì tiệm cận [[0.633975, 0.366025], [0.366025, 0.633975]]; so đúng số sau 20 vòng trong bước 2A của lab.
Tự kiểm tra · Độ chuẩn hóa doubly stochastic
Đề: sau 20 vòng Sinkhorn, ma trận gần [[0.633975, 0.366025], [0.366025, 0.633975]]. Trước khi kiểm, hãy dự đoán tổng dòng và tổng cột của ma trận này? Dòng 0 = 0.633975 + 0.366025 = 1; dòng 1 = 0.366025 + 0.633975 = 1; cột 0 = 0.633975 + 0.366025 = 1; cột 1 = 0.366025 + 0.633975 = 1. Kết quả: đúng, tổng mỗi dòng và mỗi cột bằng 1, là tính doubly stochastic. Lưu ý: ma trận ban đầu [[3, 1], [1, 1]] có tổng dòng 4 và 2, chưa bằng 1; Sinkhorn chuẩn hóa dần dần. Các con số bên trên là kết quả tính tay theo trình tự; để kiểm số thật sau 20 vòng, so lại bằng bước 2A của lab với ngưỡng mà bạn chọn trước.
6Thuật ngữ
- hc_mult và 4 làn residual
- Số làn residual song song (hc_mult = 4): trạng thái ẩn mở rộng thành [B, S, 4, 5120], mỗi làn là một dòng thông tin đi suốt mạng.
- hc_pre, hc_post, hc_mixes
- hc_pre gộp 4 làn thành một vector cho sublayer; hc_post trộn đầu ra sublayer trở lại 4 làn; hc_mixes dự đoán ba bản pha trộn cho sublayer kế.
- Sinkhorn-Knopp (20 vòng)
- Thuật toán chuẩn hóa dòng rồi cột của ma trận comb 4×4, lặp 20 lần cho đến khi mỗi dòng và mỗi cột có tổng bằng 1 (doubly stochastic).
- Single-Pass
- Một lượt forward tính đủ ba bản pha trộn cho sublayer kế, không cần chạy thêm một sublayer riêng cho việc trộn.
Glossary (4)
- Residual stream
- Đường cộng tắt thông tin đi xuyên suốt mạng; mỗi lớp vừa đọc vừa cộng bổ sung theo cách của riêng mình.
- Doubly stochastic
- Ma trận không âm mà tổng mỗi dòng và tổng mỗi cột bằng 1; bảo toàn tổng khối lượng tín hiệu được trộn.
- Sublayer
- Khối nhỏ của một lớp Transformer, ví dụ Attention hoặc MoE; mHC bao quanh từng sublayer.
- Activation memory
- Bộ nhớ giữ các giá trị trung gian giữa các bước tính; tăng theo batch, chiều dài chuỗi và số làn residual.