Lab tổng hợp · 1A → 6B
Lab tổng hợp Qwen-Image-2.1 — chạy toàn trình 1A → 6B bằng NumPy
Chạy toàn trình kiến trúc Qwen-Image-2.1 bằng NumPy thuần: nén RGBA VAE, mở rộng 4× slot, 3D RoPE, điều biến t=0, mặt nạ Block-Causal, tái sử dụng Prefix KV Cache và vòng lặp Euler.
1Định nghĩa
Bài học này là lab thực hành tổng hợp duy nhất của khóa Qwen-Image-2.1 Architecture, kết nối toàn bộ mười khối kiến trúc 1A đến 6B trên sơ đồ 4 cột thành một vòng lặp khử nhiễu Flow-Matching chạy trực tiếp bằng NumPy trong trình duyệt. Thay vì học rời rạc từng công thức, bạn sẽ theo dõi cùng một chuỗi 11 token ghép (7 token Prefix gồm chữ và ảnh điều kiện cộng 4 token ảnh đích) đi từ bước chuẩn hóa RGBA 64-Channel VAE và mở rộng 4× slot ảnh cho tới lúc giải mã ra 4 kênh R, G, B, Alpha.
Trọng tâm kỹ thuật của bài lab là chứng minh bằng số thật vì sao một mô hình Diffusion Transformer có thể tái sử dụng bộ nhớ đệm giống như LLM: nhờ điều biến nhân quả giữ Prefix ở t = 0 kết hợp với mặt nạ Block-Causal 11×11 chặn ảnh đích rò rỉ ngược về phía trước, toàn bộ Key và Value của 7 token Prefix được trích xuất ở bước đầu tiên trong Prefix KV Cache và dùng lại nguyên vẹn ở các bước Euler tiếp theo với sai lệch chỉ ở mức 2.22e-16.
Ví dụ đời thường: Quy trình của lab giống như một xưởng vẽ tranh minh họa nhiều lớp trên giấy kính trong suốt: ở bước đầu tiên (Step 1 extract), họa sĩ đọc kỹ đề bài và bức ảnh mẫu rồi ghim cố định tấm phác thảo tham chiếu lên bảng sáng (Prefix KV Cache tại t = 0); trong suốt các lượt tô màu và tinh chỉnh chi tiết tiếp theo (Steps 2..3 cached), họa sĩ chỉ việc vẽ đè lên tờ giấy kính của bức tranh đích mà không bao giờ phải chép lại đề bài hay vẽ lại tấm ảnh mẫu nữa. Phép so sánh này dừng lại ở chỗ mọi bước trong mô hình đều là phép nhân ma trận tất định trên số dấu phẩy động chứ không có người quan sát bằng mắt.
2Luồng
Cách đọc hình 4 cột: bắt đầu ở 1A dưới đáy Cột 1 đi lên 1B → 2A; sang Cột 2 đi từ 3A → 3B → 3C để cấp tọa độ 3D RoPE, hệ số điều biến t=0 và mặt nạ Block-Causal cho 4A ở nửa trên Cột 3 (nối hai chiều Extract/Cached với trụ bộ nhớ Prefix KV Cache 6A ở nửa dưới Cột 3); sau đó sang Cột 4 từ mạng SwiGLU 5A ở dưới đi lên đầu ra 6B (Scale-Only AdaLN + Euler → RGBA). Mọi số liệu bên dưới lấy nguyên văn từ qwen-image-21.py (seed 21).
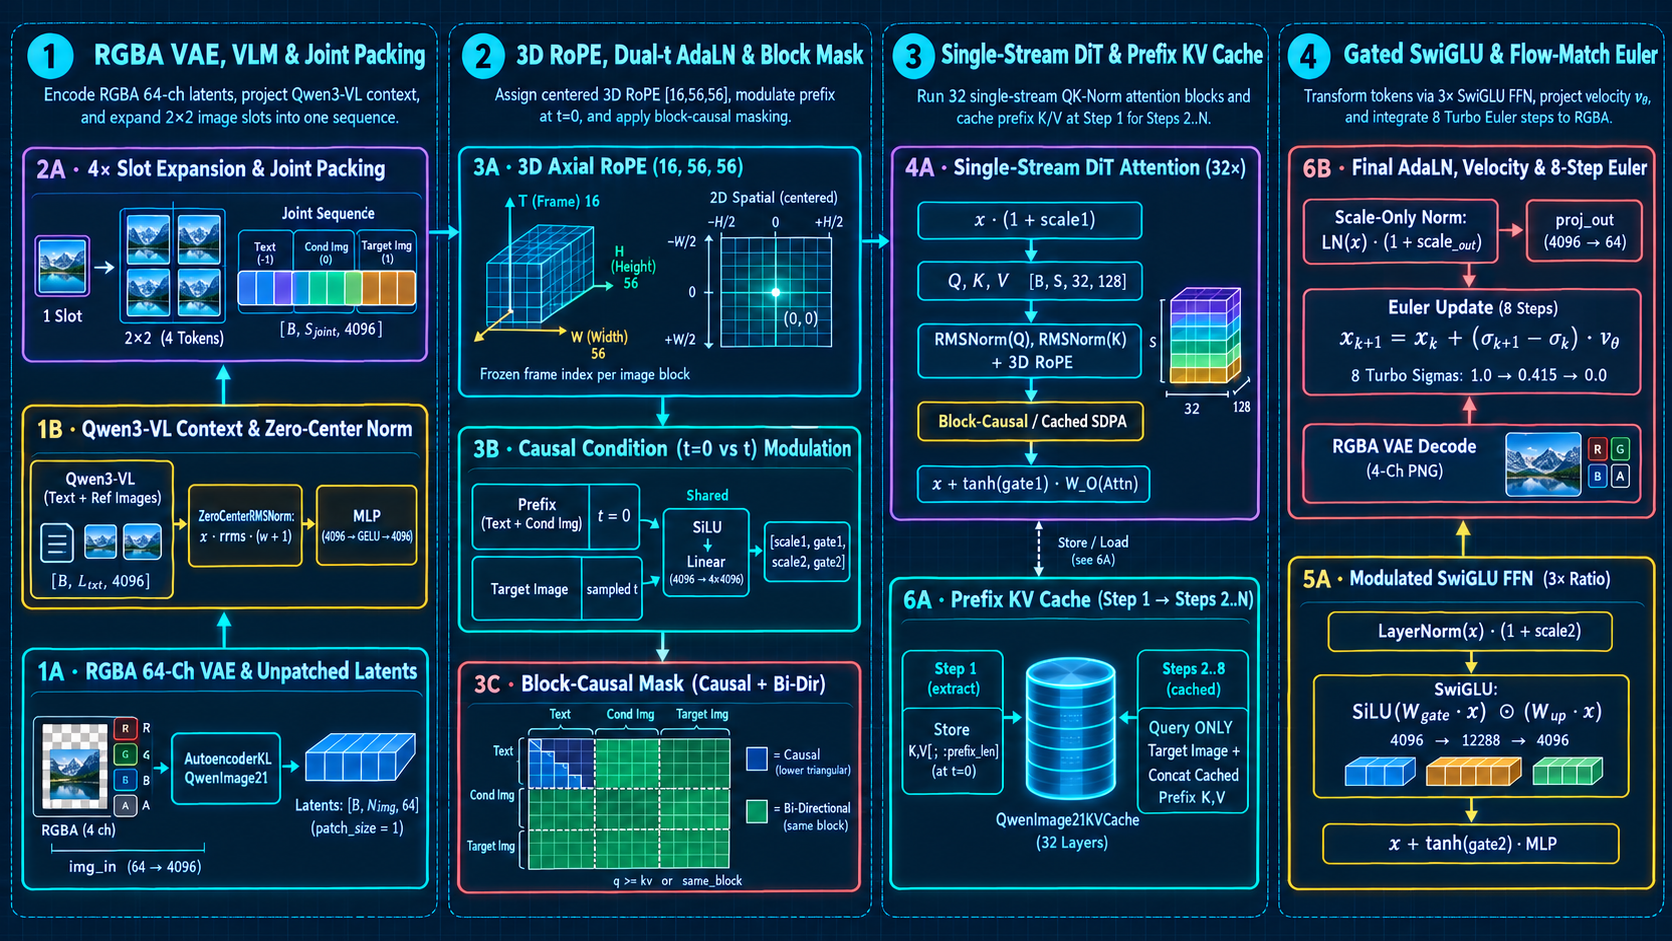
RGBA [B, 4, H, W] → AutoencoderKLQwenImage21 → ẑ = (z − mean)/std ∈ [B, N_img, 64] (patch_size=1) → img_in(64 → 4096)1A · RGBA 64-Ch VAE & Unpatched Latents
Biến ảnh thành token mà Transformer đọc được: VAE nén ảnh RGBA thành một lưới latent nhỏ, mỗi ô có 64 kênh, rồi mỗi ô được chiếu thành một token 4096 chiều.
- Mục đích
- Transformer không thể xử lý trực tiếp hàng triệu điểm ảnh. Bước này nén ảnh xuống một lưới gọn nhưng vẫn giữ đủ thông tin, kể cả kênh trong suốt Alpha, để cuối pipeline (6B) giải nén lại thành ảnh.
- Đầu vào
- Ảnh tham chiếu 4 kênh R, G, B, Alpha có dạng [B, 4, H, W]. Ảnh đích không đi qua encoder: nó bắt đầu là nhiễu ngẫu nhiên tạo thẳng trên lưới latent cùng kích thước.
- Đầu ra
- Mỗi ảnh thành N_img token 4096 chiều (1 ô latent = 1 token vì patch_size = 1), sau khi chuẩn hóa từng kênh (z − mean) / std và chiếu img_in 64 → 4096. Các token này được lắp vào chuỗi chung ở 2A.
Bắt đầu đọc sơ đồ từ góc dưới bên trái (1A): AutoencoderKLQwenImage21 nhận ảnh 4 kênh R, G, B, Alpha và nén thành các vector latent 64 kênh. Trước khi đi vào mạng DiT, mỗi kênh được chuẩn hóa theo thống kê riêng ẑ = (z − latents_mean) / latents_std rồi chiếu thẳng qua img_in (64 → 4096) với patch_size = 1 (không gộp ô 2×2 tại đây) để bảo toàn chi tiết biên trong suốt.
- 1A–1B · Chuẩn hóa RGBA Latents & Ngữ cảnh Qwen3-VL
Chuẩn hóa 4 pixel RGBA qua (z - mean)/std → img_in; chuẩn hóa ngữ cảnh VLM bằng Zero-Center RMSNorm (w + 1) → txt_in GELU MLP.
- 2A · Mở rộng 4× Slot ảnh & Đóng gói chuỗi 11 token
Dùng repeats = [1, 1, 4, 1] bung slot ảnh VLM thành 4 vị trí và nối 4 token ảnh đích tạo chuỗi S_joint = 11.
- 3A–3C · 3D RoPE tâm không, Điều biến t=0 & Mask 11×11
Ghim frame = 0 và căn tâm [-1..0] cho lưới ảnh 2×2; gán hàng t = 0.0 cho Prefix và dựng mặt nạ Block-Causal 11×11.
- 4A · Single-Stream DiT Attention & QK-RMSNorm
Điều biến LN(x)·(1+scale1)+shift1, chiếu Q/K/V chung một luồng, chuẩn hóa QK-RMSNorm từng head, xoay 3D RoPE và cổng tanh(gate1).
- 5A · Modulated SwiGLU FFN (3× Ratio) & Cổng Tanh
Mở rộng chiều ẩn 8 → 24 → 8 với SiLU(W_gate x) ⊙ (W_up x) và cộng residual qua cổng tanh(gate2).
- 6A–6B · Prefix KV Cache & Vòng lặp Euler → RGBA
Trích K/V (7, 2, 4) ở Step 1, chỉ tính 4 token target ở Steps 2–3, cập nhật Euler 3 bước và giải mã ra ảnh RGBA 2×2×4.
Mã Mermaid
flowchart TD
  step1["1A–1B · Chuẩn hóa RGBA Latents #amp; Ngữ cảnh Qwen3-VL"]
  step2["2A · Mở rộng 4× Slot ảnh #amp; Đóng gói chuỗi 11 token"]
  step3["3A–3C · 3D RoPE tâm không, Điều biến t=0 #amp; Mask 11×11"]
  step4["4A · Single-Stream DiT Attention #amp; QK-RMSNorm"]
  step5["5A · Modulated SwiGLU FFN (3× Ratio) #amp; Cổng Tanh"]
  step6["6A–6B · Prefix KV Cache #amp; Vòng lặp Euler → RGBA"]
  step1 --> step2
  step2 --> step3
  step3 --> step4
  step4 --> step5
step5 --> step63Giải pháp
Mục tiêu thực hành: sau khi đọc 10 bài giải phẫu ở Tab 01, bài lab này giúp bạn tự tay kiểm chứng toàn bộ dây chuyền số học của Qwen-Image-2.1 trên một cấu hình thu nhỏ tất định (seed 21, DIM = 8, 2 lớp, 2 head × 4 chiều, lưới ảnh 2×2 × 4 kênh RGBA). Không cần GPU hay thư viện ngoài: mỗi khối in ra bảng số trung gian để bạn đối chiếu trực tiếp với công thức trên sơ đồ.
Ở Cột 1 (1A → 1B → 2A), script chuẩn hóa 4 pixel ảnh điều kiện theo từng kênh z = (z − mean) / std rồi chiếu qua img_in (PATCH_SIZE = 1, giữ nguyên 4 vị trí). Chuỗi ngữ cảnh VLM gồm 4 slot [text, text, COND_IMG, text] đi qua Zero-Center RMSNorm nhân với (w + 1); sau đó bước 2A dùng repeats = [1, 1, 4, 1] bung slot ảnh thành 4 token và nối thêm 4 token nhiễu của ảnh đích, tạo thành chuỗi ghép S_joint = 11 token với image_ids = [-1, -1, 0, 0, 0, 0, -1, 1, 1, 1, 1].
Ở Cột 2 (3A → 3B → 3C), bạn sẽ thấy rõ hai thiết kế giữ cho Prefix bất biến theo thời gian: tại 3A, 3 token chữ tăng dần tọa độ (0,0,0) → (1,1,1) → (2,2,2) trong khi cả hai khối ảnh 2×2 đều ghim frame = 0 và dùng lưới tâm không [(-1,-1), (-1,0), (0,-1), (0,0)]; tại 3B, bảng điều biến có 2 hàng [t_step, 0.0] nên 7 token Prefix luôn đọc đúng hàng t = 0.0 (lệch 0.00e+00 giữa Step 1 ở t=1000 và Step 2 ở t=850); và tại 3C, ma trận mặt nạ 11×11 cho phép khối ảnh 2..5 nhìn nhau song hướng (6 khóa hợp lệ mỗi hàng) nhưng chặn tuyệt đối không cho đọc 4 token ảnh đích ở 7..10.
Ở Cột 3 và Cột 4 (4A → 5A → 6A → 6B), Step 1 (sigma = 1.0, mode = extract) chạy cả 11 token qua 2 lớp Single-Stream DiT (QK-RMSNorm, 3D RoPE, cổng tanh(gate1), SwiGLU 8 → 24 → 8, cổng tanh(gate2)) và lưu cached_k, cached_v có shape (7, 2, 4). Sang Step 2 (sigma = 0.85) và Step 3 (sigma = 0.45) ở chế độ cached, mạng chỉ chiếu Q, K, V cho đúng 4 token ảnh đích (shape 4, 2, 4) rồi nối với cache (7, 2, 4) thành (11, 2, 4). Cuối mỗi bước, Scale-Only Final AdaLN nhân (1 + scale_final) không có shift, chiếu ra vận tốc v_theta để cập nhật Euler x_{k+1} = x_k + (sigma_{k+1} − sigma_k) · v_theta trước khi giải mã về ảnh RGBA 2×2×4.
Giới hạn của kết luận: ba phép kiểm chứng cuối bài xác nhận tính tương đương số học giữa đường dùng Prefix KV Cache và đường tính lại toàn chuỗi (sai lệch 2.22e-16 đến 4.44e-16 < 1e-9), chứng minh nếu tắt t = 0 trên Prefix thì cache bị trôi ngay 9.61e-01 đến 1.68e+00, và xác nhận tính cô lập một chiều từ Prefix sang Target. Tuy nhiên, vì trọng số được khởi tạo ngẫu nhiên với seed 21 và chưa qua huấn luyện, bức ảnh RGBA 2×2 đầu ra chỉ dùng để kiểm tra đường đi của tensor chứ không mang nội dung thị giác thật hay số đo tốc độ GPU.
4Profiling
- Kiểm tra tính đúng đắn của Prefix KV Cache trước khi bàn về tốc độ
Luôn chạy đối chiếu hai đường trên cùng hạt giống ngẫu nhiên (seed 21): đường 1 dùng kv_cache_mode = extract ở bước đầu và cached ở các bước sau; đường 2 tính lại toàn bộ 11 token ở mọi bước Euler. Sai lệch tuyệt đối tối đa trên trường vận tốc v_theta (2.22e-16 ở bước 2, 4.44e-16 ở bước 3) và trên ảnh RGBA cuối (1.11e-16) phải nằm dưới ngưỡng 1e-9.
- Kiểm tra điều kiện bất biến thời gian (t = 0) trên Prefix
Thử nghiệm đối chứng bằng cách đặt causal_condition = False (tức bắt 7 token Prefix đọc hàng t_step thay vì hàng t = 0.0): đo độ lệch giữa cached_k ở Step 1 (t = 1000) và K của Prefix tính lại ở Step 2 (t = 850). Độ lệch vọt lên 9.61e-01 ở lớp 0 và 1.68e+00 ở lớp 1 chứng minh Prefix KV Cache chỉ hợp lệ khi Prefix được điều biến cố định ở t = 0.
- Tỷ lệ tiết kiệm số token phải tính ở các bước Cached
Đếm số lượng token phải đi qua phép chiếu Q/K/V và mạng SwiGLU FFN ở mỗi bước: ở Step 1 (extract) là S_joint = prefix_len + target_len (11 token trong lab); ở mỗi bước Steps 2..N (cached) chỉ còn đúng target_len (4 token trong lab, giảm 7/11 ≈ 63.6% số token phải tính mỗi bước). Khi có tới 10 ảnh tham chiếu trên thực tế, tỷ lệ prefix_len / S_joint càng lớn thì phần tính toán tiết kiệm được ở các bước 2..N càng cao.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Bước 1 · Đọc bản đồ mở rộng 4× slot và lưới 3D RoPE ở [2A] & [3A]
Chạy lab và quan sát mục [2A]: từ 4 slot VLM ban đầu với repeats = [1, 1, 4, 1], slot ảnh ở vị trí 2 bung thành 4 vị trí liên tiếp (chỉ số 2, 3, 4, 5 có image_id = 0), nối thêm 4 vị trí ảnh đích ở cuối (chỉ số 7, 8, 9, 10 có image_id = 1). Sang mục [3A], hãy kiểm tra tọa độ của 3 token chữ ở pos 0, 1, 6: chúng tăng lên (0,0,0) → (1,1,1) → (2,2,2), trong khi cả hai khối ảnh 2..5 và 7..10 đều có cùng bộ tọa độ không gian [(-1,-1), (-1,0), (0,-1), (0,0)].
Bước 2 · Kiểm tra ma trận mặt nạ Block-Causal 11×11 ở [3C]
Nhìn vào bảng 11×11 ở mục [3C]: các hàng văn bản q = 0, 1, 6 có lần lượt 1, 2 và 7 khóa hợp lệ (tăng bậc thang tam giác dưới). Nhưng ở bốn hàng của ảnh điều kiện q = 2, 3, 4, 5, cả bốn hàng đều có đúng 6 khóa hợp lệ (nhìn thấy 2 token chữ đầu tiên và nhìn thấy toàn bộ 4 vị trí 2..5 của chính bức ảnh đó). Tự kiểm tra: vì sao hàng q = 2 lại nhìn được cột kv = 5 đứng sau nó? Đáp án: vì cả hai cùng có image_id = 0 >= 0 nên thỏa điều kiện same_image_block.
Bước 3 · Đối chiếu phép kiểm chứng Prefix KV Cache ở cuối output
Ở mục [6A] và [KIỂM TRA & THỬ NGHIỆM], kiểm tra shape của cached_k ở cả hai lớp là (7, 2, 4): 7 vị trí Prefix, 2 head, mỗi head 4 số. Khi chạy sang bước 2 và bước 3, mạng chỉ tính target_k có shape (4, 2, 4) rồi ghép thành k_full (11, 2, 4). Đọc 3 kết luận PASS ở cuối output để thấy cả 3 điều kiện (tương đương số học 1e-16, chống trôi nhờ t = 0 và cô lập nhân quả 0.00e+00) đều được xác nhận trên số thật.
6Thuật ngữ
- Chuỗi ghép S_joint = 11 (Prefix 7 + Target 4)
- Gồm 2 token chữ đầu, 4 token của ảnh điều kiện 2×2 (bung 4× từ 1 slot VLM), 1 token chữ cuối (tổng 7 token Prefix) và 4 token của ảnh đích 2×2 đang khử nhiễu.
- image_ids = [-1, -1, 0, 0, 0, 0, -1, 1, 1, 1, 1]
- Nhãn phân biệt phương thức trên chuỗi ghép: -1 là văn bản (chỉ nhìn nhân quả), 0 là ảnh điều kiện thứ nhất, 1 là ảnh đích (các token cùng mã >= 0 nhìn nhau song hướng).
- Bảng điều biến hai hàng [t_step, 0.0]
- Khi bật causal_condition, hàng 0 mang hệ số của bước nhiễu hiện tại t_step cho 4 token ảnh đích, còn hàng 1 giữ cố định mốc t = 0.0 cho 7 token Prefix.
- kv_cache_mode: extract vs cached
- Ở bước Euler đầu tiên (extract), mạng chạy đủ 11 token và lưu bản sao K, V của 7 token Prefix; ở các bước sau (cached), mạng chỉ chạy 4 token ảnh đích và nối K, V đã lưu.
Glossary (4)
- Unpatched Latents (patch_size = 1)
- Đưa trực tiếp từng vector latent 64 kênh của VAE vào Linear(64 → 4096) mà không gộp ô 2×2 tại tầng đầu vào của DiT.
- Zero-Center RMSNorm (w + 1)
- Biến thể RMSNorm lưu tham số học được quanh điểm 0 và cộng thêm 1 khi nhân: x · rsqrt(mean(x²) + ε) · (w + 1).
- Scale-Only Final AdaLN
- Tầng chuẩn hóa cuối cùng chỉ điều biến biên độ LN(x) · (1 + scale_out) mà không cộng độ dịch shift.
- Flow-Matching Euler Update
- Công thức bước nhảy thẳng theo trường vận tốc dự đoán: x_{k+1} = x_k + (σ_{k+1} − σ_k) · v_θ(x_k, σ_k).
7Bài liên quan
8Nguồn
9Bài lab
Chạy thử toàn bộ kiến trúc Qwen-Image-2.1 (1A → 6B) bằng NumPy
Thực hành NumPy · giải phẫu toàn trình Qwen-Image-2.1 (1A–6B)Đây là bài Lab tổng hợp duy nhất của khóa học: một script NumPy chạy toàn trình từ chuẩn hóa ảnh RGBA (1A), ghép chuỗi 11 token (2A), 3D RoPE và mặt nạ Block-Causal (3A–3C) đến tái sử dụng Prefix KV Cache qua 3 bước khử nhiễu Euler (4A–6B). Hãy đọc hướng dẫn từng mục rồi bấm Chạy để đối chiếu các bảng số.
Bạn sẽ học được gì?
Sau bài lab này, bạn sẽ giải thích được bằng số cụ thể 5 cơ chế cốt lõi của Qwen-Image-2.1: (1) cách chuẩn hóa latent 4 kênh RGBA trước khi vào mạng; (2) cách bung 1 slot ảnh VLM thành 4 token lưới 2×2 trong chuỗi ghép 11 token; (3) vì sao tọa độ 3D RoPE của mỗi bức ảnh lại căn tâm quanh (0, 0); (4) vì sao mặt nạ Block-Causal kết hợp điều biến t = 0 giúp K/V của Prefix không đổi theo bước nhiễu; và (5) cách trích xuất rồi tái sử dụng Prefix KV Cache qua vòng lặp Euler.
Mỗi khối in ra từ [1A] đến [6B] trong màn hình kết quả khớp 1:1 với 10 khối trên sơ đồ 4 cột ở phía trên và 10 bài học ở Tab 01.
Đầu vào và cấu hình thu nhỏ của bài lab
Đầu vào gồm 1 ảnh điều kiện 2×2 × 4 kênh RGBA, 1 chuỗi ngữ cảnh VLM 4 slot [text, text, COND_IMG, text], và lưới nhiễu khởi tạo 2×2 × 4 của ảnh đích. Lịch khử nhiễu gồm 3 bước Euler: TURBO_SIGMAS = (1.0, 0.85, 0.45, 0.0).
Cấu hình thu nhỏ giữ nguyên cấu trúc của bản 7B thật: DIM = 8 (bản thật 4096), 2 head × 4 chiều (bản thật 32 × 128), RoPE 3 trục (2, 1, 1) (bản thật 16, 56, 56), SwiGLU tỷ lệ 3× (8 → 24 → 8), 2 lớp Single-Stream DiT (bản thật 32 lớp), seed cố định 21.
Bảng ánh xạ 1:1 giữa Sơ đồ Kiến trúc (Tab 1) và Code Lab (Tab 2)
Cột 1: [1A] chuẩn hóa (z - mean)/std và chiếu img_in (PATCH_SIZE = 1); [1B] chuẩn hóa Zero-Center RMSNorm nhân (w + 1) và txt_in GELU MLP; [2A] nhân bản slot ảnh 4× với repeats = [1, 1, 4, 1] tạo chuỗi joint (11, 8) gồm 7 prefix + 4 target.
Cột 2–4: [3A] tính tọa độ 3D RoPE tâm không; [3B] lập bảng điều biến 2 hàng [t_step, 0.0]; [3C] dựng mặt nạ Block-Causal 11×11; [4A] chạy Single-Stream Attention có QK-RMSNorm; [5A] chạy Modulated SwiGLU 3×; [6A] lưu và nối QwenImage21KVCache (7, 2, 4); [6B] chạy Scale-Only Final AdaLN và 3 bước Euler ra ảnh RGBA 2×2×4.
Cách thực hiện và đọc từng khối output 1A–6B
1. Bấm nút Chạy cell. Ở [1A]–[2A], kiểm tra bản đồ image_ids = [-1, -1, 0, 0, 0, 0, -1, 1, 1, 1, 1] và target_token_mask có đúng 7 chữ F (Prefix) đi trước 4 chữ T (Target).
2. Ở [3A]–[3C], đối chiếu tọa độ (f, h, w) của hai khối ảnh (đều ghim f = 0 và căn tâm -1..0), xem hàng 1 (t = 0.0) ở [3B] giữ nguyên giữa t = 1000 và t = 850 (lệch 0.00e+00), và đếm số khóa hợp lệ trên từng hàng của ma trận 11×11 ở [3C].
3. Ở [4A]–[6B] và [KIỂM TRA & THỬ NGHIỆM], quan sát cached_k shape (7, 2, 4) ở Step 1 được ghép với target_k (4, 2, 4) ở Steps 2–3, rồi đọc 3 phép kiểm chứng tự động ở cuối output.
Kết quả này chứng tỏ điều gì và giới hạn ở đâu?
Ba phép kiểm chứng ở cuối output chứng minh: (1) dùng lại Prefix KV Cache ở Steps 2–3 cho ra vận tốc v_theta và ảnh RGBA cuối khớp tuyệt đối với tính lại toàn bộ 11 token (sai lệch 2.22e-16 đến 4.44e-16, nhỏ hơn ngưỡng 1e-9); (2) nếu bỏ điều kiện t = 0 trên Prefix thì K của Prefix bị trôi ngay 9.61e-01 đến 1.68e+00; và (3) mặt nạ Block-Causal vừa giữ tính song hướng trong từng ảnh vừa ngăn ảnh đích rò rỉ ngược về Prefix (0.00e+00).
Giới hạn: trọng số trong lab là số ngẫu nhiên (seed 21) chưa huấn luyện nên các giá trị RGBA cuối chỉ chứng minh tính đúng đắn của luồng toán học và cơ chế bộ nhớ đệm, không dùng để đánh giá chất lượng hình ảnh hay đo tốc độ phần cứng GPU.
Kết quả mong đợiOutput chia làm 10 khối [1A]..[6B] và [KIỂM TRA & THỬ NGHIỆM]. Mốc kiểm tra nhanh: chuỗi ghép S_joint = 11 (prefix 7 + target 4); ma trận mask 11×11; cached_k shape (7, 2, 4); sai lệch giữa cached và recompute là 2.22e-16 / 4.44e-16 (< 1e-9); và 3 kết luận PASS ở cuối.
Bài tập 1 · Điều gì xảy ra nếu Prefix không được ghim ở mốc thời gian t = 0?
Trước khi đọc phần cuối output, hãy dự đoán: nếu ở bước 3B ta tắt causal_condition (tức 7 token Prefix cũng nhận hệ số điều biến từ t_step = 1000 ở Step 1 và t_step = 850 ở Step 2), thì cached_k lưu ở Step 1 có còn khớp với K của Prefix ở Step 2 không? Đối chiếu với kiểm chứng (2) trong mục [KIỂM TRA & THỬ NGHIỆM].
Đối chiếu sau khi tự trả lời
Không còn khớp: kiểm chứng (2) cho thấy khi Prefix đọc hàng t_step, vector K của 7 token Prefix ở Step 2 (t = 850) bị lệch tới 9.61e-01 ở lớp 0 và 1.68e+00 ở lớp 1 so với bản lưu ở Step 1 (t = 1000). Nhờ ghim Prefix ở t = 0.0, hệ số điều biến của Prefix đứng yên tuyệt đối (0.00e+00) qua mọi bước Euler.
Bài tập 2 · Đọc ma trận mặt nạ Block-Causal 11×11 ở bước 3C
Quan sát ma trận 11×11 ở mục [3C]: vì sao token văn bản ở q = 1 chỉ nhìn thấy 2 khóa (0..1), trong khi token đầu tiên của ảnh điều kiện ngay sát sau nó (q = 2) lại nhìn thấy tới 6 khóa (0..5)?
Đối chiếu sau khi tự trả lời
Vì q = 1 là token văn bản (image_id = -1 < 0) nên chỉ áp dụng quy tắc nhân quả q >= kv (nhìn thấy 0 và 1). Ngược lại, q = 2 thuộc khối ảnh điều kiện (image_id = 0 >= 0) nên ngoài việc nhìn thấy các vị trí đứng trước (0, 1), nó còn thỏa điều kiện same_image_block với tất cả các vị trí có cùng image_id = 0 (tức 2, 3, 4, 5), tổng cộng 6 khóa.
Bài tập 3 · Kiểm chứng tính cô lập nhân quả giữa ảnh đích và ảnh điều kiện
Ở phép kiểm chứng (3) cuối bài, khi lab cộng thêm một nhiễu 0.5 vào token 7 (thuộc ảnh đích) so với khi cộng nhiễu 0.5 vào token 5 (thuộc ảnh điều kiện), những vị trí nào trong chuỗi 11 token bị thay đổi?
Đối chiếu sau khi tự trả lời
Khi đổi token 7 (ảnh đích ở cuối chuỗi), toàn bộ 7 token Prefix (0..6) lệch đúng 0.00e+00 vì không vị trí nào trong Prefix được phép đọc cột 7..10, chỉ có 4 token ảnh đích (7..10) thay đổi (tới 5.00e-01). Khi đổi token 5 (ảnh điều kiện), cả 4 vị trí của ảnh điều kiện (2..5) đều thay đổi ([1.74e-01, 1.13e-01, 7.17e-02, 7.79e-01]) nhờ attention song hướng trong khối ảnh, nhưng 2 token văn bản đứng trước (0, 1) vẫn giữ nguyên 0.00e+00.
Bài tập 4 · Tính tỷ lệ tiết kiệm phép chiếu nhờ Prefix KV Cache ở bước 6A
Trong cấu hình lab (7 token Prefix + 4 token Target, chạy 3 bước Euler), tổng số lượt token phải đưa qua các tầng Linear Q, K, V và SwiGLU FFN trong toàn bộ 3 bước giảm từ bao nhiêu xuống bao nhiêu khi bật Prefix KV Cache?
Đối chiếu sau khi tự trả lời
Nếu không dùng cache (recompute), mỗi bước đều phải chạy đủ 11 token → 3 × 11 = 33 lượt token. Khi bật Prefix KV Cache, chỉ Step 1 (extract) chạy 11 token, còn Step 2 và Step 3 (cached) mỗi bước chỉ chạy đúng 4 token của ảnh đích → 11 + 4 + 4 = 19 lượt token (giảm 14/33 ≈ 42.4% tổng khối lượng tính toán toàn vòng lặp, và giảm 7/11 ≈ 63.6% ở mỗi bước cached).