2A · 4× Slot Expansion & Joint Packing
2A · Mở rộng 4× Slot ảnh & Ghép chuỗi đồng nhất (Joint Sequence Packing)
Mỗi slot ảnh của VLM tương ứng 4 token latent (khối 2×2); 2A giãn slot bằng repeat_interleave, thay token img_in tại image_pad_mask rồi dựng image_ids và target_token_mask cho các khối sau.
1Định nghĩa
Bài 2A trả lời câu hỏi tỷ lệ giữa hai lưới: VLM ở bài 1B mã hóa từng ảnh mẫu theo slot (một ô nén đại diện cả mảnh ảnh), trong khi lưới latent của bài 1A có 4 ô latent tương ứng một slot, xếp thành khối 2 × 2. Hằng số _IMG_TOKENS_PER_SLOT = 4 ghi chuẩn quy tắc đó. Bài toán cần giải: khối DiT làm việc trên token latent, nhưng khung chuỗi lại theo slot của VLM; phải giãn mỗi slot thành 4 token để mọi ô latent có chỗ riêng của mình trong chuỗi đồng nhất.
Về cơ chế, ba thao tác nối tiếp: (1) repeat_interleave lặp mỗi vector slot 4 lần liên tiếp — bốn token giãn đầu rất giống nhau vì đều từ một slot, và khác biệt giữa từng ô sẽ được 32 khối attention tạo ra dần; (2) tại những vị trí image_pad_mask, giá trị slot bị thay bằng đầu ra của img_in — token 4096 chiều tạo từ latent 64 kênh của ảnh theo bài 1A, phần chữ giữ nguyên giá trị của Qwen3-VL; (3) build_token_metadata gắn nhãn cho từng token: image_ids là −1 cho chữ, 0..K−1 cho từng ảnh tham chiếu, K cho ảnh đang sinh, còn target_token_mask chỉ True trên khối ảnh đích. Hai nhãn này là đầu vào trực tiếp của RoPE ở bài 3A, của bảng điệu biến ở bài 3B và của mặt nạ ở bài 3C.
Ví dụ đời thường: 2A giống bàn đặt trước trong nhà hàng: mỗi slot là một bàn có 4 ghế (khối 2 × 2). repeat_interleave là in và dán cùng một tên bàn lên cả 4 ghế; img_in là thay tờ menu dự phòng trên ghế bằng menu thật của khách ngồi đó; build_token_metadata là sổ chấm cơm ghi bàn nào thuộc nhóm nào (image_ids) và bàn nào là bàn chủ nhà đang kêu món (target_token_mask). Giới hạn của phép so: dán nhầm tên bàn (giãn sai vị trí) và ghi sai sổ đều khiến các khối sau nhầm địa chỉ, nên bước này phải làm đúng thứ tự trước khi chuỗi vào khối transformer.
2Luồng
Cách đọc hình (Cột 1, khối 2A ở đỉnh cột, nơi hai mũi tên ↑ từ 1A và 1B gặp nhau): token slot của bài 2 (ngữ cảnh) giãn 4 lần mỗi slot, token img_in của bài 1 (latent) được thay vào các vị trí image_pad_mask, rồi build_token_metadata gắn image_ids và target_token_mask trước khi chuỗi đồng nhất chảy sang Cột 2; xem bước [2A] trong [Bài Lab tổng hợp Qwen-Image-2.1](/courses/qwen-image-2-1/qwen21-lab/qwen21-end-to-end-lab/).
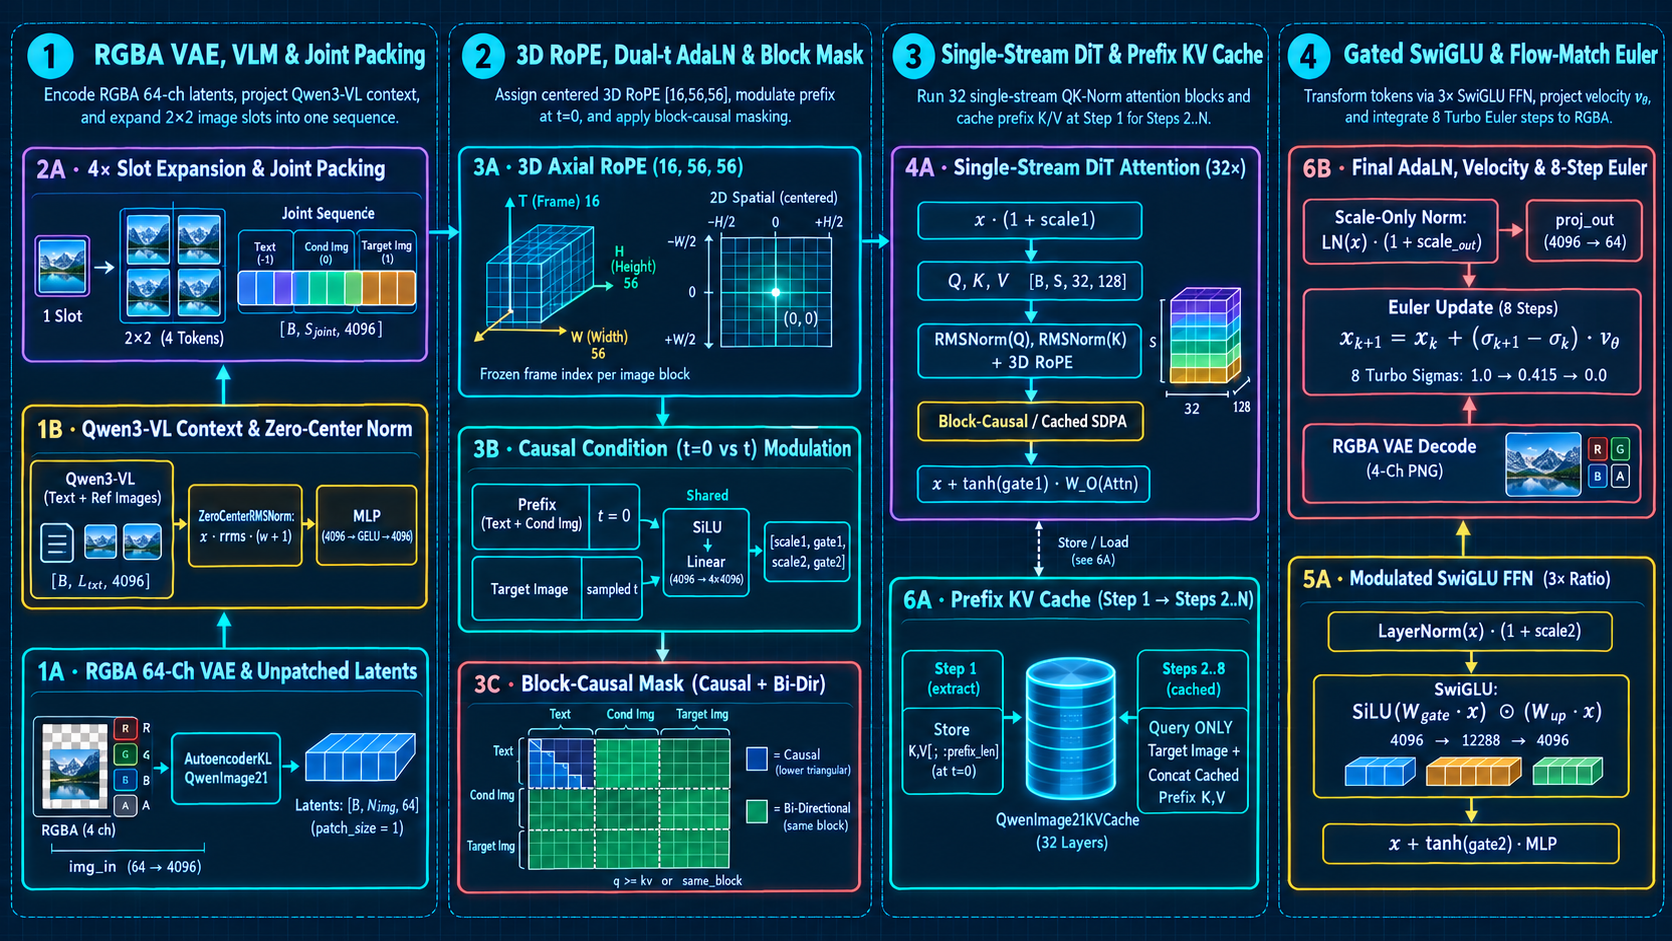
repeats = where(img_mask, 4, 1) → Joint [Text (-1) | Cond Img (0..K-1) | Target Img (K)] ∈ [B, S_joint, 4096]2A · 4× Slot Expansion & Joint Packing
Ghép mọi thứ thành một chuỗi duy nhất: giãn mỗi slot ảnh của VLM thành 4 token, lấp latent từ 1A vào, nối ảnh đích vào cuối và dán nhãn cho từng token.
- Mục đích
- VLM (1B) và VAE (1A) dùng hai lưới khác nhau: 1 slot của VLM ứng với một khối 2×2 = 4 ô latent. Phải giãn slot ra 4 lần để mỗi ô latent có đúng một chỗ trong chuỗi, rồi xếp chữ và ảnh nối đuôi nhau để một Transformer duy nhất xử lý tất cả.
- Đầu vào
- Chuỗi ngữ cảnh từ 1B, cùng token latent của các ảnh tham chiếu và của ảnh đích (đang nhiễu) từ 1A.
- Đầu ra
- Chuỗi ghép [B, S_joint, 4096] theo thứ tự Chữ → Ảnh tham chiếu → Ảnh đích, kèm nhãn image_ids (−1 = chữ, 0..K−1 = ảnh tham chiếu, K = ảnh đích) và target_token_mask. Các nhãn này được 3A, 3B, 3C dùng.
Trên đỉnh Cột 1, vì mỗi slot ảnh của Qwen3-VL đại diện cho một cụm 2×2 = 4 token latent của VAE, mô hình dùng repeat_interleave với hệ số repeats = where(img_mask, 4, 1) để mở rộng đúng các vị trí ảnh, điền latent từ 1A vào và nối ảnh đích (target image) vào cuối chuỗi. Kết quả tạo ra chuỗi đồng nhất joint_hidden_states kèm bảng nhãn image_ids (-1 cho chữ, 0..K-1 cho từng ảnh tham chiếu, K cho ảnh đích).
- 2A · Slot giãn 4 token
repeat_interleave lặp mỗi vector slot 4 lần vào các vị trí ảnh trong chuỗi chung.
- 2A · img_in thay thế tại image_pad_mask
Tại các vị trí đánh dấu, token 4096 chiều do img_in tạo từ latent 64 kênh thay giá trị slot.
- 2A · image_ids và target_token_mask
Nhãn metadata này là dữ liệu trực tiếp cho RoPE (bài 4), modulation (bài 5) và mặt nạ (bài 6).
Mã Mermaid
flowchart TD
  step1["2A · Slot giãn 4 token"]
  step2["2A · img_in thay thế tại image_pad_mask"]
  step3["2A · image_ids và target_token_mask"]
  step1 --> step2
step2 --> step33Giải pháp
Bài toán cần giải: ghép ba loại dữ liệu — chữ, ảnh tham chiếu, ảnh đang sinh — thành một chuỗi duy nhất với đúng số token cho từng ảnh, và cung cấp nhãn để các khối sau biết ai là ai. Sau bài này, bạn cần tự kể được: vì sao một slot có 4 token, token slot nào bị thay, và image_ids, target_token_mask nghĩa là gì.
Trạng thái đầu vào: hai loại nguyên liệu đã sẵn sàng từ hai bài trước — token slot ảnh của bài 1B cùng latent đã chuẩn hóa và qua img_in từ bài 1A. Toán giãn không thêm lớp học được nào — toàn bộ là thao tác sắp xếp chỉ số.
Các thao tác và lý do: (1) giãn repeat_interleave theo quy tắc 4 token mỗi slot để khớp tỷ lệ lưới VLM với lưới latent; (2) thay img_in tại image_pad_mask để token ảnh mang nội dung latent thật thay vì placeholder slot; (3) dựng image_ids và target_token_mask vì các khối sau (RoPE, modulation, mặt nạ) đều cần biết ranh giới từng ảnh và đâu là ảnh đang sinh.
Đầu ra và cách đọc: một chuỗi đồng nhất, độ dài bằng số token chữ cộng 4 lần tổng số slot của mọi ảnh (tính cả ảnh đích). Khi đọc bước 2A của lab, hãy đếm độ dài theo công thức đó; in bảng image_ids theo vị trí để chứng kiến từng token được gán nhãn đúng.
Giới hạn: thứ tự ô trong khối 2 × 2 phải theo hàng (row-major) khớp với tọa độ RoPE ở bài 3A; nếu metadata sai (ví dụ hai ảnh mang cùng image_id), mặt nạ ở bài 3C sẽ cho hai ảnh nhìn chéo nhau; các thao tác này không học trọng số nào nên không thể 'tự sửa' qua cấu hình khác trừ khi đúng hằng số _IMG_TOKENS_PER_SLOT = 4.
4Profiling
- Độ dài chuỗi sau giãn
Trong bước 2A của lab, in độ dài chuỗi trước và sau giãn; so với công thức: số token chữ cộng 4 lần tổng số slot. Nếu lệch, kiểm tra cách processor đếm slot của từng ảnh tham chiếu. Đây là kiểm tra tính đúng cấu trúc.
- Parity thay thế img_in
Chọn vài vị trí trong image_pad_mask và so giá trị token tại đó với đầu ra img_in của ô latent tương ứng (chênh lệch nhỏ trong ngưỡng so là đúng); phần chữ phải giữ nguyên giá trị từ bài 1B. Nếu chữ bị đổi hoặc ảnh chưa được thay, chỉ số mask hoặc thứ tự ảnh đang trộn.
- Parity image_ids và target_token_mask
In bảng nhãn theo từng dải của chuỗi: chữ: −1; ảnh tham chiếu 0..K−1; ảnh đích: K và target_token_mask True. So với bảng dự đoán ở Ví dụ 2. Nhãn sai thường phát hiện muộn ở mặt nạ attention, nên buộc phải so bảng này trước.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Giãn slot ở chuỗi nhỏ
Input: chuỗi có 2 token chữ s1, s2 và 2 slot ảnh A, B (mỗi slot sẽ giãn 4 token). Hãy dự đoán thứ tự chuỗi sau giãn. Kết quả: s1 s2 A A A A B B B B — repeat_interleave giữ mỗi slot 4 token liền kề, đúng khối 2 × 2 trên lưới ảnh. Cách quan sát: bước 2A của [Bài Lab tổng hợp Qwen-Image-2.1](/courses/qwen-image-2-1/qwen21-lab/qwen21-end-to-end-lab/) in bảng vị trí trên chuỗi sau khi giãn slot; tự kiểm tra các vị trí 3..6 thuộc A và 7..10 thuộc B. Giới hạn: thứ tự 4 token là theo hàng của khối 2 × 2, không phải 4 bản sao ở cùng một ô.
Bảng image_ids với 2 ảnh tham chiếu + 1 ảnh đích
Input: prompt có 1 đoạn chữ, ảnh tham chiếu thứ nhất (image_id 0), ảnh tham chiếu thứ hai (image_id 1) và ảnh đang sinh. Hãy dự đoán image_ids của từng dải và target_token_mask của ảnh đích. Kết quả: chữ: −1; ảnh 1: 0; ảnh 2: 1; ảnh đích: 2 và target_token_mask True chỉ trên dải đó. Tự kiểm tra: nếu thêm ảnh tham chiếu thứ ba thì image_ids có một dải 0,1,2 và ảnh đích là 3. Cách quan sát: bước 2A của lab in bảng này per toàn chuỗi; đối chiếu với bài 3A, 3B, 3C để thấy nhãn được dùng chỗ nào.
6Thuật ngữ
- Slot ảnh (image slot)
- Một ô ảnh đã nén của VLM trong chuỗi; ở pipeline 2.1, mỗi slot phải giãn thành 4 token latent.
- _IMG_TOKENS_PER_SLOT = 4
- Hằng số ghi quy tắc 1 slot ↔ 4 token latent, tương ứng khối 2 × 2 ô liền nhau trên lưới ảnh.
- repeat_interleave
- Phép lặp giãn: mỗi vector slot được viết 4 lần liên tiếp; 4 token giãn đầu giống hệt nhau, khác nhau dần qua các lớp.
- image_pad_mask
- Mặt nạ đánh dấu các vị trí chuỗi dành cho token ảnh; tại đó đầu ra img_in được thay vào làm token thật.
- build_token_metadata
- Hàm gắn nhãn chuỗi: image_ids (−1 cho chữ, 0..K−1 cho từng ảnh tham chiếu, K cho ảnh đích) và target_token_mask (True chỉ khối ảnh đích).
Glossary (4)
- Chuỗi đồng nhất (joint sequence)
- Một dãy token duy nhất gồm chữ và token ảnh, đưa qua cùng 32 khối DiT.
- Ảnh tham chiếu (condition image)
- Ảnh mẫu đặt trong prompt để chỉ hướng sinh; ảnh đích là ảnh đang được khử nhiễu.
- Khối 2 × 2
- Cách 4 token latent liên hệ một slot: 2 ô theo hàng và 2 ô theo cột trên lưới latent.
- Metadata
- Danh sách nhãn đi kèm chuỗi: image_ids và target_token_mask, không phải trọng số của mô hình.