3B · Causal Condition (t=0 vs t)
3B · Điều kiện nhân quả (t=0 vs t) & Bộ điều biến dùng chung (Shared Modulation)
DiT 2.1 nhúng mức nhiễu t theo thang 1000×t thành vector, tính hai hàng t = 0 và t đang lấy mẫu, chọn theo target_token_mask và sinh 4 vùng điệu biến từ một lớp modulation dùng chung.
1Định nghĩa
Bài 3B trả lời câu hỏi nhỏ nhưng giữ cho kiến trúc đứng vững: khối DiT làm sao biết ảnh đang nặn ở mức nhiễu nào? Mỗi ảnh đang sinh x mang một mức nhiễu σ chạy từ 1.0 (toàn nhiễu) về 0.0 (ảnh sạch); transformer cần tín hiệu này để chọn cách xử lý token. Lớp QwenImage21TimestepProjEmbeddings nhúng t (t là σ theo thang thời gian của pipeline): đầu vào 1000 × t chuyển thành chuỗi sin-cos (sinusoidal) rồi qua MLP thành vector 4096 chiều, đúng độ rộng chuẩn của khối.
Về cơ chế, pipeline bật causal_condition = True nên tính cả hai hàng embedding: hàng t = 0 và hàng t đang lấy mẫu; hàm _select_modulation_rows phân phối theo target_token_mask của bài 2A: token có mask False — chữ và ảnh tham chiếu — luôn nhận hàng t = 0, còn token ảnh đích nhận hàng t của bước hiện hành. Lý do: phần này là dữ liệu sạch, chữ không có nhiễu và ảnh tham chiếu là ảnh thật, nên cho chúng 'ngày t = 0' — nhờ vậy biểu diễn của prefix không phụ thuộc bước khử nhiễu, mở đường cho bài 6A tái dùng KV cache. Tiếp đó, một lớp modulation dùng chung (SiLU → Linear(4096, 4 × 4096)) biến mỗi hàng thành 4 vùng scale1, gate1, scale2, gate2 được bài 4A và bài 5A đọc trực tiếp; cả 32 khối đọc từ cùng một hàng, không có bộ AdaLN riêng từng khối.
Ví dụ đời thường: 3B như một nhà may duy nhất của đoàn kịch: mỗi màn diễn (mức σ), diễn viên chính (token ảnh đích) nhận bộ trang phục riêng theo kịch bản màn đó trong khi hậu trường (chữ và ảnh tham chiếu) luôn mặc bộ mặc 'ngày 0' không đổi qua màn nào. Vì hậu trường đứng yên, đoàn diễn được 8 màn (8 bước Turbo) mà không phải may lại bộ mặc hậu trường một lần nào nữa. Giới hạn của phép so: mỗi 'bộ trang phục' là một vector 4096 chiều học được, không phải một con số gán nhãn như bảng giá vé.
2Luồng
Cách đọc hình (Cột 2, khối 3B ở giữa cột dưới 3A): nhận vector t nhúng và metadata target_token_mask từ trên xuống, tính hai hàng t = 0 và t, chọn hàng cho từng token rồi qua modulation dùng chung sinh 4 vùng điệu biến, phân phối cho các khối ở Cột 3 và Cột 4 (4A và 5A reads scale1, gate1, scale2, gate2); xem bước [3B] trong [Bài Lab tổng hợp Qwen-Image-2.1](/courses/qwen-image-2-1/qwen21-lab/qwen21-end-to-end-lab/).
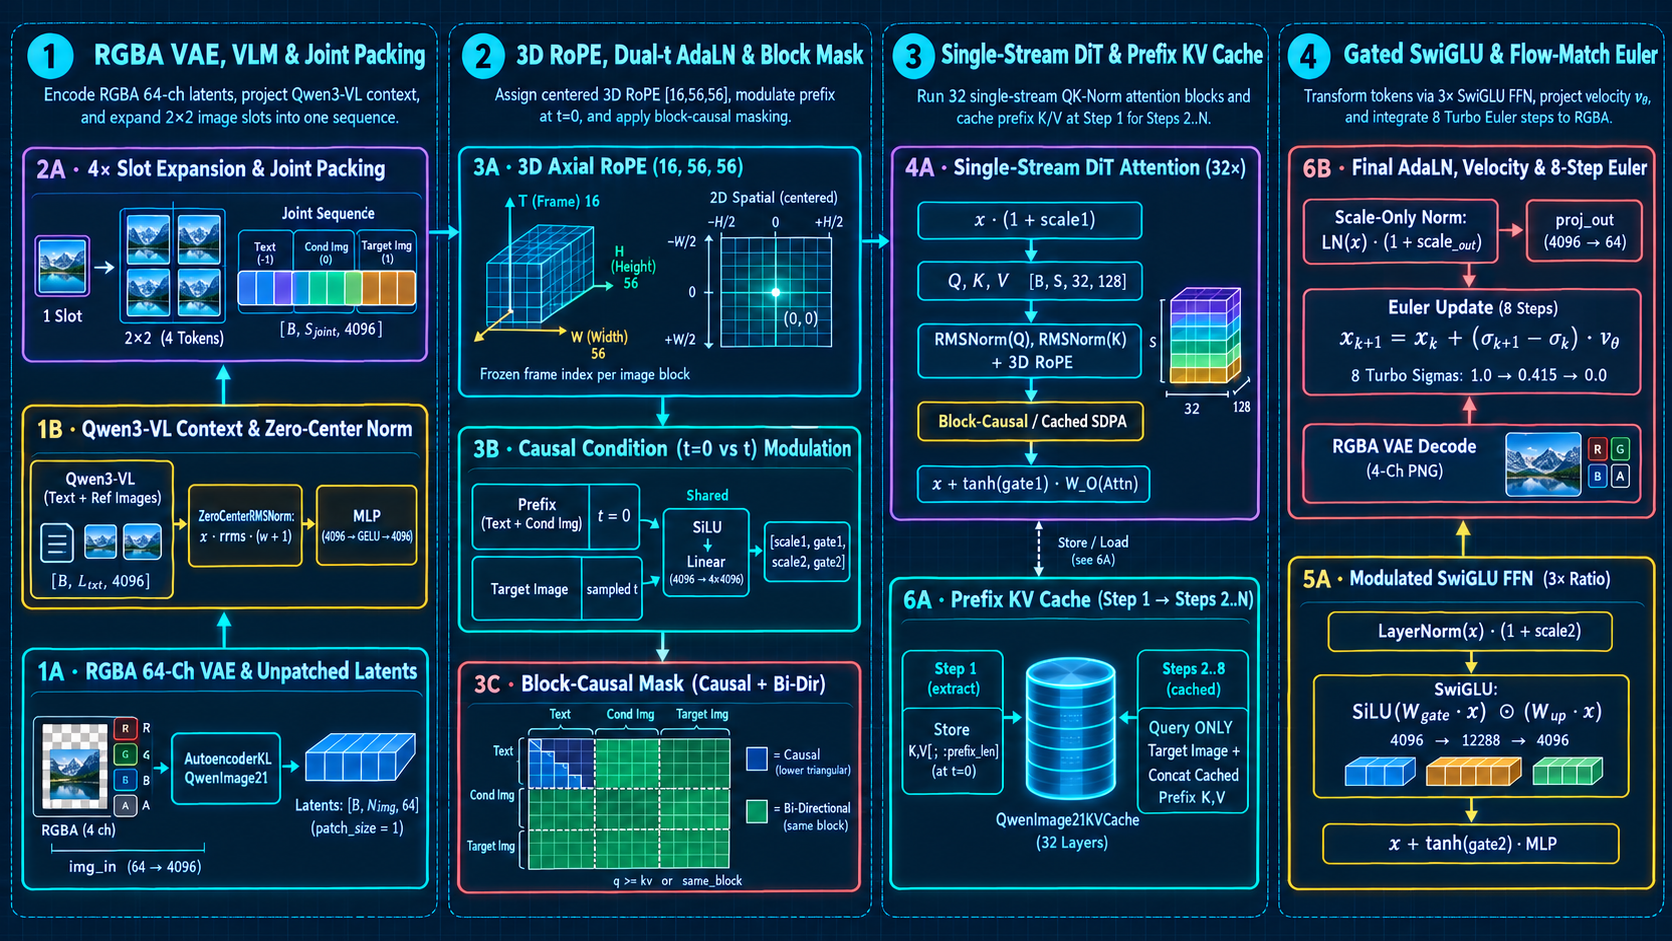
Prefix (Text + Cond) → t = 0 · Target → t_step · Shared SiLU → Linear(4096 → 4×4096): [scale1, gate1, scale2, gate2]3B · Causal Condition (t=0 vs t) Modulation
Báo cho mô hình biết mức nhiễu: token ảnh đích nhận tín hiệu thời gian t của bước hiện tại, còn chữ và ảnh tham chiếu (vốn sạch) luôn nhận t = 0.
- Mục đích
- Ảnh đích đi từ nhiễu hoàn toàn (t = 1) về ảnh sạch (t = 0), nên mỗi lớp cần biết đang ở mức nào để xử lý cho đúng. Prefix (chữ + ảnh tham chiếu) không có nhiễu; cố định nó ở t = 0 giúp biểu diễn của Prefix không đổi qua các bước — điều kiện để 6A cache được.
- Đầu vào
- Bước nhiễu t hiện tại của bộ lập lịch và target_token_mask từ 2A (đánh dấu token nào thuộc ảnh đích).
- Đầu ra
- Mỗi token nhận một bộ 4 hệ số [scale1, gate1, scale2, gate2] (sinh qua SiLU → Linear 4096 → 4×4096): Prefix dùng bộ của t = 0, ảnh đích dùng bộ của t hiện tại. 4A dùng scale1/gate1, 5A dùng scale2/gate2.
Ở giữa Cột 2, khi bật causal_condition = True, mô hình nối thêm một hàng t = 0 vào cuối vector thời gian timestep. Hàm _select_modulation_rows dùng target_token_mask để phát bộ hệ số của t = 0 cho mọi token Prefix (văn bản và ảnh tham chiếu — vốn không chứa nhiễu) và chỉ phát bộ hệ số của bước nhiễu t_step cho các token ảnh đích. Nhờ vậy biểu diễn của Prefix không đổi suốt 8–40 bước khử nhiễu, mở đường cho Prefix KV Cache ở 6A.
- 3B · Nhúng t thành vector 4096
1000 × t đi qua chuỗi sin-cos rồi MLP, thu vector 4096 chiều cho mỗi mức nhiễu.
- 3B · Chọn hàng theo target_token_mask
Phần sạch (chữ + ảnh tham chiếu) nhận hàng t = 0; ảnh đích nhận hàng t đang lấy mẫu.
- 3B · Một modulation sinh 4 vùng
SiLU → Linear(4096, 4×4096) tạo scale1, gate1, scale2, gate2 dùng chung cho 32 khối.
Mã Mermaid
flowchart TD
  step1["3B · Nhúng t thành vector 4096"]
  step2["3B · Chọn hàng theo target_token_mask"]
  step3["3B · Một modulation sinh 4 vùng"]
  step1 --> step2
step2 --> step33Giải pháp
Bài toán cần giải: một chuỗi chung gánh hai loại dữ liệu — sạch (chữ, ảnh tham chiếu) và đang nhiễu (ảnh đích) — phải nhận hai mức điều kiện cùng lúc, mà không muốn nhân một bộ trọng số điệu biến cho từng trong 32 khối. Sau bài này, bạn cần tự kể được: t nhúng thế nào, hai hàng chọn theo mask ra sao, và 4 vùng điệu biến dùng ở đâu.
Trạng thái đầu vào: giá trị σ của bước hiện hành (và t = 0 cố định cho phần sạch) cùng target_token_mask từ bài 2A. Không có tensor ảnh nào tham gia lớp này: nó chỉ sinh tín hiệu hệ số.
Các thao tác và lý do: (1) nhúng 1000 × t bằng sin-cos rồi MLP, vì hàm sin-cos hoạt động ổn trên dải thời gian rộng; (2) tính hai hàng t = 0 và t, phép chọn theo mask đúng mục đích causal: phần sạch cố định qua mọi bước; (3) modulation dùng chung sinh 4 vùng một lần, mỗi khối đọc lại — tiết kiệm tham số và giữ tín hiệu t nhất quán xuyên suốt chuỗi khối.
Đầu ra và cách đọc: với mỗi token, một cặp 4 vector: scale1 và gate1 cho phần attention, scale2 và gate2 cho phần FFN. Khi đọc bước 3B của lab, hãy in cùng lúc hàng t = 0 và hàng t để so: hai hàng chỉ khác nhau ở token ảnh đích; dải prefix phải dùng hàng t = 0.
Giới hạn: tắt causal_condition đi thì phần sạch nhận hàng t của bước hiện hành, để prefix đổi theo từng bước và cache ở bài 6A vô nghĩa; modulation dùng chung là thiết kế cố định của checkpoint này, không phải tùy chọn runtime một chút nào.
4Profiling
- Parity hai hàng t
Bước 3B của lab in shape và một vài giá trị của hai hàng t = 0 và t: shape phải là 4096 chiều cho mỗi hàng. Nếu pipeline chạy mà hàng t = 0 không tồn tại, kiểm tra cờ causal_condition của cấu hình.
- Prefix ổn định qua các bước
Chạy bước 1 và bước 8 (hoặc hai bước bất kỳ) rồi so hàng mà prefix nhận: hai lượt phải cho cùng giá trị, vì đều là hàng t = 0. Đây là cơ sở lý thuyết cho cache ở bài 6A; nếu khác nhau, kiểm tra phần chọn hàng theo target_token_mask.
- Kích thước lớp modulation
Linear(4096 → 16384) có 4096 × 16384 = 67.108.864 tham số cho một lớp dùng chung. Tính so sánh tay với phương án 32 bộ riêng (32 lần con số đó); đây là phép tính từ cấu hình được công bố, không phải số công bố khác của model card.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Chọn hàng theo mask ở chuỗi nhỏ
Input: chuỗi 6 token gồm 4 token prefix (target_token_mask False) và 2 token ảnh đích (True); mức nhiễu bước hiện hành σ = 0.7 (t tương ứng). Hãy dự đoán hàng mà từng token nhận. Kết quả: 4 token đầu nhận hàng t = 0; 2 token cuối nhận hàng t = σ; nếu đổi σ thành 0.9, token đích đổi hàng còn prefix giữ nguyên. Cách quan sát: bước 3B của [Bài Lab tổng hợp Qwen-Image-2.1](/courses/qwen-image-2-1/qwen21-lab/qwen21-end-to-end-lab/) in bảng chọn hàng; tự kiểm tra bằng cách đổi σ và so hai lượt.
Đếm kích thước vùng điệu biến
Input: một token với vector t nhúng 4096 số vào lớp Linear(4096, 4 × 4096). Hãy dự đoán số con số ra và cách chia. Kết quả: 16384 số, cắt thành 4 vùng bằng nhau mỗi vùng 4096: scale1, gate1, scale2, gate2. Tự kiểm tra: nếu inner_dim của mô hình khác, ví dụ 2048, thì mỗi vùng là 2048 và tổng ra 8192; hãy tính lại bằng tay trước khi xem lab in shape ở bước 3B. Giới hạn: thứ tự 4 vùng do mã nguồn quyết định; đọc đúng thứ tự quan trọng hơn tính tầm cỡ.
6Thuật ngữ
- σ (sigma)
- Mức nhiễu của ảnh đang sinh, chạy từ 1.0 (toàn nhiễu) về 0.0 (ảnh sạch); t là σ theo thang thời gian của pipeline.
- QwenImage21TimestepProjEmbeddings
- Bộ nhúng thời điểm: lấy 1000 × t, chuyển thành chuỗi sin-cos (sinusoidal) rồi qua MLP nắn thành vector 4096 chiều.
- causal_condition = True
- Cờ bắt đầu tính hai hàng embedding: hàng t = 0 cho phần sạch và hàng t đang lấy mẫu cho ảnh đích.
- _select_modulation_rows
- Hàm phân phối hàng: token có target_token_mask False nhận hàng t = 0, token ảnh đích (True) nhận hàng t.
- modulation (SiLU → Linear 4096 → 4×4096)
- Một lớp duy nhất sinh 4 vùng scale1, gate1, scale2, gate2 dùng chung cho cả 32 khối.
Glossary (3)
- Modulation (điệu biến)
- Cách báo cho mỗi lớp transformer biết mức nhiễu: thay đổi hệ số chuẩn hóa và cổng residual theo t thay vì cộng thêm vector.
- scale và gate
- scale là hệ số nhân độ lớn sau chuẩn hóa; gate là hệ số nhân của nhánh phụ trước khi cộng residual.
- AdaLN
- Phạm vi tên chung của kỹ thuật điệu biến chuẩn hóa theo điều kiện; trong 2.1 trọng số điệu biến nằm ở một lớp dùng chung.