1A · RGBA 64-Channel VAE
1A · RGBA 64-Channel VAE & Unpatched Latents · Mã hóa ảnh trong suốt 4 kênh
VAE AutoencoderKLQwenImage21 nén ảnh RGBA 4 kênh thành latent 64 kênh, chuẩn hóa từng kênh bằng latents_mean và latents_std, rồi chiếu thành token 4096 chiều qua img_in.
1Định nghĩa
Bài 1A mô tả cửa ngõ ảnh của bộ sinh Qwen-Image-2.1: lớp AutoencoderKLQwenImage21 (gọi tắt là VAE) nhận một ảnh 4 kênh RGBA — Red, Green, Blue để tô màu và Alpha để ghi độ trong suốt của từng điểm ảnh — và nén thành một bản đồ đặc trưng nhỏ hơn gọi là latent, mỗi ô mang 64 con số. Bài toán nó giải quyết: khối DiT không làm việc trực tiếp trên hàng triệu điểm ảnh, mà cần một không gian đặc trưng gọn để khử nhiễu; cấu hình patch_size = 1 nghĩa là transformer không ghép thêm các ô latent thành mảnh lớn (unpatched), nên mỗi ô latent trở thành đúng một token và số token ảnh bằng số ô của lưới latent.
Về cơ chế, ảnh đi qua bộ nén của VAE: kích thước không gian thu nhỏ lại và mỗi ô giữ 64 đặc trưng (in_channels = 4 ở điểm ảnh, in_channels = 64 ở latent). Sau nén, từng kênh được chuẩn hóa bằng công thức z_hat = (z − latents_mean) / latents_std với 64 cặp mean và std đi kèm checkpoint: mỗi kênh về tâm 0 và độ lệch 1, để bước khử nhiễu sau làm việc trên cùng một thang số. Cuối cùng, img_in là Linear(64, 4096, không bias) biến mỗi ô latent thành một token 4096 chiều; token này sẽ được đặt vào chuỗi chung trong bài 2A về giãn slot và được khử nhiễu qua các bước đến bài 6B kết thúc vòng Euler.
Ví dụ đời thường: 1A giống túi hút chân không đựng chăn gối: tấm chăn cồng kềnh (4 kênh RGBA đầy đủ) được ép nhỏ gọn lại nhưng vẫn giữ đủ thông tin để trải ra như cũ; 64 ngăn của túi là 64 kênh latent, mỗi ngăn giữ một loại thông tin riêng. Nhãn in trên túi chính là latents_mean và latents_std: khi mở túi ở bài 6B, bạn phải nhân và cộng ngược đúng nhãn đó chứ không lấy nhãn của một túi khác. Giới hạn của phép so: túi thủ công có thể làm mất chi tiết, còn VAE được huấn luyện để nén với tổn thất nhỏ và giải nén lại được gần như nguyên vẹn.
2Luồng
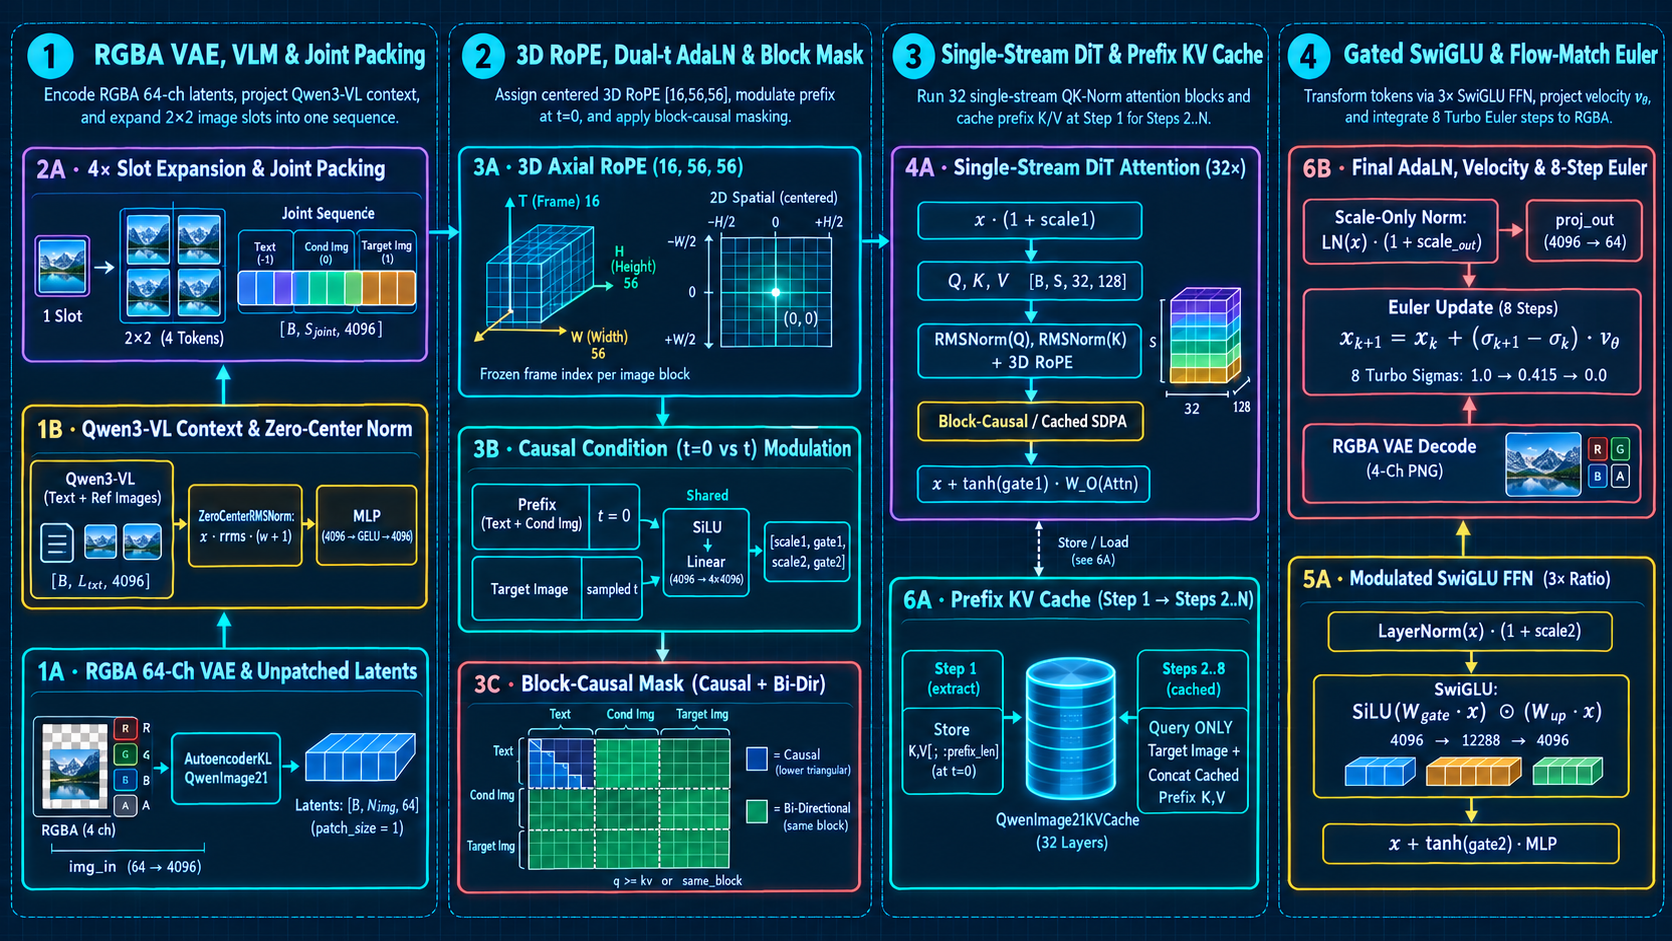
Cách đọc hình (Cột 1, khối 1A ở chân cột, mũi tên ↑ hướng lên): ảnh RGBA vào từ trái, VAE nén thành latent 64 kênh, chuẩn hóa từng kênh rồi img_in đẩy token 4096 chiều lên khối 1B (bài 2 · ngữ cảnh) và khối 2A (bài 3 · giãn slot) theo mũi tên của Cột 1; xem bước [1A] trong [Bài Lab tổng hợp Qwen-Image-2.1](/courses/qwen-image-2-1/qwen21-lab/qwen21-end-to-end-lab/).
RGBA [B, 4, H, W] → AutoencoderKLQwenImage21 → ẑ = (z − mean)/std ∈ [B, N_img, 64] (patch_size=1) → img_in(64 → 4096)1A · RGBA 64-Ch VAE & Unpatched Latents
Biến ảnh thành token mà Transformer đọc được: VAE nén ảnh RGBA thành một lưới latent nhỏ, mỗi ô có 64 kênh, rồi mỗi ô được chiếu thành một token 4096 chiều.
- Mục đích
- Transformer không thể xử lý trực tiếp hàng triệu điểm ảnh. Bước này nén ảnh xuống một lưới gọn nhưng vẫn giữ đủ thông tin, kể cả kênh trong suốt Alpha, để cuối pipeline (6B) giải nén lại thành ảnh.
- Đầu vào
- Ảnh tham chiếu 4 kênh R, G, B, Alpha có dạng [B, 4, H, W]. Ảnh đích không đi qua encoder: nó bắt đầu là nhiễu ngẫu nhiên tạo thẳng trên lưới latent cùng kích thước.
- Đầu ra
- Mỗi ảnh thành N_img token 4096 chiều (1 ô latent = 1 token vì patch_size = 1), sau khi chuẩn hóa từng kênh (z − mean) / std và chiếu img_in 64 → 4096. Các token này được lắp vào chuỗi chung ở 2A.
Bắt đầu đọc sơ đồ từ góc dưới bên trái (1A): AutoencoderKLQwenImage21 nhận ảnh 4 kênh R, G, B, Alpha và nén thành các vector latent 64 kênh. Trước khi đi vào mạng DiT, mỗi kênh được chuẩn hóa theo thống kê riêng ẑ = (z − latents_mean) / latents_std rồi chiếu thẳng qua img_in (64 → 4096) với patch_size = 1 (không gộp ô 2×2 tại đây) để bảo toàn chi tiết biên trong suốt.
- 1A · VAE nén ảnh RGBA thành latent
Ảnh 4 kênh (3 kênh màu cộng Alpha) được nén: kích thước không gian nhỏ đi, mỗi ô mang 64 đặc trưng; patch_size = 1 nên mỗi ô đúng một token.
- 1A · Chuẩn hóa từng kênh
z_hat = (z − latents_mean) / latents_std theo 64 cặp mean và std, đưa mọi kênh về cùng một thang số.
- 1A · img_in tạo token ảnh
Linear(64, 4096, không bias) biến mỗi ô latent thành token 4096 chiều, sẵn sàng ghép vào chuỗi chung ở 2A.
Mã Mermaid
flowchart TD
  step1["1A · VAE nén ảnh RGBA thành latent"]
  step2["1A · Chuẩn hóa từng kênh"]
  step3["1A · img_in tạo token ảnh"]
  step1 --> step2
step2 --> step33Giải pháp
Bài toán cần giải: đưa một ảnh thật (hoặc trong suốt) vào không gian mà khối DiT có thể khử nhiễu, và giữ đường lối ra ngược lại chính xác. Sau bài này, bạn cần tự kể được: ảnh vào ở dạng nào, latent ra sao, chuẩn hóa từng kênh làm gì, và img_in tạo token thế nào.
Trạng thái đầu vào: một ảnh RGBA với hình dạng 4 × H × W (4 kênh × cao × rộng). Bộ nén của VAE giảm kích thước không gian và mở rộng số kênh, cho ra latent 64 × H_lat × W_lat. Con số H_lat và W_lat tùy cấu hình VAE của checkpoint; bạn đọc giá trị thực khi in shape ở bước 1A của lab thay vì đoán.
Các thao tác và lý do: (1) nén bằng VAE để không phải khử nhiễu trên pixel; (2) chuẩn hóa z_hat = (z − latents_mean) / latents_std theo từng kênh, vì kiến trúc transformer hoạt động ổn hơn khi dữ liệu nằm quanh 0 với độ lệch gần 1; (3) img_in là Linear(64, 4096, không bias), mỗi ô latent cho ra một token 4096 chiều. Không có bước ghép ô (patching) vì patch_size = 1.
Đầu ra và cách đọc: một dãy token ảnh, mỗi token 4096 số, chưa có địa chỉ không gian (địa chỉ gắn ở bài 3A · RoPE) và chưa giãn theo slot (bài 2A). Khi đọc bước 1A của lab, hãy so số token với số ô latent: hai số phải bằng nhau.
Giới hạn: chuẩn hóa chỉ dùng đúng cặp latents_mean và latents_std của checkpoint; nếu dùng bảng của model khác thì latent sẽ lệch thang và kết quả khử nhiễu sai. Latent không phải ảnh: các con số không đọc trực tiếp thành màu, phải qua decoder VAE ở cuối (bài 6B).
4Profiling
- Số token sau img_in
Chạy encode rồi img_in trong bước 1A của lab: số token in ra phải đúng bằng số ô của lưới latent (patch_size = 1 không gộp ô nào). Nếu lệch, kiểm tra cấu hình patch_size hoặc lưới latent. Đây là kiểm tra tính đúng, chưa phải đo hiệu năng.
- Khoảng giá trị latent sau chuẩn hóa
In thống kê (trung bình, độ lệch chuẩn) từng kênh sau khi chuẩn hóa: trung bình gần 0 và độ lệch gần 1 là bình thường; sai số nhỏ so với 1e-2 thường do tính trên ảnh cụ thể chứ không phải lỗi. Nếu lệch lớn, trước tiên nghi bảng latents_mean và latents_std không khớp checkpoint.
- Vòng đi - về qua VAE
Encode một ảnh rồi decode ngay lại trong bước 1A của lab để thấy hai đầu của ống nén: decoder là cùng lớp được dùng ở bước cuối của bài 6B. So ảnh gốc và ảnh tái tạo bằng mắt và ghi nhận khác biệt; đây là quan sát chất lượng nén, không phải phép đo tốc độ.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Chuẩn hóa một ô với số cụ thể
Input: một ô latent có giá trị z = 12, kênh đó có latents_mean = 8 và latents_std = 2 (số minh họa; giá trị thật lấy từ cấu hình checkpoint). Trước khi tính, hãy dự đoán: sau chuẩn hóa giá trị về gần 0 hay càng xa 0? Cách quan sát: thực hiện phép cộng chia thủ công hoặc xem lab bước 1A in z_hat. Kết quả: z_hat = (12 − 8) / 2 = 2. Tự kiểm tra: nếu z = 8 thì z_hat = 0; nếu z = 6 thì z_hat = −1. Giới hạn: phép so dùng mean và std cặp cho đúng kênh; tráo kênh là sai ngay.
Đếm token: mỗi ô latent một token
Input: giả sử lưới latent của một bước chạy là 8 × 8 ô (số minh họa). Hãy dự đoán số token ảnh sau img_in. Vì patch_size = 1, mỗi ô đúng một token nên kết quả là 64 token, mỗi token 4096 số; mã tùy chỉnh patch khác (ví dụ patch_size = 2) thì mỗi 4 gộp một mảnh và chỉ còn 16 token. Cách quan sát: bước 1A của [Bài Lab tổng hợp Qwen-Image-2.1](/courses/qwen-image-2-1/qwen21-lab/qwen21-end-to-end-lab/) in số ô latent và số token; so hai số cùng nhau. Tự kiểm tra: nếu hai số khác nhau, bước nào gộp ô đã chạy nhầm.
6Thuật ngữ
- RGBA
- Bốn lớp dữ liệu màu của ảnh: Red, Green, Blue để tô màu và Alpha để ghi độ trong suốt của từng điểm ảnh.
- VAE (AutoencoderKLQwenImage21)
- Cặp mã hóa - giải mã học được: nén ảnh thành latent gọn khi vào pipeline, giải nén ngược thành ảnh khi sinh xong.
- Latent 64 kênh
- Bản nén của ảnh: mỗi ô của lưới đặc trưng mang 64 con số, thay vì 4 kênh màu ở kích thước đầy đủ.
- latents_mean / latents_std
- Hai bảng 64 số đi kèm checkpoint: trừ mean rồi chia std để từng kênh latent về tâm 0 và độ lệch 1.
- img_in (Linear 64 → 4096)
- Lớp tuyến tính không bias: biến mỗi ô latent 64 số thành một token 4096 chiều cho khối transformer.
Glossary (4)
- Kênh (channel)
- Lớp số song song của cùng một vị trí ảnh; RGBA có 4 kênh, latent có 64 kênh.
- Token
- Đơn vị 4096 con số mà transformer xử lý; với patch_size = 1, mỗi ô latent trở thành đúng một token.
- Chuẩn hóa (standardize)
- Trừ trung bình rồi chia độ lệch chuẩn để dữ liệu nằm quanh 0 với độ phủ ổn định.
- Bias
- Hằng số cộng thêm của lớp tuyến tính; img_in cố ý bỏ bias để giữ phép chiếu thuần tuyến tính.