6A · Prefix KV Cache Reuse
6A · Prefix KV Cache qua các bước khử nhiễu (Extract Step 1 → Cached Steps 2..N)
Vì prefix luôn nhận t = 0 nên K/V của nó bất biến qua 8 bước; bước 1 chạy forward đầy đủ và clone K/V prefix (mode extract), các bước 2..8 chỉ tính query ảnh đích và nối cache (mode cached).
1Định nghĩa
Bài 6A là tối ưu cho vòng lặp nhiều bước: attention ở bài 4A cần K (key) và V (value) của toàn chuỗi, mà pipeline Turbo chạy 8 bước Euler; nếu mỗi bước tính lại K/V của prefix — phần chữ và các ảnh tham chiếu — là chi phí lặp lại y hệt. Cấu trúc dùng là QwenImage21KVCache (bộ đệm tổng của mô hình) và QwenImage21KVLayerCache (mỗi lớp attention một bộ). Hai lý do làm cache hợp lệ: prefix chỉ được nhìn phần trước nhờ mặt nạ ở bài 3C, và prefix luôn nhận hàng t = 0 nhờ bài 3B — nên K/V của prefix giống nhau ở mọi bước khử nhiễu.
Về cơ chế, hai chế độ nối nhau: bước 1 chạy với kv_cache_mode = extract — forward đầy đủ, rồi từ từng lớp lấy key[:, :prefix_len] và value[:, :prefix_len] và .clone() ngay; lệnh clone tạo bản sao vật lý trong bộ nhớ để tensor gốc có thể bị giải phóng sau lượt chạy mà bản sao vẫn dùng được. Từ bước 2 đến 8 chạy với kv_cache_mode = cached: forward chỉ trên query ảnh đích (joint_hidden_states[:, prefix_len:]), và trong attention, cột K được nối cat([cached_k, target_k], dim = 1) — token ảnh đích vẫn được đọc cả prefix (bản cache) lẫn phần đích mới, đúng thứ tự chuỗi; V xử lý tương tự. Kết quả ở bước cached phải khớp với forward đầy đủ cùng bước; bước 6A của lab cho phép đối chiếu trực tiếp trên cùng seed.
Ví dụ đời thường: 6A giống thi 8 vòng tính nhanh: đề bài và các trang tài liệu của phòng thi (prefix) được chép tóm tắt một lần vào bìa nhỏ đầu vòng 1 (extract, clone); 7 vòng sau chỉ cần mở bìa và cộng thêm phần tự viết của vòng đấy (target_k) — mỗi vòng thay đổi phần câu trả lời của riêng mình, không đổi phần tóm tắt đầu bài. Giới hạn của phép so: bìa tóm tắt chỉ hiệu lực khi phần đầu không đổi (causal_condition bật); nếu cấu hình cho prefix phụ thuộc t, mỗi vòng phải chép lại từ đầu và cache vô dụng.
2Luồng
Cách đọc hình (Cột 3, khối 6A dưới 4A, hợp thành cặp ↔): khối 4A chạy mean hai công — mỗi lần forward một lần; khối 6A khai thác tính bất biến: bước 1 extract và clone K/V prefix từ từng lớp, từ bước 2 đến 8 chỉ tính query ảnh đích và đi cat([cached_k, target_k]) theo chiều chuỗi; xem bước [6A] trong [Bài Lab tổng hợp Qwen-Image-2.1](/courses/qwen-image-2-1/qwen21-lab/qwen21-end-to-end-lab/).
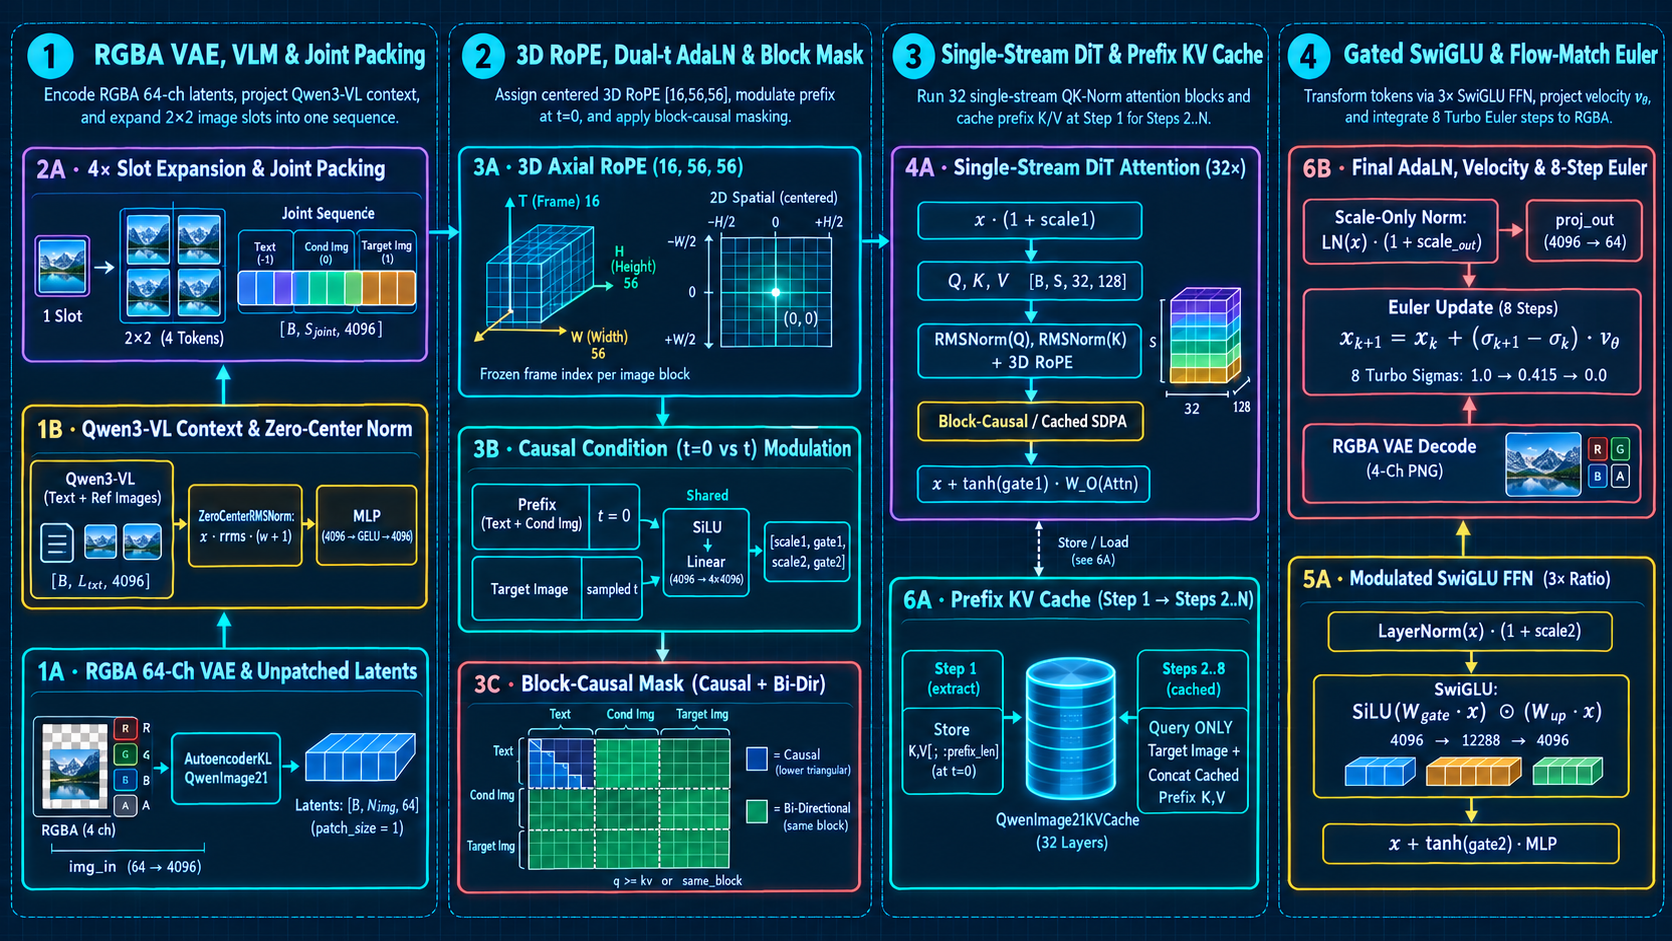
Step 1 (extract): store K,V[:, :prefix_len].clone() · Steps 2..8 (cached): query Target ONLY + cat([cached_KV, target_KV])6A · Prefix KV Cache (Step 1 → Steps 2..N)
Tính một lần, dùng lại nhiều lần: ở bước khử nhiễu đầu tiên, lưu K/V của Prefix (chữ + ảnh tham chiếu); các bước sau chỉ còn tính cho ảnh đích.
- Mục đích
- Pipeline chạy 32 lớp lặp lại qua nhiều bước khử nhiễu (8 bước ở bản Turbo). Nhờ 3B (Prefix luôn ở t = 0) và 3C (Prefix không nhìn ảnh đích), K/V của Prefix giống hệt nhau ở mọi bước, nên tính lại là lãng phí.
- Đầu vào
- Bước 1: K/V đầy đủ (đã xoay RoPE) của từng lớp trong 4A. Từ bước 2 trở đi: chỉ các token ảnh đích.
- Đầu ra
- Một bộ đệm K/V của Prefix cho mỗi lớp (lưu bằng .clone()). Ở các bước sau, attention ghép cat([cached_KV, target_KV]) nên ảnh đích vẫn đọc được Prefix mà không phải chạy lại Prefix qua 32 lớp.
Nằm ngay dưới 4A ở Cột 3 là bộ đệm QwenImage21KVCache: nhờ phần Prefix (chữ + tới 10 ảnh tham chiếu) được điều biến ở t = 0 và không nhìn về ảnh đích (3B, 3C), K và V sau RoPE của Prefix chỉ cần tính đúng 1 lần ở Step 1 (kv_cache_mode = 'extract') rồi lưu bản sao .clone(). Từ Step 2 đến hết vòng lặp (kv_cache_mode = 'cached'), mạng chỉ đưa các token của ảnh đích đi qua 32 lớp và ghép cat([cached_K, target_K]) ở mỗi lớp — tiết kiệm 100% FLOPs của phần ngữ cảnh ở các bước sau.
- 6A · Vì sao prefix bất biến
Prefix chỉ nhìn phần trước nhờ mặt nạ và luôn nhận t = 0, nên K/V không đổi giữa các bước.
- 6A · Bước 1: extract và clone
Forward đầy đủ, lấy key[:, :prefix_len] và value[:, :prefix_len] từ từng lớp attention rồi .clone().
- 6A · Bước 2..8: cached
Chỉ chạy query trên joint_hidden_states[:, prefix_len:], keys nối cat([cached_k, target_k], dim = 1).
Mã Mermaid
flowchart TD
  step1["6A · Vì sao prefix bất biến"]
  step2["6A · Bước 1: extract và clone"]
  step3["6A · Bước 2..8: cached"]
  step1 --> step2
step2 --> step33Giải pháp
Bài toán cần giải: 8 bước là 8 lần forward, mỗi lần attention cần K/V của toàn chuỗi; phần prefix chiếm đa số token nên tính lại mỗi bước là phí lớn. Sau bài này, bạn cần tự kể được: hai lý do khiến prefix bất biến, cơ chế extract và clone, và phần nào phải tính mới ở các bước sau.
Trạng thái đầu vào: hidden shape B × T × 4096 với T = prefix_len cộng số token ảnh đích; prefix_len là công thức của bài 2A: số token chữ cộng 4 lần tổng slot của các ảnh tham chiếu. Sau QKV của từng lớp, K và V sẵn sàng để thu vào cache.
Các thao tác và lý do: (1) ở bước 1, forward đầy đủ để từng lớp thu K/V, lấy phần [:, :prefix_len] rồi clone — phải clone vì lượt 1 không giữ bộ nhớ dài hạn; (2) từ bước 2, chạy gọn: chỉ query ảnh đích, và nối cache vào phía trước theo đúng thứ tự — thiếu phần nối, attention sẽ mất đọc prefix; (3) đối chiếu parity với forward đầy đủ cùng bước để bước cache không đổi kết quả.
Đầu ra và cách đọc: kết quả từng bước so với chạy đầy đủ: shape và giá trị của output ảnh đích. Khi đọc bước 6A của lab, hãy đọc bảng parity và bảng số vị trí query mỗi bước (đầy đủ ở bước 1; chỉ ảnh đích từ bước 2) như Ví dụ 1 bên dưới.
Giới hạn: cache chỉ đúng cho prefix; phần ảnh đích đổi mỗi bước, phải tính lại K (và V) mọi lần; nếu cấu hình causal_condition tắt, tính bất biến không còn và phải dùng forward đầy đủ; không đo chất lượng ảnh từ chế độ cache — nó chỉ tiết kiệm tính toán, kết quả phải parity.
4Profiling
- Parity cache so với forward đầy đủ
Bước 6A của lab chạy cả hai cách cho một bước trong khoảng 2..8 cùng seed: so output hidden và attention của các token ảnh đích; chênh lệch phải nằm trong ngưỡng đã chọn cho runtime (FP16 sẽ chênh nhẹ hơn FP32). Đây là bằng chứng cache không đổi kết quả; nếu lệch lớn, trước tiên kiểm tra thứ tự nối cat.
- Số vị trí query mỗi bước
Đếm vị trí query: bước 1 là toàn bộ T; các bước 2..8 chỉ là T − prefix_len. Tính bằng tay theo công thức ở Ví dụ 1 và so với bảng lab in; đây là quan sát lượng tính toán, chưa phải phép khẳng định thời gian chạy thực tế.
- Bộ nhớ cache
32 lớp attention, mỗi lớp giữ một cặp K và V của prefix: kích thước tăng theo prefix_len; lab in tổng cache cho prompt hiện hành. Ghi điều kiện (batch, dtype) khi báo cáo; chưa tính các buffer tạm thời của runtime.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Đếm vị trí query theo hai phương thức
Input: chuỗi có T = 12 token với prefix_len = 8, chạy 8 bước. Hãy dự đoán tổng số vị trí query cho hai phương thức: chạy đầy đủ mọi bước so với dùng cache. Kết quả: đầy đủ là 8 × 12 = 96 vị trí; dùng cache là bước 1 tính cả 12 (12 vị trí), 7 bước sau mỗi bước chỉ 4 token đích (28 vị trí), tổng 40. Vị trí giảm 56/96 ≈ 58% — hãy chú ý đây mới là phần query; phần K/V prefix cũng chỉ tính đúng một lần ở bước 1. Tự kiểm tra: với T = 20 và prefix_len = 16, hai số tương ứng là 160 và 48. Cách quan sát: bước 6A của [Bài Lab tổng hợp Qwen-Image-2.1](/courses/qwen-image-2-1/qwen21-lab/qwen21-end-to-end-lab/) in bảng đếm cho prompt bạn chạy.
Hình dạng nối cat([cached_k, target_k])
Input: cached_k của prefix có phần dài prefix_len theo trục chuỗi; target_k đang tính có độ dài bằng số token ảnh đích. Dự đoán: tổng chiều của K sau khi nối trục chuỗi là bao nhiêu? Kết quả: đúng T — cache trước, phần mới sau, giữ đúng thứ tự chuỗi nên attention vẫn xem các vị trí theo trật tự hợp lệ. Tự kiểm tra: hoán đổi hai phần khi nối sẽ sai thứ tự vị trí (RoPE gắn theo từng cột sẽ lệch); thứ tự đúng duy nhất là cache trước, đích sau. Cách quan sát: bước 6A in shape cặp tensor trước và sau cat.
6Thuật ngữ
- K và V (key, value)
- Hai tập vector attention cần cho mọi query; tính đắt nên đáng lưu lại và dùng lại.
- Prefix
- Phần đứng trước token ảnh đích trong chuỗi: chữ và các ảnh tham chiếu (target_token_mask = False).
- QwenImage21KVCache / QwenImage21KVLayerCache
- Bộ cache tổng của mô hình và bộ cache của từng lớp attention; mỗi lớp giữ một cặp K, V riêng.
- kv_cache_mode = extract | cached
- Bước 1 dùng extract: chạy đầy đủ rồi clone K/V prefix; các bước sau dùng cached: chỉ tính query ảnh đích.
- target_k
- Phần K của token ảnh đích, tính mới ở từng bước và được nối vào sau cached_k trong phép attention.
Glossary (4)
- KV cache
- Bộ nhớ giữ K và V đã tính của mô hình để dùng lại cho query sau, tránh tính lại từ đầu.
- prefix_len
- Độ dài phần prefix: số token chữ cộng 4 lần tổng slot ảnh tham chiếu.
- cat theo dim = 1
- Nối hai tensor dọc trục chuỗi: phần cache đứng trước, phần mới của ảnh đích đứng sau.
- clone
- Tạo bản sao vật lý của tensor trong bộ nhớ, tách khỏi tensor gốc để gốc giải phóng vẫn được an toàn.