1B · Qwen3-VL & Zero-Center Norm
1B · Qwen3-VL Context & Zero-Center RMSNorm · Mã hóa ngữ cảnh đa tham chiếu
Qwen3-VL mã hóa chữ kẹp cùng tối đa 10 ảnh tham chiếu thành chuỗi ngữ cảnh 4096 chiều, cân chỉnh bằng ZeroCenter RMSNorm rồi nắn lại qua TextProjection trước khi vào chuỗi chung.
1Định nghĩa
Bài 1B là khối ngữ cảnh như đã nêu: Qwen3VLForConditionalGeneration — mô hình vision-language của họ Qwen3 — nhận prompt gồm đoạn chữ và các ảnh tham chiếu đặt kẹp giữa chữ (tối đa 10 ảnh), mã hóa toàn bộ thành một chuỗi token ngữ cảnh, mỗi token 4096 số (context_in_dim = 4096). Bài toán nó giải quyết: khối DiT cần một dạng ngữ cảnh duy nhất mang cả mô tả bằng chữ lẫn nội dung các ảnh mẫu, và giữ đúng thứ tự kẹp nhau như người dùng soạn; lợi dụng VLM có sẵn cho phép ảnh và chữ gắn kết trong cùng quá trình mã hóa thay vì hai rãnh song song rời rạc.
Về cơ chế, hai lớp gọn giúp token ngữ cảnh vào đúng chuẩn của khối DiT: trước là QwenImage21ZeroCenterRMSNorm, chuẩn hóa từng token theo căn trung bình bình phương rồi nhân (weight + 1) — khác RMSNorm thường ở chỗ trọng số học quanh 0 và cùng cộng 1, giúp mức nhân ổn định quanh 1; sau là QwenImage21TextProjection: Linear(4096, 4096) → GELU(tanh) → Linear(4096, 4096), nắn lại biểu diễn cho phù hợp không gian của khối DiT. Chuỗi ngữ cảnh này sau đó được ghép với token ảnh từ bài 2A về giãn slot và đi qua bài 4A về attention cùng chuỗi. Khái niệm nền về chuẩn hóa có trong bài RMSNorm của llm-inference.
Ví dụ đời thường: 1B giống quầy phiên dịch của một hội nghị: khách dự thuyết trình đưa cả bài nói (chữ) và các slide ảnh (tối đa 10 ảnh mẫu); phiên dịch (Qwen3-VL) chép tất cả thành một bộ chú thích chung cùng ngôn ngữ (4096 chiều). Ống âm thanh trước loa chỉnh mức (ZeroCenter RMSNorm) để mọi chú thích cùng một âm lượng chuẩn; bước viết lại lời bình theo giọng chung của hội trường là TextProjection. Giới hạn của phép so: phiên dịch không chép từng điểm ảnh của slide; nội dung điểm ảnh vẫn đi qua đường latent riêng ở bài 1A.
2Luồng
Cách đọc hình (Cột 1, khối 1B ở giữa, mũi tên ↑ hướng lên): nhận phần chữ và các slot ảnh tham chiếu của prompt, mã hóa bằng Qwen3-VL, cân chỉnh bằng ZeroCenter RMSNorm, nắn qua TextProjection rồi đẩy chuỗi ngữ cảnh 4096 chiều lên khối 2A để ghép với token ảnh ở ngay trên nó trong Cột 1; xem bước [1B] trong [Bài Lab tổng hợp Qwen-Image-2.1](/courses/qwen-image-2-1/qwen21-lab/qwen21-end-to-end-lab/).
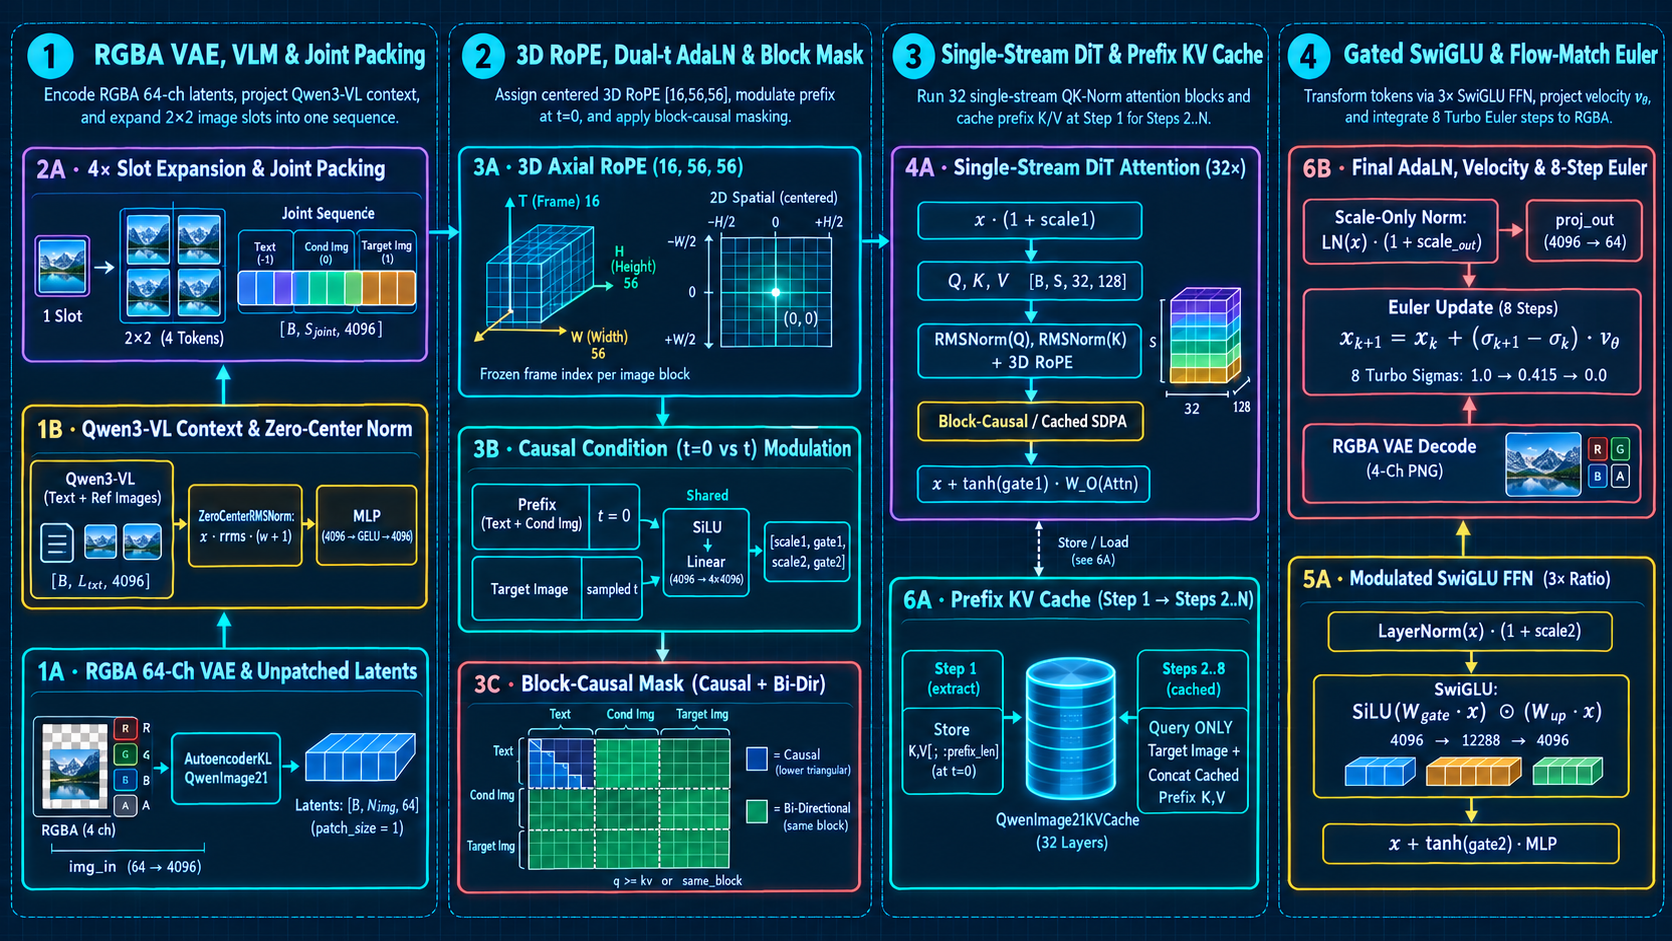
Qwen3-VL [B, L_txt, 4096] → ZeroCenterRMSNorm: x · rrms · (w + 1) → Linear(4096) → GELU(tanh) → Linear(4096)1B · Qwen3-VL Context & Zero-Center Norm
Đọc hiểu câu lệnh: Qwen3-VL mã hóa prompt (chữ xen kẽ tối đa 10 ảnh tham chiếu) thành chuỗi token ngữ cảnh 4096 chiều, rồi chuẩn hóa và chiếu lại cho khớp với DiT.
- Mục đích
- DiT cần biết người dùng muốn vẽ gì. Một mô hình vision-language có sẵn hiểu cả chữ lẫn ảnh mẫu trong cùng một ngữ cảnh và giữ đúng thứ tự người dùng soạn. Zero-Center RMSNorm (nhân w + 1) và MLP GELU nắn biểu diễn của VLM về đúng thang số mà DiT mong đợi.
- Đầu vào
- Prompt đa phương thức: đoạn chữ và tối đa 10 ảnh tham chiếu đặt xen giữa các câu chữ.
- Đầu ra
- Chuỗi ngữ cảnh [B, L_txt, 4096]: token chữ mang nghĩa câu lệnh, mỗi ảnh tham chiếu chiếm một nhóm slot (mỗi slot tóm tắt một vùng ảnh). Chuỗi này đi tiếp vào 2A.
Đi từ 1A lên 1B: bộ mã hóa đa phương thức Qwen3-VL đọc cả câu lệnh văn bản lẫn các ảnh tham chiếu để xuất chuỗi ngữ cảnh 4096 chiều. Khối txt_in chuẩn hóa biên độ bằng QwenImage21ZeroCenterRMSNorm (lưu trọng số dạng độ lệch w = scale − 1 nên nhân với w + 1 ở FP32) rồi đưa qua mạng MLP 2 tầng có kích hoạt GELU(tanh).
- 1B · Qwen3-VL mã hóa chữ và ảnh mẫu
Chữ và các ảnh tham chiếu kẹp giữa đi qua Qwen3-VL, thu một chuỗi token ngữ cảnh 4096 chiều theo đúng thứ tự soạn.
- 1B · ZeroCenter RMSNorm cân chỉnh
Mỗi token được chuẩn hóa theo căn trung bình bình phương rồi nhân (weight + 1).
- 1B · TextProjection nắn biểu diễn
Linear(4096, 4096) → GELU(tanh) → Linear(4096, 4096) cho token ngữ cảnh 4096 chiều sẵn sàng ghép với token ảnh.
Mã Mermaid
flowchart TD
  step1["1B · Qwen3-VL mã hóa chữ và ảnh mẫu"]
  step2["1B · ZeroCenter RMSNorm cân chỉnh"]
  step3["1B · TextProjection nắn biểu diễn"]
  step1 --> step2
step2 --> step33Giải pháp
Bài toán cần giải: tạo chuỗi ngữ cảnh 4096 chiều mang cả chữ và ảnh mẫu, giữ đúng thứ tự kẹp nhau, và chuẩn hóa đủ để khối DiT nhận ngay. Sau bài này, bạn cần tự kể được: Qwen3-VL đóng vai gì, chuỗi ngữ cảnh gồm token nào, ZeroCenter RMSNorm khác RMSNorm thường ở đâu, và TextProjection thay đổi gì (hay không thay đổi chiều).
Trạng thái đầu vào: phần chuỗi với chữ được tokenize và các ảnh tham chiếu được nén thành slot ảnh. Token ảnh slot của VLM mới chỉ là chỗ đứng; nội dung điểm ảnh thật của các ảnh này gắn vào ở bài 2A qua img_in từ latent (xem bài 1A).
Các thao tác và lý do: (1) chạy Qwen3-VL để mọi token ngữ cảnh đều biết bối cảnh của cả chữ lẫn ảnh mẫu; (2) chuẩn hóa ZeroCenter RMSNorm để mỗi token về cùng độ lớn — đây là biến thể nhân (weight + 1), phù hợp định nghĩa ở phần Định nghĩa; (3) TextProjection hai lớp Linear 4096 → 4096 với GELU(tanh) như một tầng phi tuyến nhẹ: chiều không đổi, chỉ biểu diễn được nắn lại.
Đầu ra và cách đọc: chuỗi token ngữ cảnh hình dạng S_ctx × 4096, trong đó S_ctx bằng số token chữ cộng số token slot ảnh tham chiếu. Khi đọc bước 1B của lab, hãy đếm S_ctx theo công thức đó rồi đối chiếu; ở bài 2A, mỗi slot ảnh còn được giãn 4 lần.
Giới hạn: hai lớp chuẩn hóa và chiếu không phụ thuộc mức nhiễu σ (khác các lớp điệu biến của khối DiT ở bài 5); TextProjection dùng đúng hệ số của checkpoint, không phải tính cộng dồn; số token slot ảnh phụ thuộc kích thước từng ảnh tham chiếu nên prompt ảnh khác nhau cho S_ctx khác nhau.
4Profiling
- Số token ngữ cảnh
Trong bước 1B của lab, in S_ctx cho một prompt cụ thể và so với công thức: số token chữ cộng số token slot ảnh. Số lượng token slot phụ thuộc độ phân giải của từng ảnh tham chiếu, số này do processor của VLM quyết định; nếu lệch, kiểm tra bước processor hoặc đoạn chữ bị tokenize sai.
- Parity ZeroCenter RMSNorm
Tự tính thủ công cho một token nhỏ như ở Ví dụ 1 bên dưới, rồi so với kết quả lab bước 1B với cùng trọng số; chọn ngưỡng so sánh phù hợp độ chính xác số học của runtime (FP32 và FP16 sẽ khác nhẹ). Nếu lệch lớn, kiểm tra công thức (weight + 1) và giá trị eps.
- Thay đổi sau TextProjection
So token ngữ cảnh trước và sau TextProjection: shape không đổi (4096 → 4096), giá trị thay đổi. In thống kê trung bình và độ lệch chuẩn của token trước và sau; đây là quan sát biểu diễn, không phải phép đo tốc độ. Không kết luận chất lượng ảnh từ thời gian chạy của hai lớp này.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Tính ZeroCenter RMSNorm cho một token nhỏ
Input: hidden của một token gồm 3 số [2, 2, 1], weight = 1, eps nhỏ bỏ qua. Dự đoán trước: kết quả sẽ lớn hơn hay nhỏ hơn vector gốc? Cách tính: trung bình bình phương là (4 + 4 + 1) / 3 = 3; căn của 3 gần bằng 1.732; nghịch đảo của nó gần 0.57735; vector chuẩn hóa là [1.1547, 1.1547, 0.57735]; nhân (weight + 1) = 2 cho [2.3094, 2.3094, 1.1547]. Tự kiểm tra: nếu weight = 0 thì mức nhân đúng 1 và kết quả là vector chuẩn hóa trần. Giới hạn: số thực tế trong lab dùng 4096 chiều và weight học được, nên khác ví dụ nhỏ.
Đọc chuỗi ngữ cảnh của một prompt
Input: prompt có 20 token chữ và 1 ảnh tham chiếu nén thành 12 token slot (số minh họa). Hãy dự đoán S_ctx trước khi chạy. Kết quả kỳ vọng: 20 + 12 = 32 token, mỗi token 4096 số. Cách quan sát: bước 1B của [Bài Lab tổng hợp Qwen-Image-2.1](/courses/qwen-image-2-1/qwen21-lab/qwen21-end-to-end-lab/) in số token ngữ cảnh; thêm một ảnh tham chiếu nữa và chạy lại để thấy S_ctx tăng theo số token slot của ảnh mới. Giới hạn: nếu processor nén ảnh theo kích thước khác, S_ctx thay đổi theo, không phải cố định cho mỗi ảnh.
6Thuật ngữ
- Qwen3VLForConditionalGeneration
- Mô hình ngôn ngữ nhìn ảnh (vision-language) của họ Qwen3; ở pipeline 2.1, vai trò của nó là mã hóa ngữ cảnh, không sinh chữ.
- Ngữ cảnh đa tham chiếu
- Prompt gồm đoạn chữ và các ảnh mẫu đặt kẹp giữa chữ, tối đa 10 ảnh, đúng thứ tự người dùng soạn.
- QwenImage21ZeroCenterRMSNorm
- Chuẩn hóa theo căn trung bình bình phương, rồi nhân (weight + 1) thay vì chỉ weight; weight học quanh 0 nên mức nhân quanh 1.
- context_in_dim = 4096
- Độ rộng vector của token ngữ cảnh mà khối DiT chấp nhận; đúng bằng inner_dim của transformer ảnh.
- QwenImage21TextProjection
- MLP hai lớp Linear(4096, 4096) với GELU(tanh) ở giữa, nắn lại biểu diễn ngữ cảnh trước khi vào các khối DiT.
Glossary (4)
- Vision-Language Model (VLM)
- Mô hình được huấn luyện đọc cả chữ và ảnh trong một chuỗi duy nhất.
- RMSNorm
- Chuẩn hóa theo căn trung bình bình phương của các thành phần vector, không trừ trung bình như LayerNorm.
- GELU (tanh)
- Hàm phi tuyến trơn dùng trong transformer hiện đại; phiên bản GELU(tanh) dùng xấp xỉ theo tanh để tính nhanh.
- Slot ảnh
- Ô ảnh đã nén của VLM trong chuỗi; mỗi slot tương ứng 4 token latent, xử lý chi tiết ở bài 3.