4A · Single-Stream DiT Attention
4A · Single-Stream DiT Attention (32 lớp) & Chuẩn hóa QK-RMSNorm
32 khối single-stream xử lý chữ và ảnh chung một dòng hidden 4096 chiều; mỗi khối chuẩn hóa theo 1 + scale1, chiếu QKV không bias 32 đầu × 128, áp QK-RMSNorm, RoPE 3D rồi cộng qua cổng tanh gate1.
1Định nghĩa
Bài 4A là phòng attention chính của QwenImage21Transformer2DModel: 32 khối single-stream cho tổng 7B tham số visual. Single-stream nghĩa là toàn bộ chuỗi đồng nhất (chữ + ảnh) nằm trên một dòng hidden 4096 chiều, đi qua cùng một cấu trúc khối 32 lần; so với cách hai dòng riêng cho chữ và ảnh ở một vài kiến trúc DiT khác, một dòng duy nhất gọn cấu trúc hơn và giúp bài 6A tái dùng KV hiện ra tự nhiên. Bài toán cần giải: attention phải hợp nhất chữ với ảnh và nhạy với vị trí không gian, mà vẫn giữ gradient ổn định với chuỗi dài.
Về cơ chế, một lần qua khối gồm các bước nối tiếp: (1) img_norm1(x) × (1 + scale1) — chuẩn hóa rồi nới độ lớn theo tín hiệu t của bài 3B; (2) to_q, to_k, to_v là ba lớp Linear không bias chiếu 4096 thành 32 đầu × 128 chiều; (3) norm_q và norm_k là RMSNorm trên 128 chiều, bọc theo token và từng đầu (QK-RMSNorm), để Q và K có độ lớn ổn định trước softmax; (4) apply_rotary_emb_qwen xoay theo bảng tọa độ ba trục của bài 3A; (5) SDPA thực hiện softmax(Q·K) × V theo từng đầu cùng mặt nạ của bài 3C; (6) to_out gộp 32 đầu về 4096; (7) residual x + tanh(gate1) × attn_output — cổng tanh nằm trong khoảng (−1, 1) nên phần góp của nhánh attention luôn được giới hạn mức.
Ví dụ đời thường: 4A giống 32 phóng viên cùng đọc một bản tin: mỗi phóng viên được phát một bản sao với góc nhìn riêng (32 đầu × 128 chiều); trước khi so ghi chú, ai cũng nói cùng âm lượng chuẩn (QK-RMSNorm); bảng tọa độ (RoPE) cho biết ghi chú của ai đối chiếu với đoạn nào; câu trả lời chung của cả đội được đóng gói (to_out) và dán vào bản thảo qua một van mở từ từ (tanh gate1 — mức mở là hệ số học được, nằm theo thiết kế trong khoảng (−1, 1)). Giới hạn của phép so: van chỉ giới hạn mức nhân nhánh phụ, thông tin gốc vẫn nằm nguyên trên đường residual.
2Luồng
Cách đọc hình (Cột 3, khối 4A phía trên, khối tính chính của cột): nhận chuỗi đồng nhất cùng mặt nạ từ 3C, tọa độ RoPE từ 3A và 4 vùng điệu biến từ 3B, chạy 32 lần cùng cấu trúc: chuẩn hóa theo scale1 → QKV → QK-RMSNorm → RoPE 3D → SDPA → to_out → cổng tanh gate1; kết quả đi ngang mũi tên ↔ sang khối 6A (tái dùng KV qua các bước) và tiếp sang Cột 4 (FFN 5A); xem bước [4A] trong [Bài Lab tổng hợp Qwen-Image-2.1](/courses/qwen-image-2-1/qwen21-lab/qwen21-end-to-end-lab/).
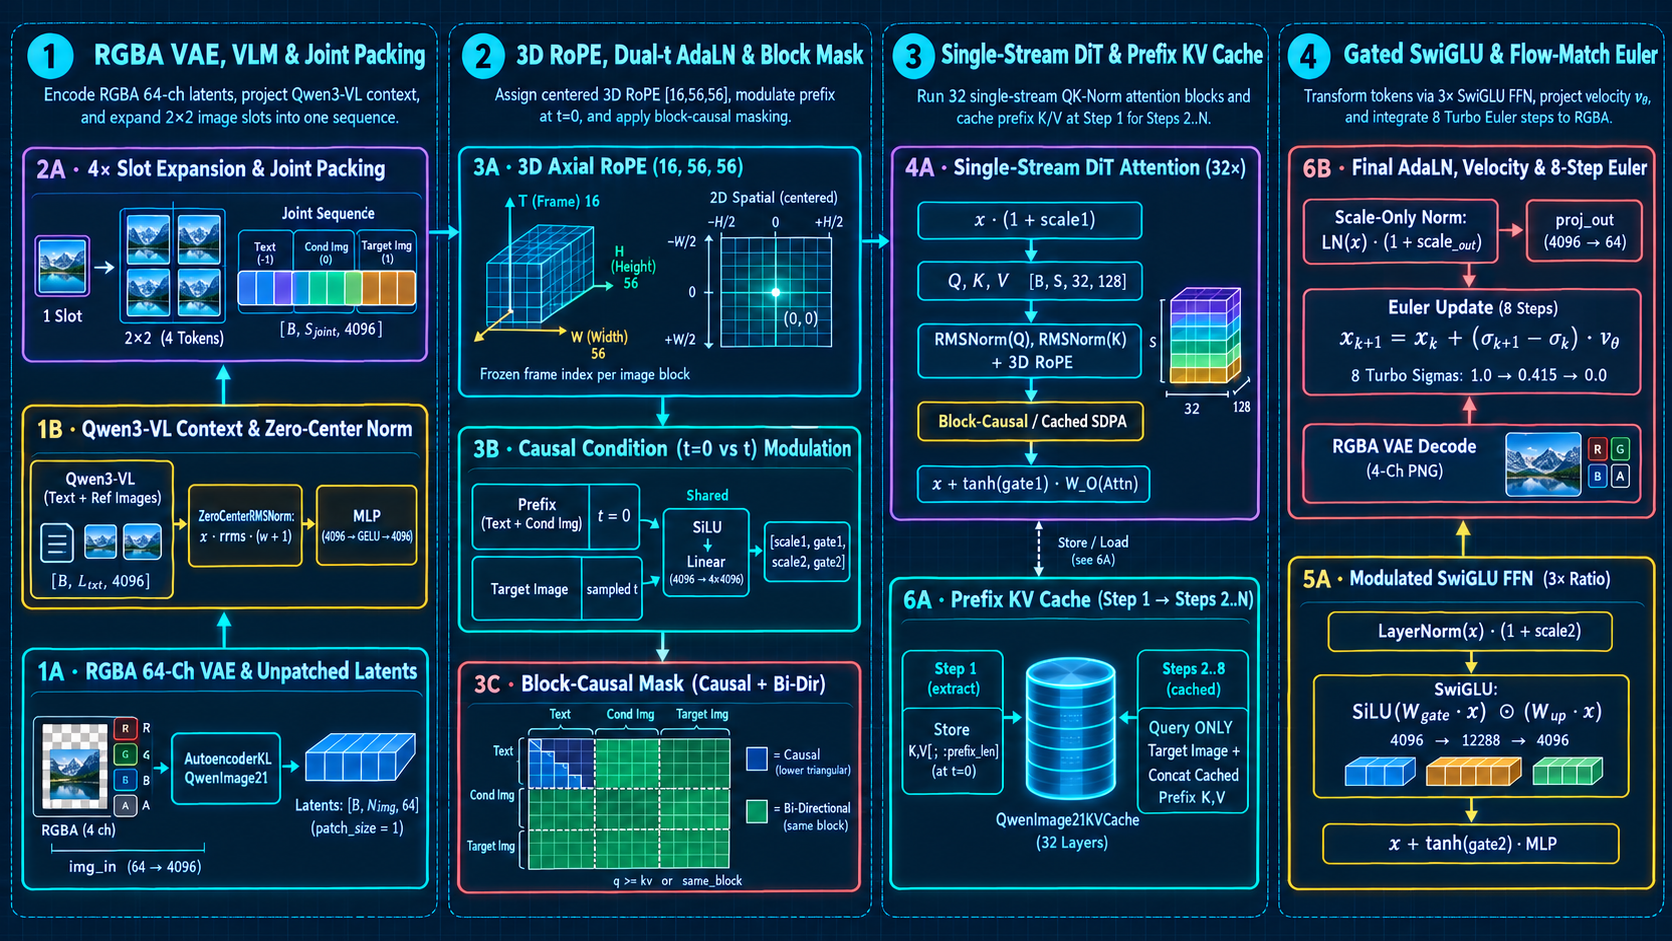
LN(x)·(1+scale1) → Q,K,V [B,S,32,128] → RMSNorm(Q,K) + 3D RoPE → Block-Causal/Cached SDPA → x + tanh(gate1)·W_O4A · Single-Stream DiT Attention (32 Layers)
Lõi trộn thông tin: 32 lớp attention chạy trên một luồng chung cho cả chữ và ảnh, để ảnh đích “đọc” được prompt, ảnh tham chiếu và chính nó.
- Mục đích
- Đây là nơi ảnh đích học từ câu lệnh và ảnh mẫu. Một luồng duy nhất (Single-Stream) với cùng bộ trọng số cho chữ và ảnh giúp kiến trúc gọn và khiến Prefix KV Cache ở 6A trở nên tự nhiên. QK-RMSNorm và cổng tanh(gate1) giữ số học ổn định qua 32 lớp.
- Đầu vào
- Chuỗi ghép [B, S, 4096] từ 2A, cùng 3 thứ đã chuẩn bị sẵn: góc xoay RoPE (3A), hệ số scale1/gate1 (3B) và mặt nạ (3C).
- Đầu ra
- Chuỗi cùng kích thước [B, S, 4096] mà mỗi token đã nhận thêm thông tin từ các token khác, cộng vào residual qua x + tanh(gate1) · W_O(attn). Kết quả đi tiếp sang FFN 5A trong cùng lớp; cặp 4A → 5A lặp lại 32 lần.
Ở nửa trên Cột 3, khác với kiến trúc Double-Stream phải tách 2 nhánh trọng số riêng cho chữ và ảnh, Qwen-Image-2.1 đưa toàn bộ chuỗi ghép qua 32 lớp Single-Stream đồng nhất. Tại mỗi lớp, trạng thái ẩn được điều biến LayerNorm(x) · (1 + scale1), chiếu ra Q, K, V (32 head × 128 chiều), chuẩn hóa biên độ từng head bằng norm_q / norm_k (RMSNorm), xoay góc 3D RoPE rồi tính Attention và cộng vào luồng chính qua cổng kẹp x + tanh(gate1) · W_O(attn).
- 4A · Chuẩn hóa có tín hiệu t
img_norm1(x) × (1 + scale1), với scale1 sinh từ modulation dùng chung ở bài 5.
- 4A · QKV, QK-RMSNorm và RoPE 3D
Chiếu QKV không bias, chuẩn hóa từng đầu 128 chiều, xoay theo bảng tọa độ ba trục của bài 4.
- 4A · SDPA và cổng tanh residual
SDPA tính theo mặt nạ bài 6, to_out về 4096, cộng lại x + tanh(gate1) × attn_output rồi sang FFN bài 5A.
Mã Mermaid
flowchart TD
  step1["4A · Chuẩn hóa có tín hiệu t"]
  step2["4A · QKV, QK-RMSNorm và RoPE 3D"]
  step3["4A · SDPA và cổng tanh residual"]
  step1 --> step2
step2 --> step33Giải pháp
Bài toán cần giải: trộn chữ và ảnh trong attention duy nhất, ổn định các phép tính với Q, K vector 128 chiều và RoPE ba trục, trong khi giữ cổng residual kiểm soát được. Sau bài này, bạn cần tự kể được: chuỗi bước trong một khối, vì sao Q và K được chuẩn hóa, và cổng tanh làm gì.
Trạng thái đầu vào: hidden 4096 chiều của chuỗi đồng nhất, mặt nạ từ bài 6, tọa độ RoPE từ bài 4, và 4 vùng điệu biến từ bài 5 (mọi khối đọc cùng một bộ). Không có thêm trọng số ở từng khối cho phần điệu biến.
Các thao tác và lý do: (1) chuẩn hóa theo (1 + scale1) trước attention, để độ lớn token thay đổi theo t một cách học được; (2) chiếu QKV không bias — bỏ bias giúp biểu diễn phẳng hơn và vẫn đủ, vì chuẩn hóa trước đã cố định tâm; (3) QK-RMSNorm từng đầu để softmax không phụ thuộc độ lớn tuyệt đối của Q, K; (4) RoPE ba trục cho khoảng cách không gian; (5) SDPA với mặt nạ rồi to_out gộp các đầu về 4096; (6) residual x + tanh(gate1) × attn_output trước khi sang FFN ở bài 5A.
Đầu ra và cách đọc: hidden 4096 chiều mới cùng shape với đầu vào; phần góp của attention vào residual được ghi qua cổng tanh(gate1). Khi đọc bước 4A của lab, hãy so output giữa hai lượt chạy với hai mức σ khác nhau: phần ảnh đích thay đổi theo t, còn phần prefix (t = 0) giữ tính chất ổn định như bài 3B đã ghi.
Giới hạn: 32 × 128 = 4096 phải khớp inner_dim; cấu hình khác sẽ lệch phép chiếu; QK-RMSNorm chỉ hoạt động trên 128 chiều của từng đầu và không thay thế giai đoạn chuẩn hóa đầu khối; mặt nạ áp trước softmax trong SDPA, sau đó không thể hiệu chỉnh riêng từng đầu.
4Profiling
- Parity attention ở chuỗi nhỏ
Trong bước 4A của lab, so output SDPA với một phiên bản attention tự tính tay cho chuỗi rất nhỏ (ví dụ 4 token, một đầu): đi từng phép nhân và softmax; chọn ngưỡng chênh lệch theo quá trình số học của runtime (FP16 sẽ chênh nhẹ hơn FP32). Đây là kiểm tra tính đúng, chưa phải đo tốc độ.
- Kích thước tensor attention
Số chiều sau chiếu phải 32 × 128 = 4096 cho Q, K, V của mỗi token; lab in shape cho chuỗi hiện hành. Nếu shape khác, kiểm tra số heads hoặc attention_head_dim của cấu hình trước tiên.
- Giá trị gate1 theo bước
In tanh(gate1) ở bước 1 và bước 8 của 2.1 tại các lần chạy thực tế trong lab: giá trị nằm trong khoảng mở (−1, 1). Không suy ra mức 'mở' tuyệt đối của các model khác từ số này; mỗi checkpoint học mức riêng.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Đếm phép nhân của to_q
Input: một token có 4096 số đi qua to_q là Linear(4096, 4096, không bias). Hãy dự đoán số phép nhân của lớp này cho một token. Kết quả: 4096 × 4096 = 16.777.216 phép nhân cho mỗi token. Cả to_q, to_k, to_v, to_out đều là 16.777.216 tham số, tổng 4 lớp ≈ 67.1 triệu tham số cho phần attention của một khối. Tự kiểm tra: nhân với 32 khối cho phần attention của cả mô hình; hãy đếm song song với phần FFN ở bài 5A khi lập bảng tham số. Cách quan sát: bước 4A của [Bài Lab tổng hợp Qwen-Image-2.1](/courses/qwen-image-2-1/qwen21-lab/qwen21-end-to-end-lab/) in shape và số tham số của khối.
Tác dụng QK-RMSNorm trên vector nhỏ
Input: Q của một token-head là [2, 0] (2 chiều minh họa). Dự đoán: sau QK-RMSNorm vector lớn hơn hay nhỏ hơn? Kết quả: trung bình bình phương = (4 + 0)/2 = 2; căn 2 gần 1.4142; nghịch đảo của nó gần 0.7071; nhân từng phần tử với 1/1.4142 cho [1.4142, 0] sau chuẩn hóa. Tự kiểm tra: Q = [1, 1] cho ra [0.7071, 0.7071] — hai vector có độ lớn khác nhau cùng chuẩn hóa về độ lớn 1, nên softmax không còn lệch theo độ lớn. Giới hạn: trong lab thật, mỗi vector có 128 chiều và phép xoay RoPE áp ngay sau đó.
6Thuật ngữ
- Single-stream
- Thiết kế một dòng hidden duy nhất chứa cả token chữ và token ảnh đi qua cùng 32 khối, thay cho hai dòng riêng cho từng loại.
- QwenImage21Transformer2DModel
- Khối transformer ảnh của Qwen-Image-2.1: 32 lớp single-stream, 7B tham số visual, inner_dim = 4096.
- img_norm1(x) × (1 + scale1)
- Chuẩn hóa đầu khối rồi nhân (1 + scale1) theo tín hiệu t: scale1 đến từ modulation ở bài 5.
- to_q, to_k, to_v (không bias)
- Ba lớp Linear không bias chuyển 4096 số thành 32 đầu × 128 chiều (num_attention_heads = 32, attention_head_dim = 128).
- QK-RMSNorm (norm_q, norm_k)
- Chuẩn hóa RMS trên 128 chiều của riêng từng vector Q và K theo từng token, cho softmax ổn định trước khi xoay RoPE.
Glossary (4)
- Head (đầu attention)
- Nhóm 128 chiều của Q, K, V; 32 đầu chạy song song rồi ghép lại, mỗi đầu học một 'góc nhìn' riêng.
- SDPA
- Scaled Dot Product Attention: lấy Q nhân K theo từng đầu, chia hệ số chuẩn, áp mặt nạ, softmax rồi nhân V.
- Residual
- Đường cộng trực tiếp x qua nhánh: kết quả nhánh nhân cổng rồi cộng thêm x gốc, giữ luồng thông tin gốc.
- apply_rotary_emb_qwen
- Hàm áp phép xoay RoPE ba trục lên Q và K của từng đầu trước softmax.