Giới thiệu khóa học
Qwen-Image-2.1: ảnh được tạo ra từ nhiễu như thế nào, và mỗi khối kiến trúc làm gì
Qwen-Image-2.1 là mô hình tạo và chỉnh sửa ảnh theo câu lệnh. Bạn viết yêu cầu bằng chữ, có thể kèm tối đa 10 ảnh tham chiếu, và mô hình trả về một ảnh RGBA (ảnh có thêm kênh Alpha ghi độ trong suốt của từng điểm ảnh).
Mô hình không vẽ từng điểm ảnh. Nó bắt đầu từ nhiễu ngẫu nhiên rồi khử nhiễu dần qua 8 bước (bản Turbo): ở mỗi bước, một mạng DiT (Diffusion Transformer, Transformer chuyên khử nhiễu) 7 tỷ tham số với 32 lớp dự đoán hướng nhích để ảnh gần hơn với ảnh sạch. Mạng này xử lý token, tức các vector (dãy số) đại diện cho từng mẩu chữ hoặc từng ô của ảnh. Học kiến trúc này giúp bạn thấy một mô hình ảnh mượn ý tưởng của mô hình ngôn ngữ, kể cả bộ nhớ đệm KV, để tránh tính lại những phần không đổi.
Khóa học gồm
- Nén và ghép dữ liệu (1A, 1B, 2A): VAE nén ảnh thành latent (lưới đặc trưng nhỏ gọn), Qwen3-VL (mô hình hiểu cả chữ lẫn ảnh) đọc câu lệnh, rồi chữ và ảnh được xếp thành một chuỗi token chung.
- Ba thứ chuẩn bị cho attention, bước mà mỗi token nhìn các token khác để lấy thông tin (3A, 3B, 3C): 3D RoPE gắn vị trí cho từng token bằng phép xoay, điều biến theo mức nhiễu t, và mặt nạ Block-Causal quy định token nào được nhìn token nào.
- Lõi DiT 32 lớp (4A, 5A): attention trên một luồng dùng chung cho chữ và ảnh, rồi mạng SwiGLU xử lý riêng từng token.
- Prefix KV Cache (6A): vì sao phần câu lệnh chỉ cần tính một lần ở bước khử nhiễu đầu tiên rồi dùng lại ở các bước sau.
- Vòng khử nhiễu Euler 8 bước và giải mã ra ảnh RGBA (6B).
- Một bài lab NumPy tổng hợp (Tab 02) chạy cả 10 khối ở kích thước thu nhỏ và in từng bảng số.
Học xong, bạn có thể
- Kể lại đường đi từ câu lệnh, ảnh tham chiếu và nhiễu đến ảnh RGBA, và chỉ ra từng chặng trên sơ đồ.
- Giải thích vì sao một slot ảnh của Qwen3-VL (một vector tóm tắt một vùng ảnh) được giãn thành 4 token (lưới 2×2) trong khối 2A.
- Giải thích vì sao phần Prefix (chữ và ảnh tham chiếu, đứng trước ảnh đích) phải giữ ở t = 0 và không được nhìn ảnh đích, hai điều kiện để dùng lại bộ nhớ đệm KV.
- Đọc công thức cập nhật Euler x_{k+1} = x_k + (σ_{k+1} − σ_k) · v_θ và nói được σ, v_θ là gì.
- Phân biệt bước khử nhiễu đầu (tính cả Prefix và lưu cache) với các bước sau (chỉ tính ảnh đích).
Phạm vi: khóa học chỉ dạy kiến trúc và đường suy luận (forward: đưa nhiễu qua mạng nhiều bước để ra ảnh) của Qwen-Image-2.1, không dạy cách huấn luyện; trọng số chỉ được nhắc đến như những con số mô hình học được khi huấn luyện, và bài lab dùng trọng số ngẫu nhiên chưa huấn luyện. Muốn học huấn luyện, hãy xem khóa LLM Training (Text), nhưng khóa đó chỉ dạy mô hình văn bản; huấn luyện mô hình tạo ảnh từ nhiễu (diffusion) chưa được dạy ở bất kỳ khóa nào trên site.
Cách đọc sơ đồ kiến trúc
- Bắt đầu ở 1A, góc dưới của Cột 1, rồi đi lên theo mũi tên: 1A (nén ảnh) → 1B (đọc câu lệnh) → 2A (ghép chuỗi). Mũi tên chỉ thứ tự đọc: ảnh (1A) và chữ (1B) thật ra là hai đầu vào độc lập, cùng đổ vào 2A.
- Sang Cột 2 và đọc từ trên xuống: 3A (vị trí) → 3B (mức nhiễu) → 3C (mặt nạ). Ba khối này không đổi chuỗi token mà chuẩn bị đồ nghề cho khối 4A ở Cột 3, nơi cả ba được dùng.
- Ở Cột 3, 4A (attention) nằm trên và 6A (Prefix KV Cache) nằm dưới; mũi tên Store và Load giữa chúng là lưu K/V của Prefix ở bước đầu rồi nạp lại ở các bước sau.
- Cột 4 đọc từ dưới lên: 5A (SwiGLU) → 6B (đầu ra). Cặp 4A rồi 5A lặp lại 32 lần, mỗi lần một lớp; sau lớp thứ 32 token ảnh đi lên 6B, và ảnh đang nặn quay lại 2A cho bước khử nhiễu tiếp theo.
- Rê chuột vào một khung để mở pop-over nêu mục đích, đầu vào và đầu ra của khối; bấm để mở bài học. Các nút Trọng tâm (Step 1, Steps 2..8, RGBA và 3D RoPE, Block-Causal và t=0) làm nổi các khối liên quan; nút −, + và Vừa khung điều chỉnh cỡ ảnh.
- Nút Tắt overlay cạnh Vừa khung ẩn các khung vuông và pop-over để bạn đọc ảnh kiến trúc gốc; bấm lại để bật overlay.
Ký hiệu như [B, S, 4096] liệt kê các trục của tensor: B là số mẫu chạy cùng lúc, S là số token trong chuỗi và 4096 là số chiều của vector mô tả mỗi token.
Cột 1 & Cột 2 (1A → 3C) · RGBA VAE, Ghép chuỗi 4×, 3D RoPE & Block-Causal
Cột 3 & Cột 4 (4A → 6B) · Single-Stream DiT, Prefix KV Cache & 8-Step Euler
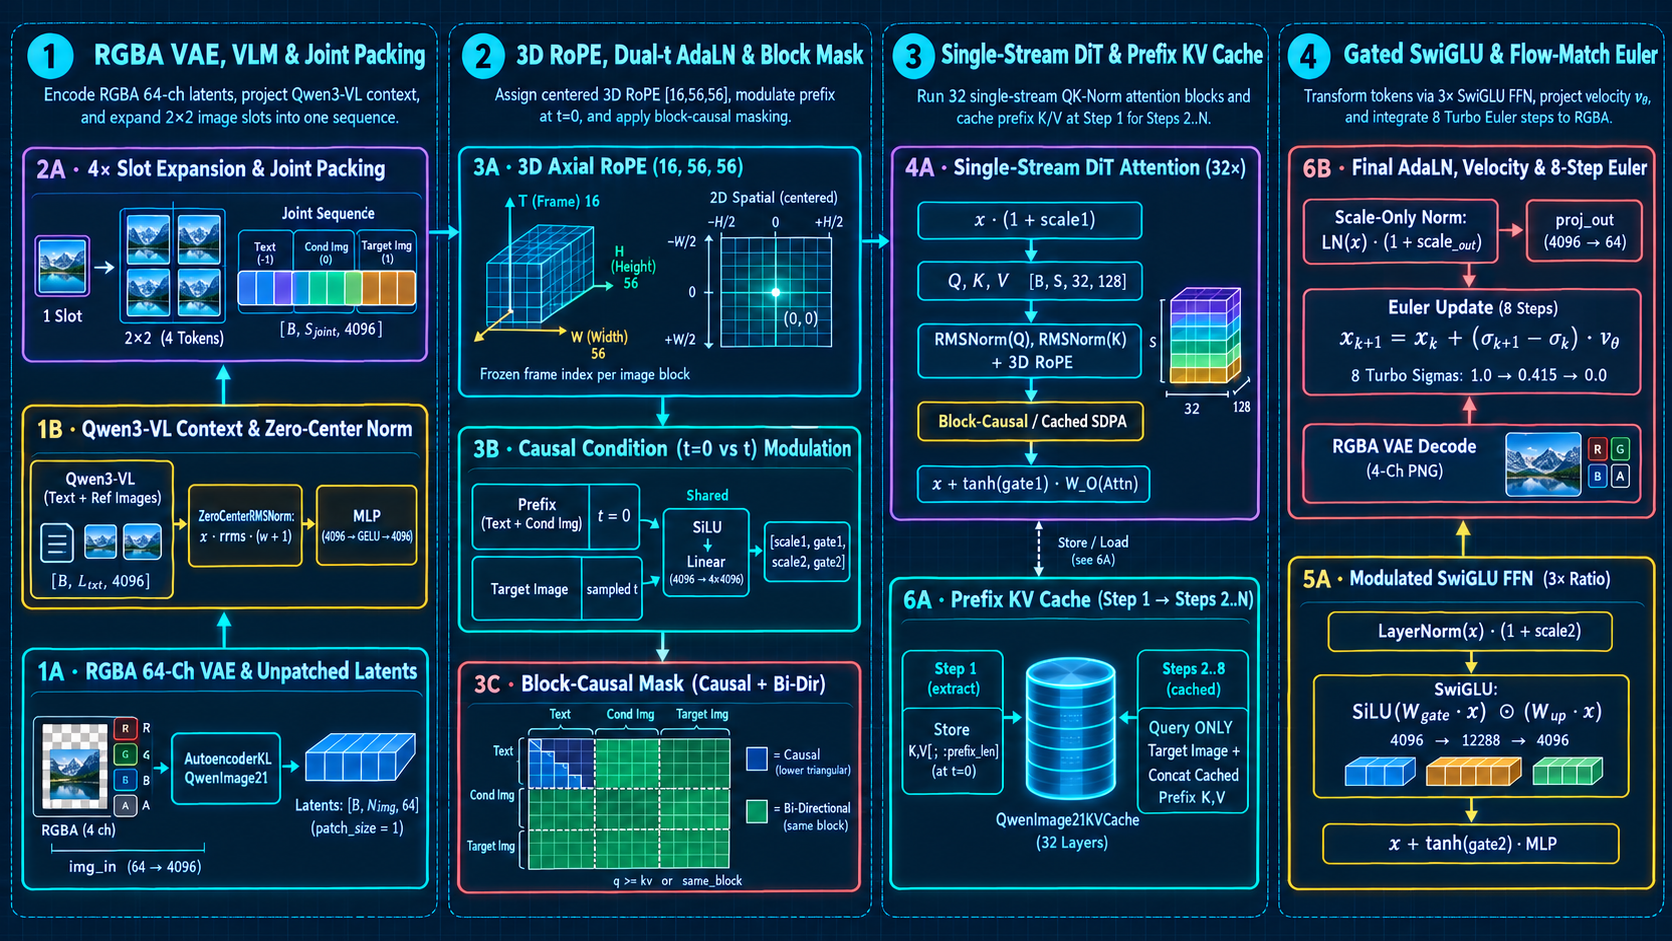
Cách đọc sơ đồ 4 cột dọc (Dataflow Graph)
Bắt đầu ở Cột 1 từ đáy đi lên (1A chuẩn hóa RGBA latent → 1B ngữ cảnh Qwen3-VL → 2A nhân bản 4× slot ảnh thành chuỗi ghép); sang Cột 2 từ đỉnh đi xuống (3A 3D RoPE → 3B điều biến t=0 → 3C mặt nạ Block-Causal); sang Cột 3 tại 4A (32 lớp Single-Stream DiT nối với Prefix KV Cache 6A ở dưới); và kết thúc ở Cột 4 từ 5A đi lên 6B (tích phân Euler ra ảnh RGBA).
Thực hành toàn trình trong một bài Lab duy nhất (Tab 02)
Toàn bộ 10 bài học ở Tab 01 hội tụ về đúng 1 bài Lab NumPy chạy trực tiếp trong trình duyệt ở Tab 02, kiểm chứng tận mắt việc tái sử dụng Prefix KV Cache qua các bước Euler với sai số 10⁻¹⁶. Mở Tab 02 · Bài Lab tổng hợp ↗
Nguồn công bố & mã nguồn tham chiếu
Danh sách bài học (10)
- 1A · RGBA 64-Channel VAE & Unpatched Latents · Mã hóa ảnh trong suốt 4 kênh
- 1B · Qwen3-VL Context & Zero-Center RMSNorm · Mã hóa ngữ cảnh đa tham chiếu
- 2A · Mở rộng 4× Slot ảnh & Ghép chuỗi đồng nhất (Joint Sequence Packing)
- 3A · 3D Axial RoPE (16, 56, 56) & Lưới tọa độ tâm không (Zero-Centered Grid)
- 3B · Điều kiện nhân quả (t=0 vs t) & Bộ điều biến dùng chung (Shared Modulation)
- 3C · Mặt nạ Block-Causal · Nhân quả trên chữ và hai chiều trong từng khối ảnh
- 4A · Single-Stream DiT Attention (32 lớp) & Chuẩn hóa QK-RMSNorm
- 5A · Mạng SwiGLU có điều biến (3× Ratio) & Cổng Residual Tanh
- 6A · Prefix KV Cache qua các bước khử nhiễu (Extract Step 1 → Cached Steps 2..N)
- 6B · Scale-Only Final AdaLN, Dự đoán vận tốc v_θ & Vòng lặp 8-Step Euler