TI · Thực hành huấn luyện sinh ảnh
Bài Lab tổng hợp: học vận tốc từ nhiễu tới ảnh hình học
Chạy vòng flow matching NumPy từ ảnh 4×4 tới EMA và sampling, kiểm tra gradient, nhánh CFG rỗng và LoRA bằng các giá trị được tính thật.
1Định nghĩa
Bài lab này là một thí nghiệm NumPy tự chứa để quan sát một mô hình sinh ảnh thu nhỏ học trường vận tốc từ nhiễu tới dữ liệu. Nó nối dữ liệu, dự đoán, MSE, backward và AdamW thành một vòng, rồi lấy bản trọng số cố định ra sinh ảnh hình học.
Dữ liệu gồm nét ngang/dọc 4×4, bảng nhãn cố định và MLP 1.744 tham số thay DiT. Đường flow cung cấp target, CFG cần nhánh rỗng được học, LoRA đổi một miền nét dày bằng hai ma trận nhỏ. Mỗi khối output nêu quan sát và giới hạn của phép kiểm tra.
Ví dụ đời thường: Xưởng vẽ hai hình đơn giản cho người học thấy giấy, phiếu yêu cầu, thao tác sửa và bức tranh cuối nối nhau ra sao. Xưởng nhỏ giúp kiểm tra mỗi bước, nhưng hoàn thành hai mẫu không đồng nghĩa đã biết vẽ cảnh hay chân dung.
2Luồng
10 giai đoạn lab ánh xạ 24 ô; phần chưa thực thi có nhãn rõ. Giai đoạn 10 không là một lần huấn luyện các phương pháp nâng cao.
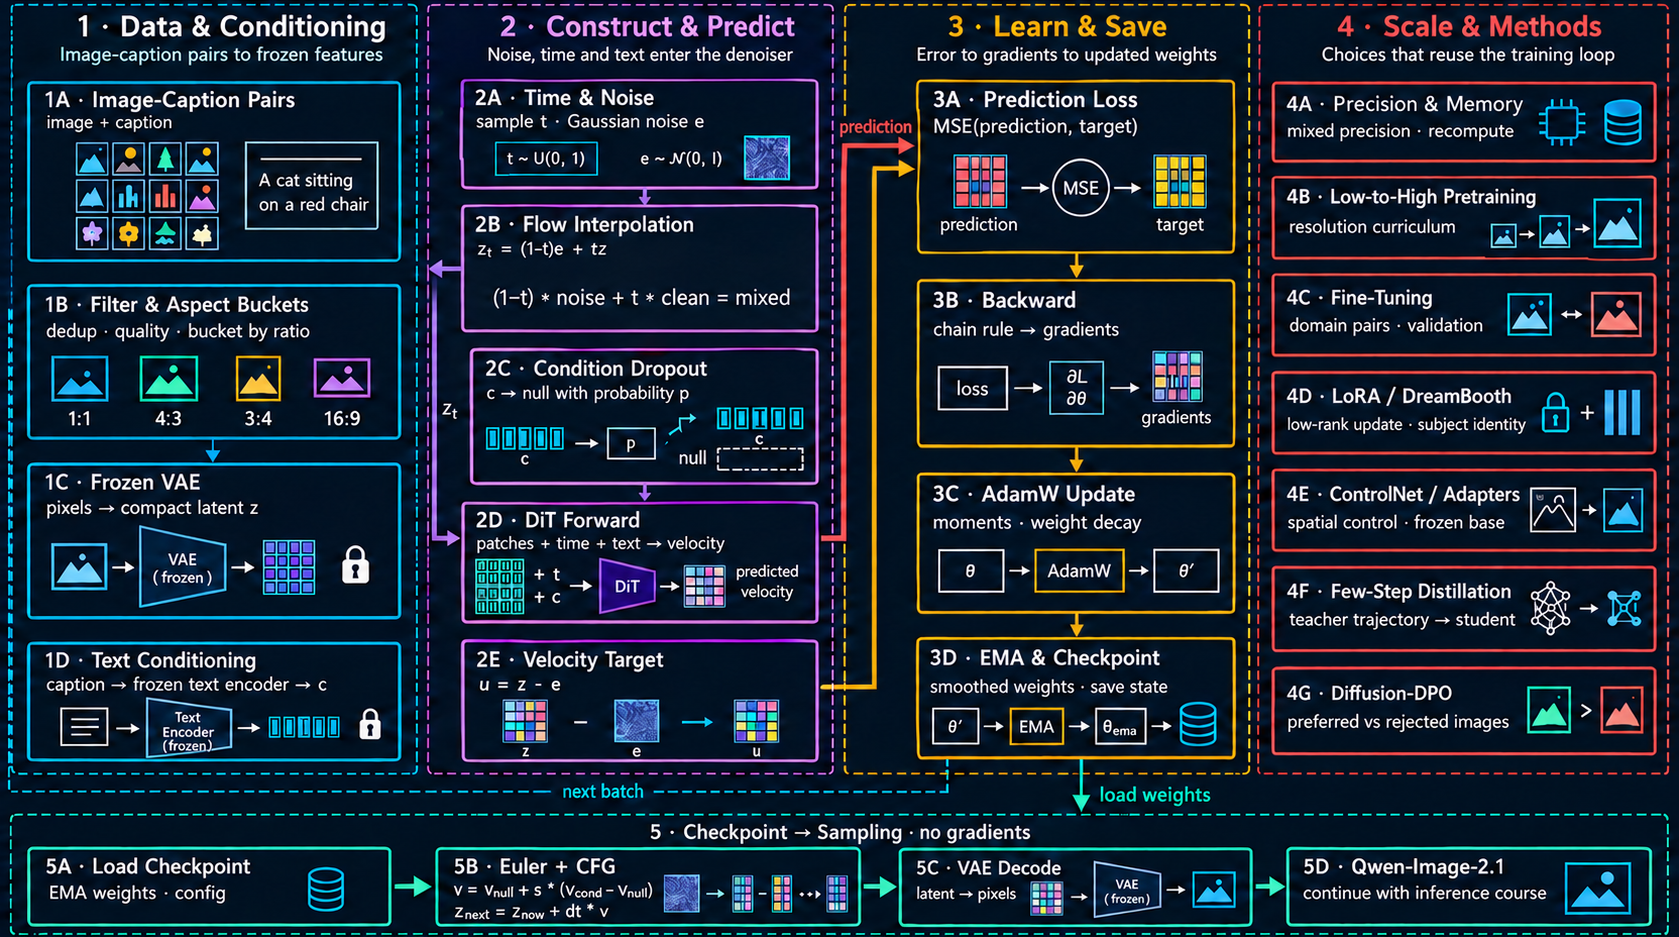
ảnh + mô tả → một cặp dữ liệu1A · Cặp ảnh–chú thích
Điểm bắt đầu: nối đúng ảnh với mô tả để học quan hệ giữa chữ và nội dung ảnh.
- Nhận gì
- Ảnh và chú thích mô tả nội dung cần sinh, trước khi tạo nhiễu.
- Làm gì, vì sao
- Giữ định danh và nguồn của từng cặp; kiểm tra chữ còn đúng với ảnh để tránh dạy quan hệ sai.
- Ra gì
- Cặp dữ liệu đi tới 1B để lọc, chia kiểm định và ghép batch.
- Ví dụ, cách đọc ô
- Một ảnh nét ngang đi cùng nhãn ngang; tráo nhãn dọc làm sai bài toán dù ảnh không hỏng.
- Lưu ý
- Lab chỉ có ảnh hình học tự tạo; không chứng minh độ phủ dữ liệu ảnh tự nhiên.
- Tạo đề và target
Ảnh sạch + nhiễu + t + điều kiện, target là z−e.
- Học denoiser
Forward, MSE, gradient và AdamW, theo dõi EMA.
- Lấy mẫu
Nạp bản sao EMA, Euler và CFG rồi đọc lưới 4×4.
Mã Mermaid
flowchart TD
  step1["Tạo đề và target"]
  step2["Học denoiser"]
  step3["Lấy mẫu"]
  step1 --> step2
step2 --> step33Giải pháp
Chuẩn bị và dự đoán
Tiền đề là tensor/attention từ Foundations và loss–gradient–AdamW từ Training (Text). Nhắc lại: loss là điểm phạt, gradient là độ nhạy, optimizer chọn mức sửa. Mở Tab 02 hoặc chạy file với Python có NumPy; trên máy tác giả dùng /usr/bin/python3 public/labs/llm-training-image/training-image-end-to-end.py.
Dự đoán t=0 và t=1 cho ảnh nào, dấu của u=z−e khi z nhỏ hơn e, và việc bỏ điều kiện có thay target không. Sau đó chạy nguyên cấu hình, đọc Quan sát trước, giải thích bằng Kết luận rồi đọc Không chứng minh.
Đọc từ ảnh sang trọng số mới
Khối 1–2 tương ứng 1A–1D và 2A/2B/2E nhưng VAE/encoder chỉ là phép thay thế. Khối 3 dùng MLP nhận 19 số, trả 16 vận tốc; khối 4 lấy MSE; khối 5 kiểm tra bốn phần tử gradient rồi cập nhật AdamW. Hai đầu nội suy lệch 0 và gradient khớp dưới 1e−7 là điều kiện đúng số học trước khi học dài.
Khối 6 chạy 1.800 bước, so kiểm định cố định trước/sau và giữ EMA. Khối 7 học thêm đối chứng p=0 với cùng khởi tạo/batch; khối 8 học adapter LoRA cho nét dày. Tách dữ liệu và trọng số từng nhánh để không lẫn kết quả thích nghi với checkpoint dùng lấy mẫu ở khối 9.
Đọc trọng số sang ảnh và giới hạn
Khối 9 dùng bản sao EMA từ khối 6, không dùng LoRA nét dày, để sinh hai nét mảnh. Cùng nhiễu được dùng khi so CFG và số bước; số thô ngoài [−1,1] vẫn được in để không giấu sai số. Khối 10 chỉ đếm byte trọng số, không là phép đo hiệu năng hay đầy đủ footprint huấn luyện.
Mở các bài tập bên dưới, đổi một hằng số rồi tự đối chiếu. Các đáp án đến từ những lần chạy biến thể thực tế; các chữ số cuối có thể khác giữa NumPy native và trình duyệt. Các kỹ thuật chưa thực thi được nêu ngay trong bảng và output để bạn không dùng kết quả lab thay thí nghiệm thật.
4Profiling
- Đúng số học và điều kiện so sánh
Kiểm tra hai đầu đường, sai phân gradient, finite output và gộp LoRA trước khi đọc loss. So cùng validation triples và ghi seed/cấu hình; bản output mẫu chỉ để đọc số, không thay điều kiện assertion.
- Chi phí và phạm vi
Lab không đo GPU hay thời gian. Byte trọng số float64 là 13.952, chưa có activation/gradient/AdamW. Chỉ có hai kiểu nét và một seed; cần nhiều dữ liệu/seed với đánh giá ảnh độc lập trước khi kết luận chất lượng tổng quát.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Tự kiểm tra khác biệt hai loss
Vì sao raw kiểm định 0,239795 không bằng minibatch cuối 0,242463? Vì một số đo tập cố định 128 cặp, một số đo batch học mới. Hãy giữ đúng ảnh–nhiễu–t khi so trước/sau.
Đọc một ảnh
Trong ma trận ngang, tìm hàng thứ hai gần +1; ở ma trận dọc tìm cột thứ hai gần +1. Các vị trí còn lại gần −1. Nếu chỉ thấy PASS mà không giải thích được vị trí nét sáng, hãy quay lại khối 1 và công thức Euler ở khối 9.
6Thuật ngữ
- MLP
- Mạng truyền thẳng, ở lab một lớp tanh giữa hai phép chiếu; không có attention.
- EMA
- Bản trọng số trung bình trượt theo thời gian học, tách khỏi optimizer.
- Null condition
- [0,0] trong lab; nhánh dùng khi không cung cấp nhãn lớp.
Glossary (1)
- MSE
- Tổng bình phương sai số chia số tọa độ được chấm.
7Bài liên quan
8Nguồn
9Bài lab
Huấn luyện trường vận tốc sinh ảnh hình học bằng NumPy
NumPy · mô hình thu nhỏDự đoán hai đầu nội suy, chạy nguyên cấu hình rồi đọc Quan sát / Kết luận / Không chứng minh của từng khối. Đổi một hằng số mỗi lần và đối chiếu bài tập.
1 · Mục tiêu và kiến thức cần dùng
Bạn cần tensor/attention từ LLM Foundations và loss, gradient, AdamW từ LLM Training (Text). Nhắc lại: MSE trung bình bình phương sai số; backward áp quy tắc chuỗi; AdamW dùng m,v để chọn bước sửa. Ở đây ta thêm đường từ nhiễu tới ảnh, EMA và nhánh rỗng cho CFG.
Sau bài, hãy giải thích một mẫu đi từ ảnh sạch và nhiễu tới target vận tốc, loss, gradient, trọng số mới rồi lấy mẫu ra ảnh. Dự đoán trước khi chạy để tách hiểu cơ chế khỏi việc nhìn dòng PASS.
2 · Đầu vào và cấu hình
Ảnh 4×4 có nền −1 và một hàng hoặc cột sáng +1, cộng nhiễu nhỏ độ lệch chuẩn 0,03. Nhãn ngang/dọc thành [1,0]/[0,1]; [0,0] là rỗng. Một hàng dữ liệu có 16 pixel, đầu vào mạng ghép thêm một t và hai điều kiện, tổng 19 số.
MLP tanh 19→48→16 có 1.744 tham số. SEED=17, STEPS=1800, LR=0.003, BATCH=64, DROP_PROB=0.2, EMA_DECAY=0.98; LoRA hạng 2 học thêm 450 bước, sampler 8 bước với CFG_SCALE=1.5. Không tải thư viện ngoài NumPy hoặc truy cập mạng.
VAE được thay bằng ánh xạ đồng nhất và reshape, text encoder bằng bảng tra nhãn, DiT bằng MLP. Không có attention hay encoder hiểu ngôn ngữ được học. Những phép thay thế này giúp tự tính mọi gradient chứ không tái tạo kiến trúc Qwen.
3 · Theo luồng dữ liệu và các khối
Khối 1 tạo cặp ảnh/nhãn, khối 2 rút t và nhiễu e rồi tính z_t=(1−t)e+t·z và target u=z−e. Khóa quy định t=0 là nhiễu, t=1 là sạch; kiểm tra hai đầu trước khi nhìn loss.
Khối 3–5 tính forward, MSE và gradient viết tay, so bốn phần tử với sai phân ±1e−5 rồi thử một bước AdamW. Khối 6 học dài, đo trên 128 cặp ảnh–nhiễu–t cố định và tạo bản EMA trong RAM; khối 7 so dropout với đối chứng cùng batch.
Khối 8 đóng băng denoiser EMA, chỉ học A,B ở W2 để vẽ nét dày và kiểm tra gộp. Khối 9 nạp bản sao EMA, chạy Euler/CFG từ nhiễu mới và in hai ma trận. Khối 10 chỉ đếm byte, nhắc rõ kỹ thuật chưa triển khai. Bảng Tab 02 liệt kê coverage từng nhóm ô.
4 · Cách đọc kết quả thật
MSE trước/sau của cùng tập kiểm định là 2,098029 → 0,239795; EMA là 0,238390. Loss minibatch ở bước 900 là 0,220923 và bước 1800 là 0,242463, nhưng hai batch khác nhau nên không kết luận mô hình xấu đi từ cặp số ấy.
Dropout thực tế 22.946/115.200 lượt mẫu, gần p=0,2; MSE null 0,312712 so với 1,691582 khi p=0. Đây là quan sát trên một seed, đủ thấy nhánh rỗng có cơ hội học, chưa tìm p tối ưu.
LoRA 128 tham số giảm loss miền nét dày 3,201654 → 0,275528, giữ nền lệch 0 và gộp lệch cỡ 3e−15. Euler 8 bước với s=1,5 cho MSE hình mẫu 0,017335; s=1 cho 0,017168. Scale lớn hơn không tự làm lỗi nhỏ hơn.
5 · Kết luận và điều chưa chứng minh
PASS kiểm tra hai đầu nội suy, bốn phần tử gradient lệch dưới 1e−7, loss kiểm định giảm, copy EMA nạp lại đúng, LoRA giữ nền/gộp lệch dưới 1e−12 và giảm loss, sampler trả giá trị hữu hạn. Nó không so output từng chữ số với file mẫu.
Lab không đo tốc độ, peak GPU, thẩm mỹ, đa dạng ảnh tự nhiên hoặc hiểu tiếng Việt. Không triển khai VAE/DiT thật, aspect buckets, mixed precision/recompute, curriculum resolution, DreamBooth, ControlNet, student distillation hay Diffusion-DPO. Sampler ít bước vẫn dùng checkpoint chưa chưng cất.
Ảnh kiểm định mới vẫn chỉ từ hai kiểu nét đã định, nên đây là kiểm định số học trong phân phối nhỏ. Khả năng sinh cảnh, bố cục nhiều vật thể và cá nhân hóa trên ảnh thật cần thí nghiệm khác.
Kết quả mong đợiMốc mặc định: 1.744 tham số, MSE kiểm định 2,098029 → 0,239795; EMA 0,238390; LoRA 128 tham số, gốc không đổi; cuối output có PASS nêu đúng các assertion. Các chữ số cuối có thể lệch theo môi trường NumPy.
Tải training-image-end-to-end.py ↓
Bài tập 1 · Giảm số bước học
Dự đoán kiểm định cuối sẽ cao hay thấp hơn khi sửa STEPS=300 thay vì 1800, giữ phần còn lại. Chạy lại và phân biệt MSE kiểm định với loss minibatch cuối.
Đối chiếu sau khi tự trả lời
Lần chạy biến thể cho MSE kiểm định 0,364621, cao hơn 0,239795 mặc định; EMA 0,364829. Loss minibatch cuối 0,278246 đo batch khác. Với ít lần cập nhật hơn, mạng chưa khớp bài toán bằng cấu hình mặc định; không suy ra cứ học lâu là luôn tốt.
Bài tập 2 · Không học nhánh rỗng
Sửa DROP_PROB=0.0. Dự đoán số null và MSE null của mô hình chính so với đối chứng p=0; sau đó đọc CFG scale=1,5 trong khối 9.
Đối chiếu sau khi tự trả lời
Số null bằng 0; MSE null cả hai là 1,691582 vì hai lần học lúc này cùng cấu hình. MSE hình mẫu khi s=1,5 là 0,156528, so với 0,017335 mặc định; s=1 vẫn 0,025766. Null chưa được học làm hiệu có/rỗng thiếu tin cậy, nhưng đây chỉ là một seed. Không dùng scalar kiểm định toàn bộ để che lỗi nhánh rỗng.
Bài tập 3 · LoRA hạng 1
Trả cấu hình mặc định rồi sửa LORA_RANK=1. Tính trước số tham số từ r·(48+16), dự đoán khả năng học hai kiểu nét dày và chạy.
Đối chiếu sau khi tự trả lời
64 tham số, thay vì 128 ở hạng 2. Lần chạy hạng 1 cho MSE thích nghi 1,330747 so với 0,275528 mặc định. Nền vẫn lệch 0 và gộp khớp cỡ 1e−15; số tham số ít hơn là thật, nhưng chất lượng không ngang nhau trên dữ liệu này.
Bài tập 4 · Hai bước Euler
Trả cấu hình mặc định rồi sửa SAMPLE_STEPS=2. Trước khi chạy, dự đoán cả MSE tới hình mẫu và RMS so bản 64 bước. Kiểm tra xem ít bước có tự là distillation không.
Đối chiếu sau khi tự trả lời
MSE hình mẫu 0,003630 thấp hơn 0,017335 của 8 bước, nhưng RMS so bản 64 bước tăng từ 0,024457 lên 0,139368. Hai tiêu chí đo hai thứ: gần hình mẫu so với gần nghiệm tham chiếu của trường đã học. Hai mẫu không đủ kết luận 2 bước tốt hơn nói chung; không có student được học nên chưa phải distillation.